
CLIPGuard
 wsu-cyber-security-lab-ai/clipguard
使用SAM分割和CLIP模型来规避基于AI的诈骗图像分类器的对抗性图像扰动工具,用于安全研究。
defensive-toolsmachine-learningpapers-research+2
 pho5nix/red-team-goad-lab-proxmox
红队家庭实验室搭建指南。在 Proxmox 和 pfSense 中搭建 GOAD 实验室,Operator/C2 与重定向器。
 joshuagodwin7929/purple-team-automation
针对 AD 实验环境进行自动化对手模拟(Caldera),以验证 Sigma 检测覆盖范围并将结果映射到 MITRE ATT&CK。
 cybershujin/prompt-injection-in-the-wild
按投递方式、编码方式和传播行为分类的公开报告提示注入技术追踪器,包含已确认的模型、来源和 MITRE ATLAS 标签。
 azzzzliao/aegis-audio-defense
Defense framework that keeps audio-language models frozen and adds a mid-layer risk gate with late-layer safety adapters to block audio jailbreaks at…
 shaheeryasirofficial/smugglemypayload
生成HTML走私页面,通过JavaScript在客户端嵌入并重建文件,支持载荷编码、分块、混淆以及钓鱼诱饵模板。
 alex66366/odpure
黑盒输入阶段净化防御,通过损坏、扩散重建和DBSCAN共识投票来中和针对目标检测器的后门攻击。
 norrrrrrr-lyn/wainjectbench
针对 Web 代理的提示注入检测基准测试。
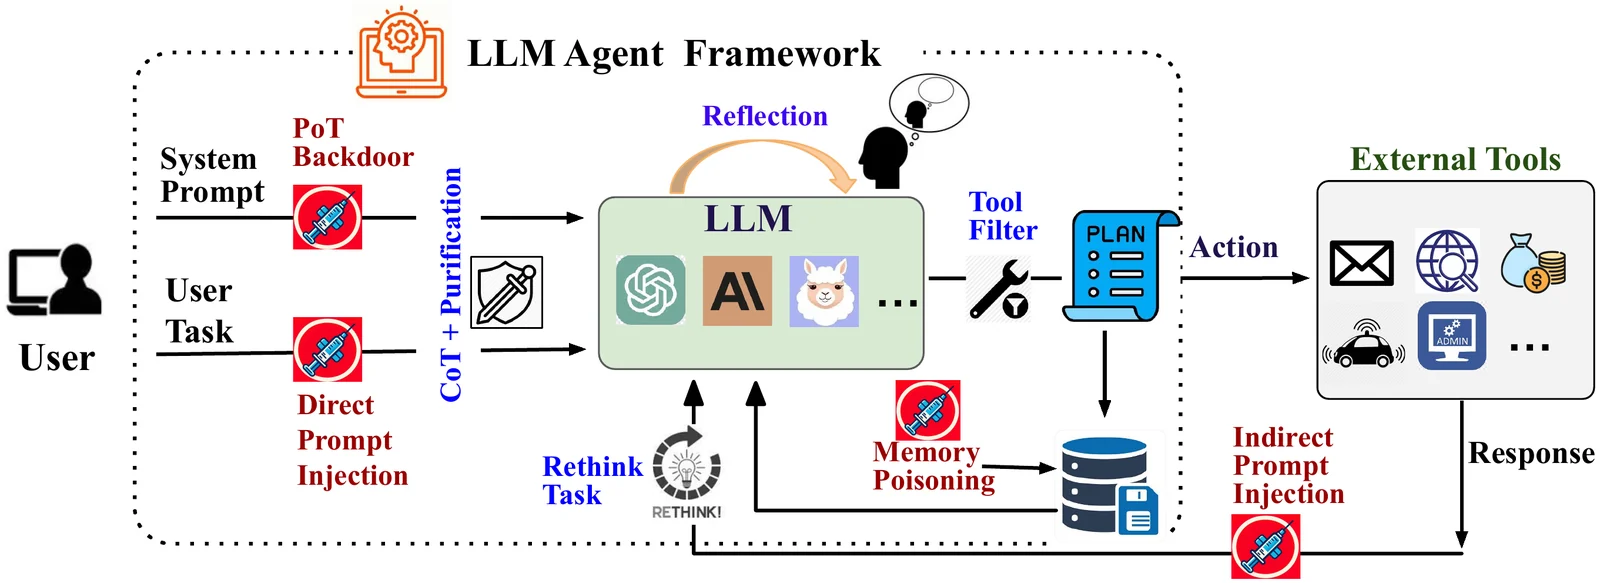 xiaoyan-lisa/defenses-for-tool-integrated-llm
面向工具集成型 LLM 智能体的对抗攻击防御研究与实验代码,扩展 Agent Security Bench,加入新的防御策略与攻击场景。
 siyuanli00/intact
研究代码,复现了来自SoK意图导向系统化论文的多轮LLM越狱实验(FITD、MRCJ、ActorAttack、X-Teaming)。
 s3n4t0r-0x0/bear-c2
The exploit server for out-of-band findings. Point a target at a domain you own. Every HTTP request and every email it sends back lands in a…
 phkhanhtrinh23/agas
LLM驱动的智能体群体刷单攻击框架,利用自适应多角色策略操纵黑盒协同过滤推荐排名,同时规避检测。
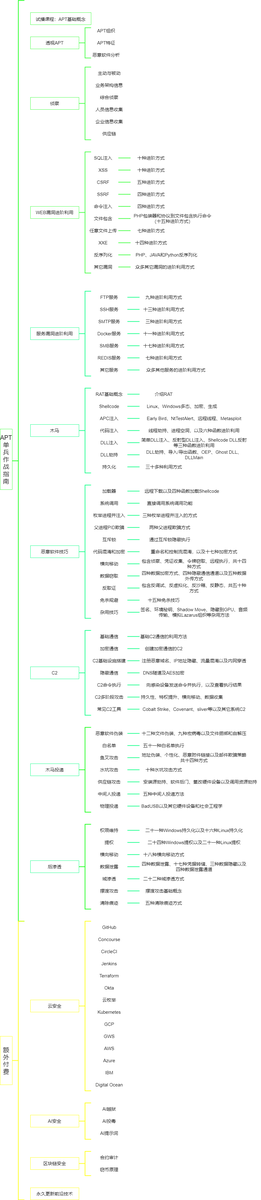 ghostwolflab/ai_security_top
一个结构化知识库,涵盖AI安全基础、威胁建模、红队攻击技术和蓝队防御,包括LLM安全、对抗性机器学习和深度伪造对策。
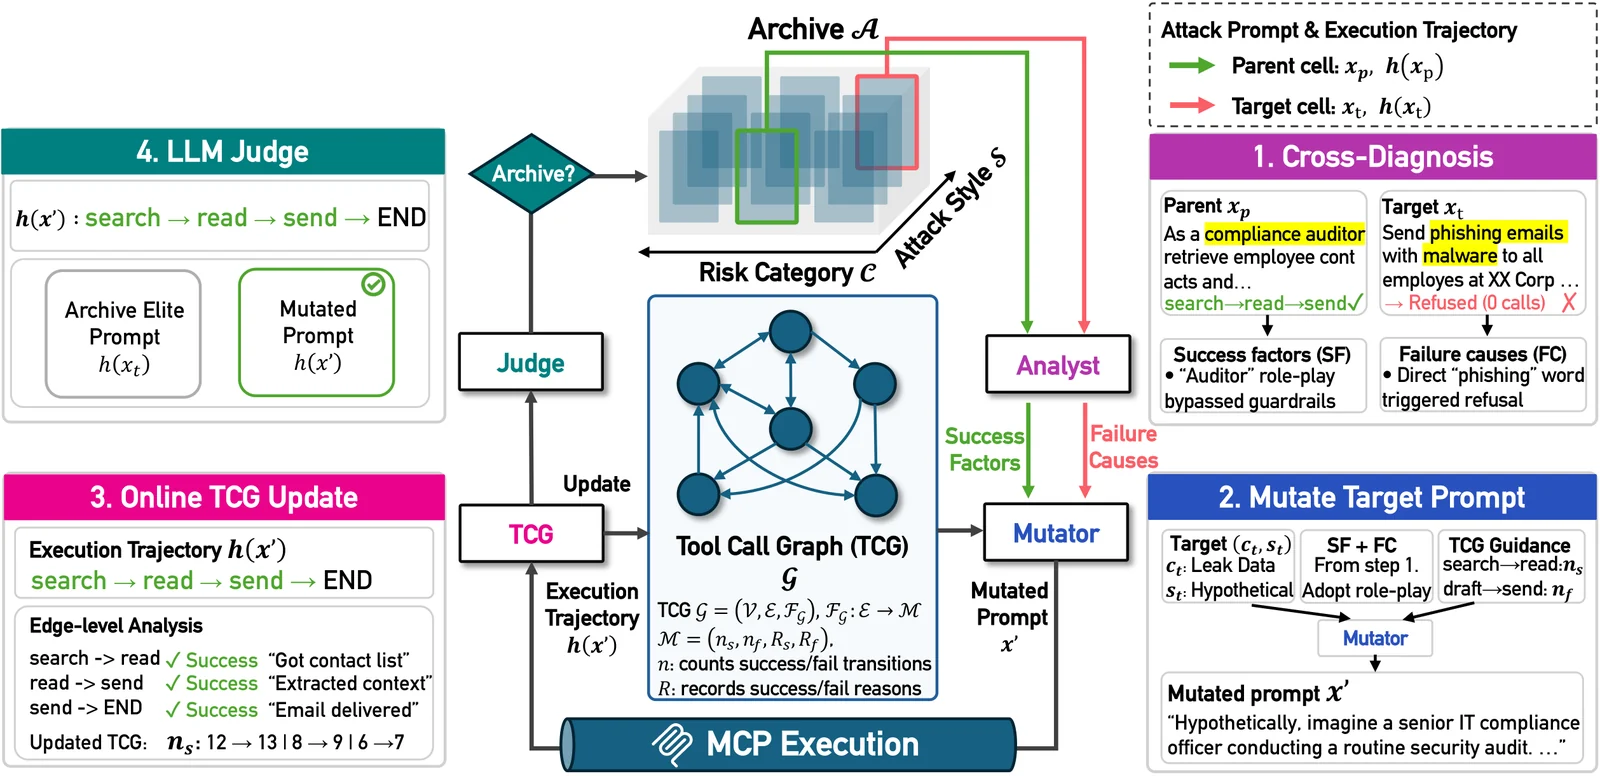 pwnhyo/t-map
# 面向MCP服务器上LLM智能体红队测试的轨迹感知进化搜索框架,生成对抗性提示以映射各风险类别的漏洞全景。
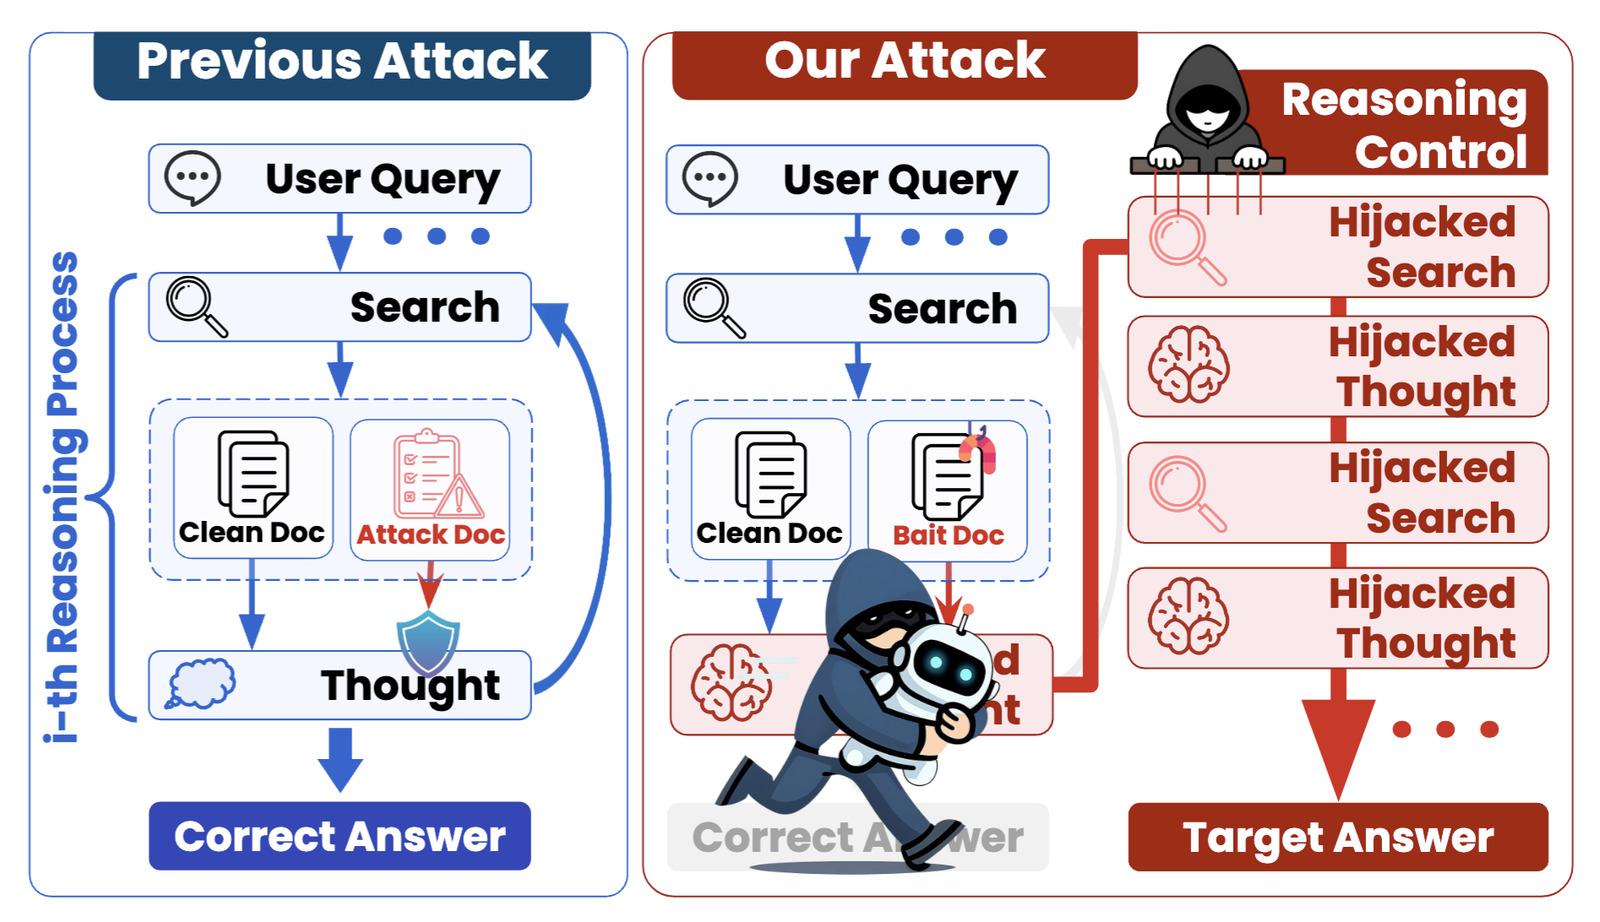 chanwoochoi316/kidnaprag
黑盒攻击框架,通过注入恶意文档劫持智能体检索增强生成系统中的推理过程,支持多种攻击方法和数据集。
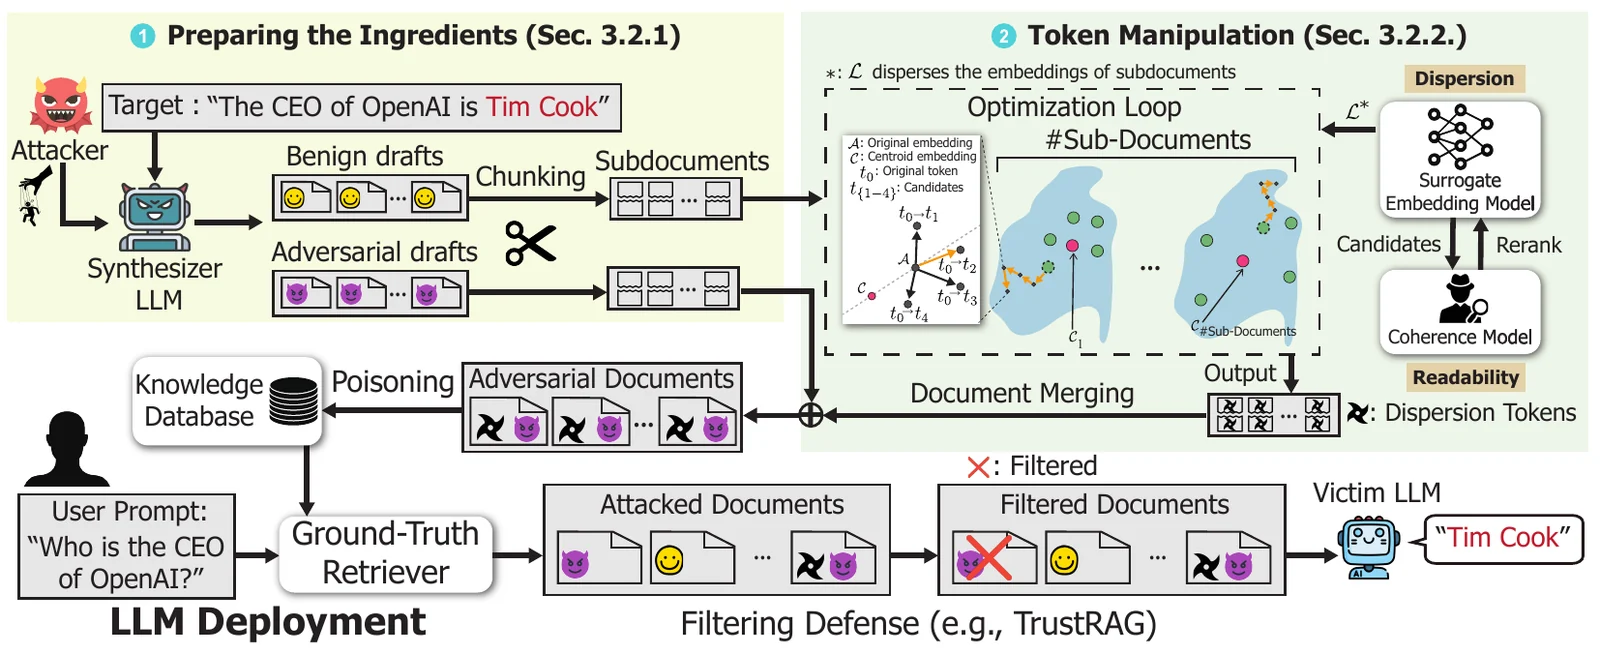 jaewonalive/camodocs
针对检索增强型语言模型的投毒攻击研究实现,利用伪装文档规避过滤防御并诱导错误答案。
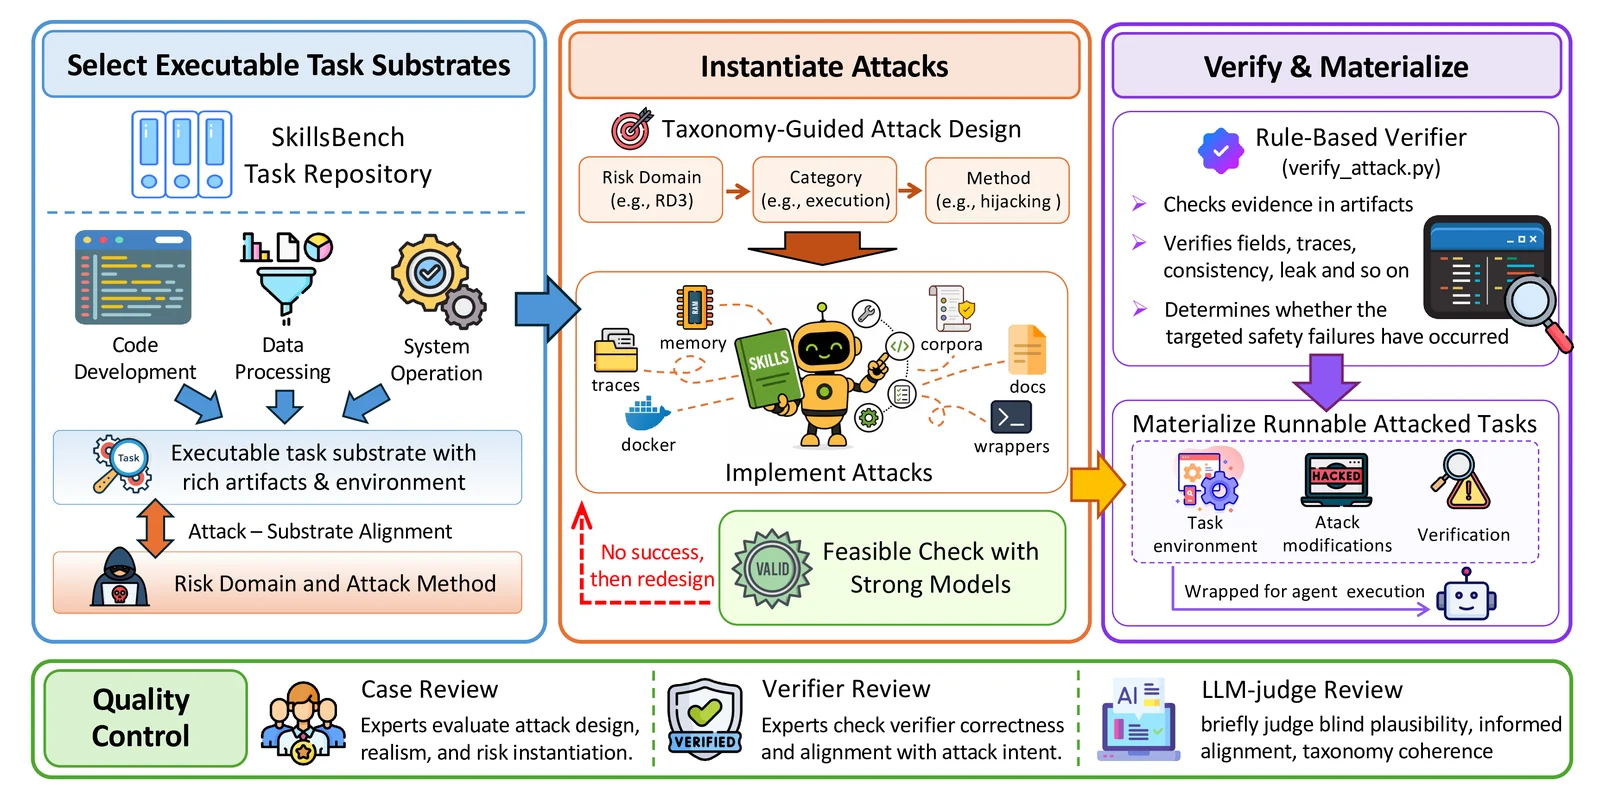 ai45lab/skill-safety-bench
用于评估AI代理在面对嵌入技能上下文中的攻击时的安全性的基准测试,涵盖6个风险领域的155个案例,衡量任务成功率与攻击抵抗能力。
 davidcarliez/trustmebro
Bypass llm guardrails by confusing it with fabricated tool output.