

benign-instruction-bench
 lzwhehe/benign-instruction-bench
LLM 에이전트 도구 출력에 대한 프롬프트 인젝션 탐지기 재평가 (논문 초안, 스크립트, 점수)
defensive-toolsvulnerability-analysismachine-learning+3
lzwhehe/benign-instruction-benchLLM 에이전트 도구 출력에 대한 프롬프트 인젝션 탐지기 재평가 (논문 초안, 스크립트, 점수)
 hoodoer/colonelclustered
서버 응답의 실제 내용을 기반으로, 예를 들어 Intruder 실행에서 나온 응답에 대해 텍스트 클러스터링을 수행하여 이상치/그룹을 식별하는 Java Burp 플러그인입니다.
 rbidou/pyrasp
Python 웹 서버, 서버리스 함수 및 MCP 서버를 위한 런타임 애플리케이션 자기 방어로, 시그니처 없이 공격, 프롬프트 인젝션 및 데이터 유출을 탐지합니다.
 euph00/zoneclaw-code
OpenClaw 스타일 컴퓨터 사용 에이전트에 대한 지속적 메모리 공격을 위한 벤치마크 및 방어 코드로, 메모리 구역화 완화, 공격 시나리오, 평가 스크립트를 포함합니다.
 sliu11-byte/mea-bench
블랙박스 LLM 추출 공격, 방어 및 적응형 공격을 위한 수명 주기 벤치마크입니다.
 js-lee-ai/refusal-relocates
Refusal localizes, the damage relocates, safety layers under few-sample fine-tuning
 liuz233/harde
HARDE를 위한 연구 코드로, 에이전트 안전성 벤치마크 전반에서 런타임 위험 탐지 및 실행 제어를 위해 구성 요소를 탐침하고 적응적으로 최적화하는 에이전트 하네스입니다.
 kevinchunye/prompt_injection
도구를 사용하는 LLM 에이전트 파이프라인에서 프롬프트 인젝션 방어가 어느 지점에서 작동하는지 측정하고, 노출·지속·릴레이·실행 단계 전반에 걸쳐 카나리 토큰을 추적하는 벤치마크 하네스.
 joshuaprovoste/deserializer
AI, LLM, 로보틱스, 데이터 과학, 머신 러닝 및 딥 러닝(이에 국한되지 않음) 분야에서 Python RCE 경로와 심층 역직렬화 체인을 발견하기 위한 에이전틱 LLM 기반 관계 매핑을 갖춘 AST 기반 정적 코드 분석기.
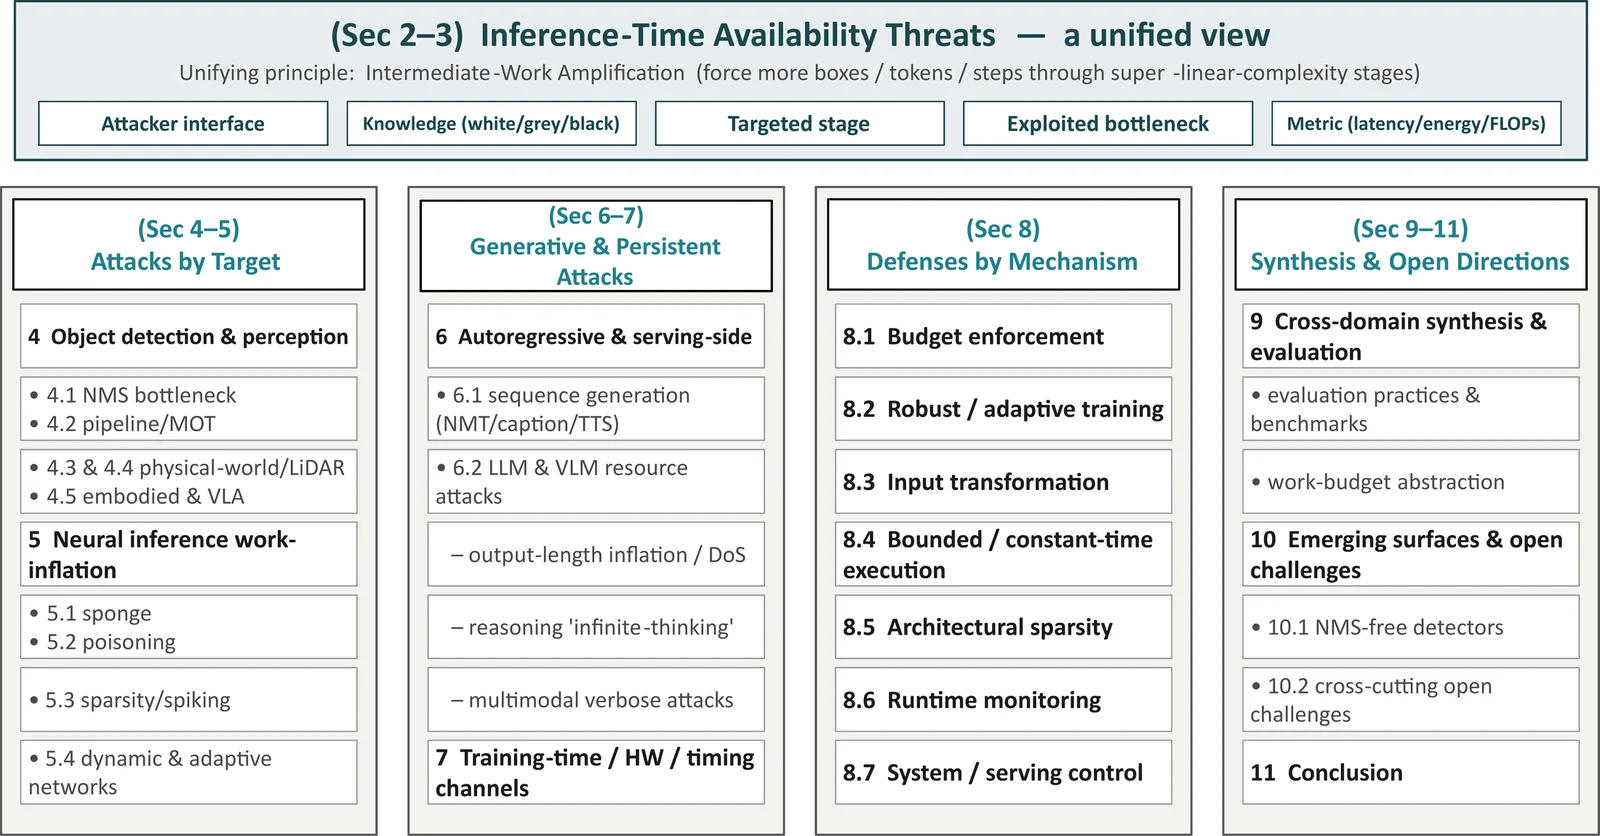 guzonghua/awesome-latency-attacks
딥러닝 지연, 에너지-지연 및 타이밍(가용성) 공격과 방어에 대한 선별된 색인 — ACM Computing Surveys 제출 논문의 부속 자료.
 facebookresearch/meta_secalign
프롬프트 인젝션 공격에 대응하기 위한 오픈 웨이트 LLM과 학습/평가 코드, 그리고 에이전트 도구 호출 및 명령 수행 보안을 위한 벤치마크.
 kaill-jlq/mmskillrisk
멀티모달 스킬 이미지에 숨겨진 악성 지시에 LLM 에이전트가 저항하는지 테스트하는 벤치마크 및 평가 하네스로, 5개 위험 범주에 걸친 108개 사례와 ASR/TSR 점수를 제공합니다.
 zju-llm-safety/trace
Agentic jailbreak framework for LLM-based agents using scheme-based task decomposition, multi-turn disguising strategies, and adaptive self-evolution…
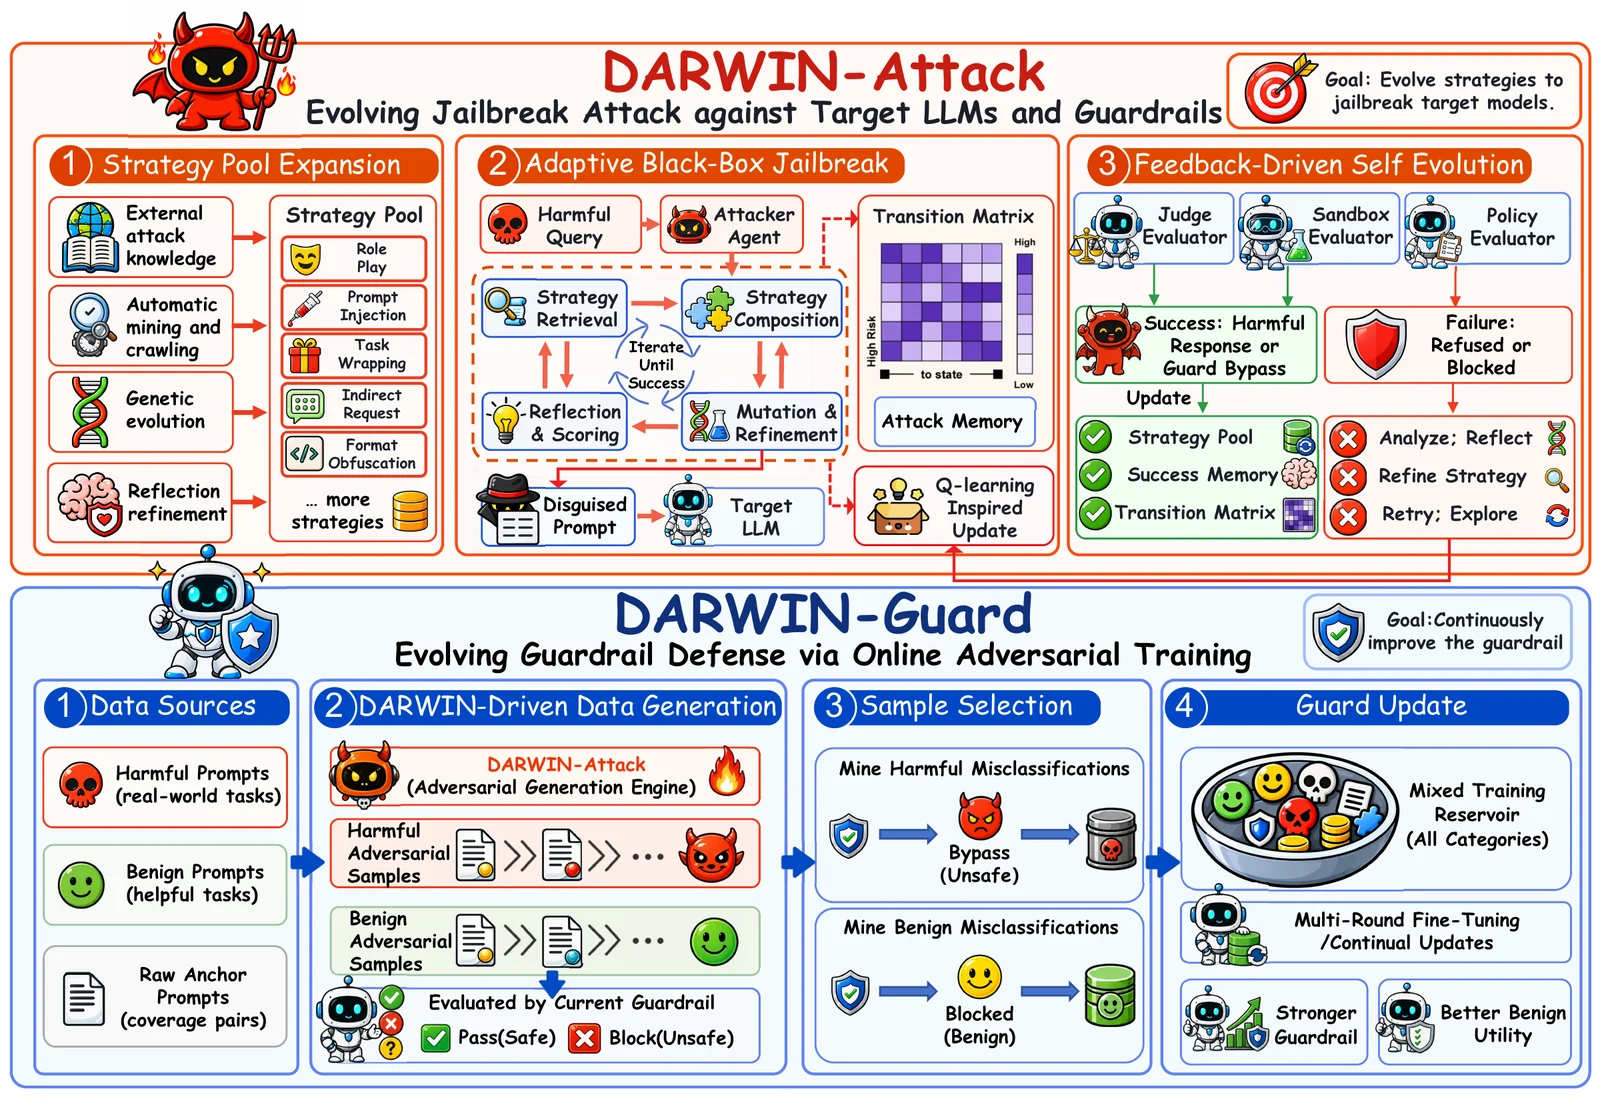 zju-llm-safety/darwin
진화적 LLM 탈옥 및 가드레일 프레임워크로, 유전적 변이, 마르코프 선택, 온라인 적대적 훈련을 통해 재사용 가능한 전략 풀을 성장시켜 안전성 평가를 수행합니다.
 albert-y1n/piforge
RL 기반 프롬프트 인젝션 레드팀을 위한 오픈 프레임워크로, 공유 트레이너, 커리큘럼 학습, 그리고 AgentDojo, InjecAgent, PIArena와 같은 벤치마크를 제공합니다.
 123wwwa/flowname
Next-generation JavaScript identifier recovery with LLMs.
 wsu-cyber-security-lab-ai/clipguard
SAM 세그멘테이션과 CLIP 모델을 사용하여 AI 기반 사기 이미지 분류기를 회피하는 적대적 이미지 교란 도구로, 보안 연구용입니다.
 azzzzliao/aegis-audio-defense
Defense framework that keeps audio-language models frozen and adds a mid-layer risk gate with late-layer safety adapters to block audio jailbreaks at…