js-lee-ai/refusal-relocates
LLM 안전성: 파인튜닝이 거부 행동을 어떻게 변화시키는지 분석하고, 레이어 동결 및 저랭크 방어 기법을 평가합니다.

수십 개의 유해한 예시만으로도 정렬된 모델의 유해 요청 거부 능력을 제거할 수 있습니다. 선행 연구는 안전성을 특정 계층과 방향으로 국소화하며, 이는 발견된 위치를 보호하라는 것을 시사합니다. 이 저장소는 적응형 공격자가 할 방식으로 그 전제를 검증합니다. 거부가 복구될 수 있는 위치를 찾아 그 영역을 동결한 뒤 다시 공격하고, 가중치 업데이트를 복구한 다음 공격자가 그것을 확산시키도록 합니다.
이 연구는 세 가지 측정에 기반합니다.
이 저장소는 측정과 두 가지 방어를 작은 라이브러리로 제공하며, 논문의 표를 재구성하는 실행 기록과 스크립트도 포함합니다.
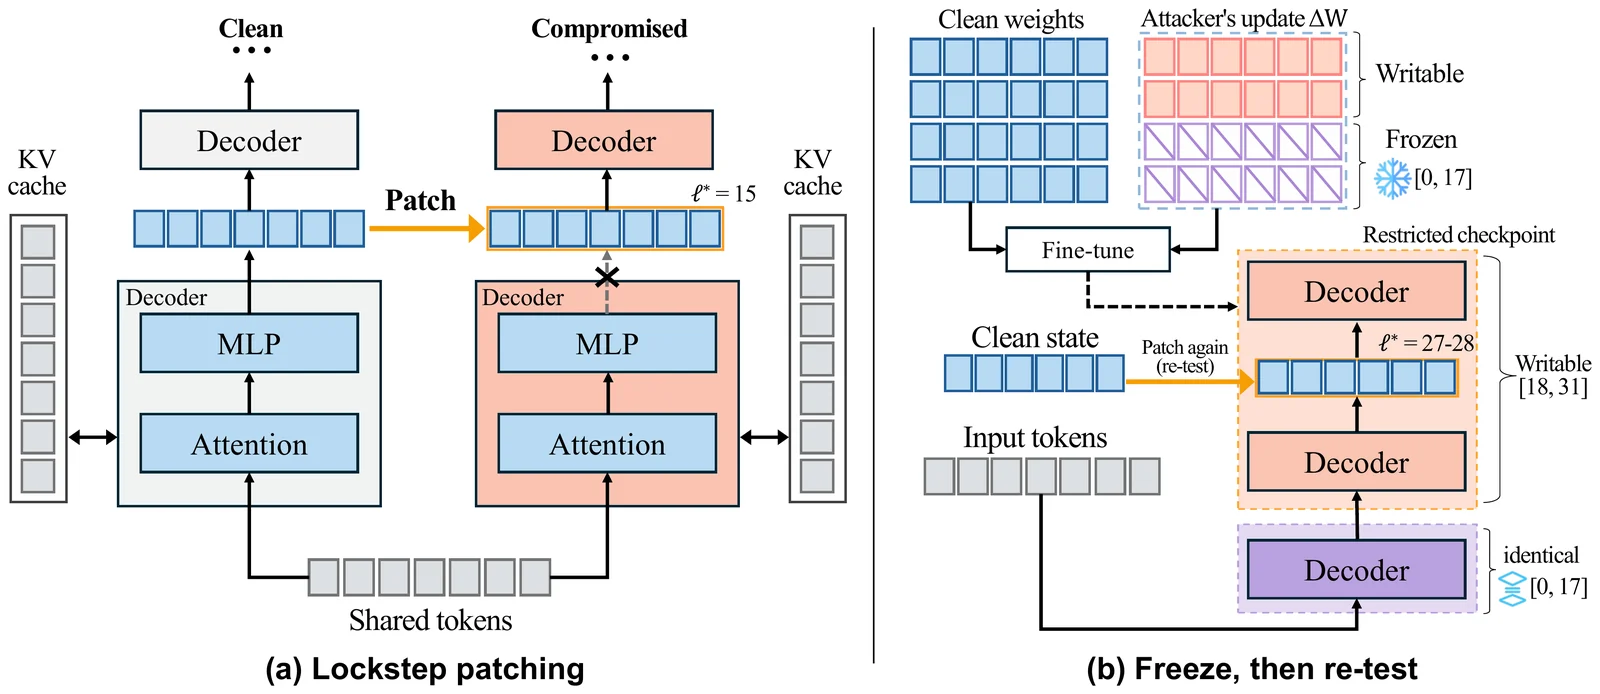
(a) Lockstep 활성화 패칭은 프리필과 각 디코딩 단계에서 손상된 모델의 계층 출력을 깨끗한 상태로 덮어쓴다. (b) 일치된 Llama 공격에서 계층 0–17을 동결하면 반-천장 전이가 15에서 27–28로 이동한다.
pip install "git+https://github.com/js-lee-AI/refusal-relocates.git"
import numpy as np
import refusal

rng = np.random.default_rng(0)
A = rng.standard_normal((16, 512)) / 512 ** 0.5    # LoRA factors of one module, rank 16
B = rng.standard_normal((512, 16)) / 16 ** 0.5
for name, decay in [("ordinary", 0.5), ("spread", 1.0)]:
    b = B * decay ** np.arange(16)                  # energy in a few directions, or spread flat
    before, after = refusal.update_stats(A, b), refusal.update_stats(*refusal.remove_top_k(A, b, k=2))
    print(f"{name:8s}  PR/r {before['pr_over_r']:.2f}  top-2 energy {before['top2_energy_fraction']:.2f}"
          f"  norm left after top-2 removal {after['unscaled_norm'] / before['unscaled_norm']:.2f}")
# ordinary  PR/r 0.10  top-2 energy 0.94  norm left after top-2 removal 0.24
# spread    PR/r 0.94  top-2 energy 0.18  norm left after top-2 removal 0.90
일반적인 파인튜닝은 업데이트의 대부분을 소수의 특이 방향에 집어넣기 때문에, 상위 두 개를 제거하면 그 대부분이 사라진다. 분산된 업데이트는 평탄한 스펙트럼을 가지므로, 동일한 제거를 수행해도 대부분이 그대로 남는다. LoRA 랭크에 대한 참여율인 PR/r은 논문의 스펙트럼 탐지기의 점수이기도 하다.
이는 CPU에서 약 1초 만에 실행되며 아무것도 다운로드하지 않는다. 동일한 코드는 examples/quickstart.py에 있으며, CI는 매 push마다 이를 실행한다.
실제 체크포인트를 학습, 패치, 평가하려면 models 추가 기능을 설치한다.
pip install "refusal-relocates[models] @ git+https://github.com/js-lee-AI/refusal-relocates.git"
| 설치 | 추가되는 항목 | 다음에 충분함 |
|---|---|---|
pip install "git+https://github.com/js-lee-AI/refusal-relocates.git" | numpy | 스펙트럼 코어, top-k 제거, 탐지기, 거부 스코어러, refusal 명령 |
pip install "refusal-relocates[models] @ git+https://github.com/js-lee-AI/refusal-relocates.git" | torch, transformers, peft, accelerate, safetensors, scikit-learn, datasets | 모델에 대한 학습, lockstep 패칭, 프로브 및 평가 |
git clone 후 pip install -e ".[models,test]" | pytest | experiments/, records/ 및 tests/ |
Python 3.11.5, PyTorch 2.10.0, Transformers 4.57.3 및 PEFT 0.18.0에서 테스트되었습니다. 모델은 CUDA 장치에서 bfloat16으로 로드됩니다.
import refusal

data = refusal.load_data("data/prompt_sets.json")        # built by `refusal prepare`, see below
prompts = data["advbench"][:40]
clean, tokenizer = refusal.load_model("meta-llama/Llama-3.1-8B-Instruct")
attacked, _ = refusal.load_model("meta-llama/Llama-3.1-8B-Instruct", adapter="runs/attack/adapter")

for layer in [6, 9, 12, 15, 18]:
    responses = refusal.lockstep_generate(clean, attacked, tokenizer, prompts, layer=layer)
    print(layer, sum(refusal.is_refusal(r) for r in responses) / len(prompts))
두 모델은 동일한 토큰을 읽으며, 선택된 레이어에서 손상된 모델의 출력이 깨끗한 모델의 출력으로 대체됩니다. refusal patch는 하한, 상한 및 두 개의 대조군과 함께 전체 측정을 실행하고, 퍼플렉시티 게이트와 Llama-Guard로 일관된 거부를 채점하며, 전환 깊이를 보고합니다.
import refusal

stats = refusal.update_stats(A, B)                 # one module, A is rank x in and B is out x rank
A2, B2 = refusal.remove_top_k(A, B, k=2)           # the top-two repair, as new LoRA factors
result = refusal.calibrate_detector(benign_scores, attack_scores, budget=0.05)
어댑터의 탐지기 점수는 해당 어텐션 프로젝션들에 대해 평균한 PR/r이며, refusal spectra는 저장된 어댑터로부터 이를 CPU에서 계산한다.
| 호출 | 수행하는 작업 | 필요 사항 |
|---|---|---|
refusal.update_stats(A, B) | 하나의 LoRA 업데이트에 대한 참여율, PR/r, 상위 2개 에너지 및 노름 | 기본 설치 |
refusal.remove_top_k(A, B, k) | 가장 큰 k개의 특이 방향을 제거한 업데이트의 인자 | 기본 설치 |
refusal.calibrate_detector(benign, attacks, budget) | 정상 오탐 예산에서의 임계값, 그리고 그것이 표시하는 공격들 | 기본 설치 |
refusal.is_refusal(text), refusal.summarize(...) | 명시적 거부 패턴, 퍼플렉시티 게이트를 통과한 일관된 거부 | 기본 설치 |
refusal.transition_depth(rows, ceiling, floor, rescaled=True) | 최소 절반 범위 회복을 보이는 첫 번째 패치된 레이어 | 기본 설치 |
refusal.prepare(...), refusal.load_data(path) | 공개 데이터로부터 고정된 프롬프트 세트를 재구성하고 검증 | 기본 설치 |
refusal.load_model(name, adapter=...) | bfloat16 체크포인트, 선택적으로 LoRA 어댑터 포함 | [models] |
refusal.lockstep_generate(clean, attacked, tokenizer, prompts, layer) | 한 레이어에 클린 상태를 패치한 상태에서의 그리디 디코딩 | [models] |
refusal.add_adapter(model, freeze="bottom", n_frozen=18) | 쓰기 가능한 레이어에만 적용된 LoRA | [models] |
refusal.remove_top(model, k), refusal.adapter_stats(path) | 로드되었거나 저장된 어댑터에 대한 top-k 복구 및 스펙트럼 통계 | [models] |
기본 설치로 표시된 호출은 torch 없이 임포트된다. 무거운 모듈은 해당 이름이 처음 사용될 때 로드된다.
패키지를 설치하면 refusal 명령이 추가되며, python -m refusal은 동일한 작업을 실행한다.
refusal --help
refusal demo                                                    # the quickstart, on CPU
refusal prepare --pku ... --alpaca ... --advbench ... --xstest ...   # rebuild the frozen prompt sets
refusal train --freeze bottom --n-frozen 18 --out runs/freeze   # LoRA attack with layers 0 to 17 frozen
refusal patch --adapter runs/freeze/adapter --out runs/freeze/patch     # lockstep patching
refusal evaluate --adapter runs/freeze/adapter --ranks 1,2,4 --out runs/freeze/evaluate
refusal spectra --adapter runs/freeze/adapter --out spectrum.json        # on CPU
refusal detector --benign benign/*.json --attacks attacks/*.json --out detector.json