

benign-instruction-bench
 lzwhehe/benign-instruction-bench
LLMエージェントのツール出力に対するプロンプトインジェクション検出器の再評価(論文ドラフト、スクリプト、スコア)
defensive-toolsvulnerability-analysismachine-learning+3
lzwhehe/benign-instruction-benchLLMエージェントのツール出力に対するプロンプトインジェクション検出器の再評価(論文ドラフト、スクリプト、スコア)
 hoodoer/colonelclustered
Java製のBurpプラグインで、サーバーレスポンスの実際の内容に基づいてレスポンスに対してテキストクラスタリングを実行し、外れ値やグループを特定します。たとえばIntruderの実行結果からなどです。
 rbidou/pyrasp
Python Webサーバー、サーバーレス関数、MCPサーバー向けのRuntime Application Self Protection。シグネチャ不要で攻撃、プロンプトインジェクション、データ漏洩を検知します。
 euph00/zoneclaw-code
OpenClawスタイルのコンピュータ操作エージェントに対する永続メモリ攻撃のベンチマークおよび防御コード。メモリゾーニングによる緩和策、攻撃シナリオ、評価スクリプトを含む。
 sliu11-byte/mea-bench
ブラックボックスLLM抽出攻撃、防御、および適応型攻撃のためのライフサイクルベンチマーク。
 js-lee-ai/refusal-relocates
Refusal localizes, the damage relocates, safety layers under few-sample fine-tuning
 liuz233/harde
HARDEの研究コード。エージェントの安全性ベンチマーク全体にわたる実行時リスク検出と実行制御のために、コンポーネントをプローブし適応的に最適化するエージェントハーネス。
 kevinchunye/prompt_injection
ツールを使用するLLMエージェントパイプラインにおいて、プロンプトインジェクション防御がどこで発火するかを測定するベンチマークハーネス。公開、永続化、中継、実行の各段階にわたってカナリートークンを追跡する。
 joshuaprovoste/deserializer
AI、LLM、ロボティクス、データサイエンス、機械学習、深層学習(ただしこれらに限定されない)におけるPythonのRCE経路と深いデシリアライゼーションチェーンを発見するための、エージェント型LLM駆動の関係マッピングを備えたASTベースの静的コードアナライザー。
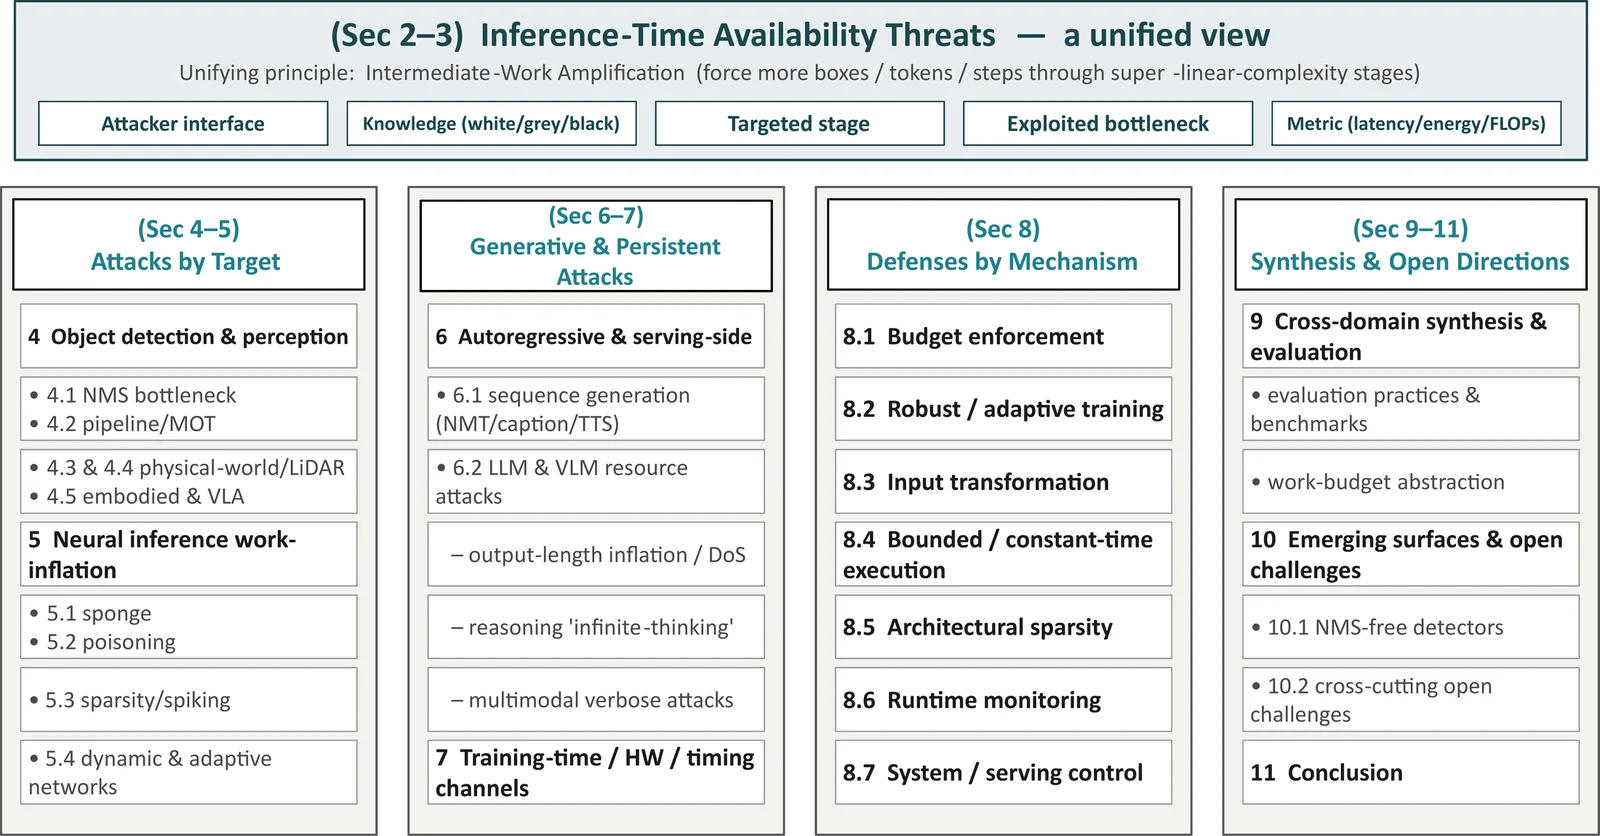 guzonghua/awesome-latency-attacks
深層学習のレイテンシ、エネルギー・レイテンシ、およびタイミング(可用性)攻撃と防御のキュレーションされたインデックス — ACM Computing Surveys 投稿のコンパニオン。
 facebookresearch/meta_secalign
プロンプトインジェクション攻撃に対する防御のためのオープンウェイトLLMとトレーニング/評価コード。エージェント型ツール呼び出しと指示追従のセキュリティに関するベンチマーク付き。
 kaill-jlq/mmskillrisk
LLMエージェントがマルチモーダルスキル画像に隠された悪意のある指示に抵抗できるかをテストするベンチマークおよび評価ハーネス。5つのリスクカテゴリにわたる108件のケースとASR/TSRスコアリングを備える。
 zju-llm-safety/trace
Agentic jailbreak framework for LLM-based agents using scheme-based task decomposition, multi-turn disguising strategies, and adaptive self-evolution…
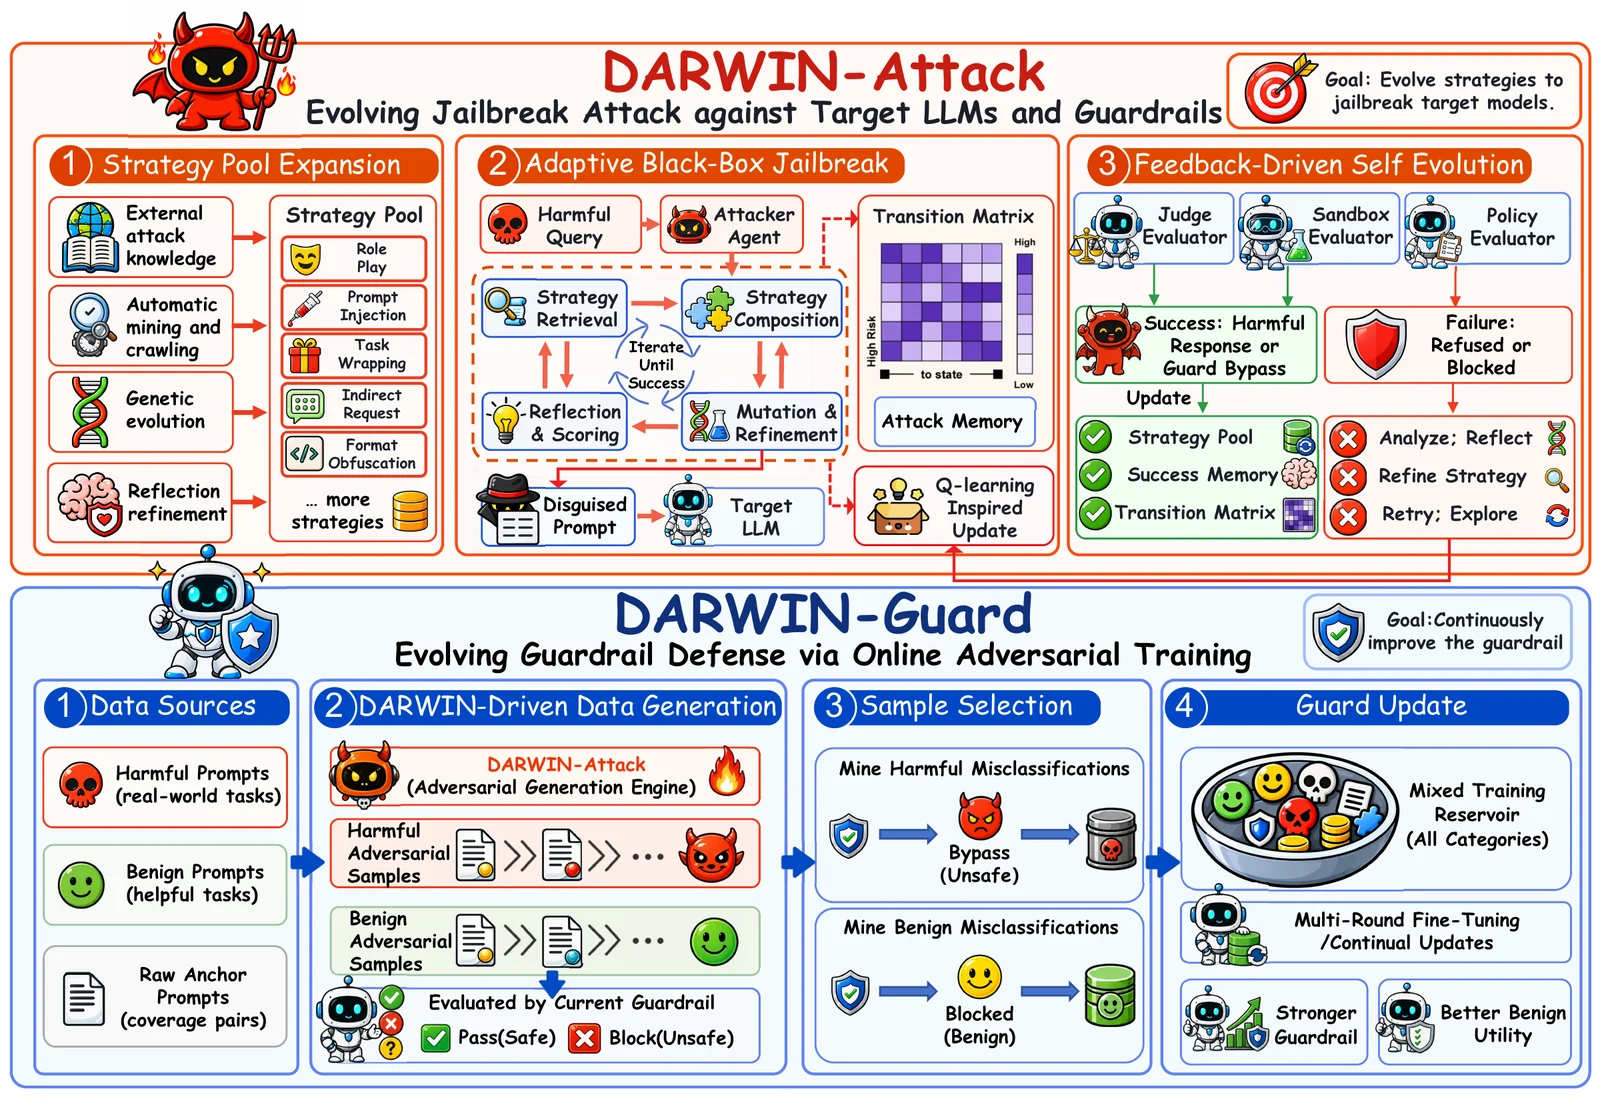 zju-llm-safety/darwin
進化的LLMジェイルブレイクおよびガードレールフレームワーク。遺伝的変異、マルコフ選択、オンライン敵対的トレーニングにより、再利用可能な戦略プールを成長させ、安全性評価を行う。
 albert-y1n/piforge
RLベースのプロンプトインジェクションレッドチーミング向けのオープンフレームワーク。共有トレーナー、カリキュラム学習、およびAgentDojo、InjecAgent、PIArenaなどのベンチマークを備えています。
 123wwwa/flowname
Next-generation JavaScript identifier recovery with LLMs.
 wsu-cyber-security-lab-ai/clipguard
敵対的画像摂動ツール。SAMセグメンテーションとCLIPモデルを使用して、セキュリティ研究のためにAIベースの詐欺画像分類器を回避する。
 azzzzliao/aegis-audio-defense
Defense framework that keeps audio-language models frozen and adds a mid-layer risk gate with late-layer safety adapters to block audio jailbreaks at…