数十個の有害な例で、アラインメント済みモデルの有害な要求に対する拒否を除去できる。先行研究は安全性を特定の層と方向に局所化しており、発見された場所を保護することを示唆している。本リポジトリは、その前提を適応的攻撃者のように検証する。拒否を回復できる場所を見つけ、その領域を凍結して再び攻撃し、重み更新を修復したうえで攻撃者にそれを拡散させる。
本研究は3つの測定に基づいている。
本リポジトリは、測定と両方の防御を小さなライブラリとして、また論文の表を再構築する実行記録とスクリプトとして提供する。
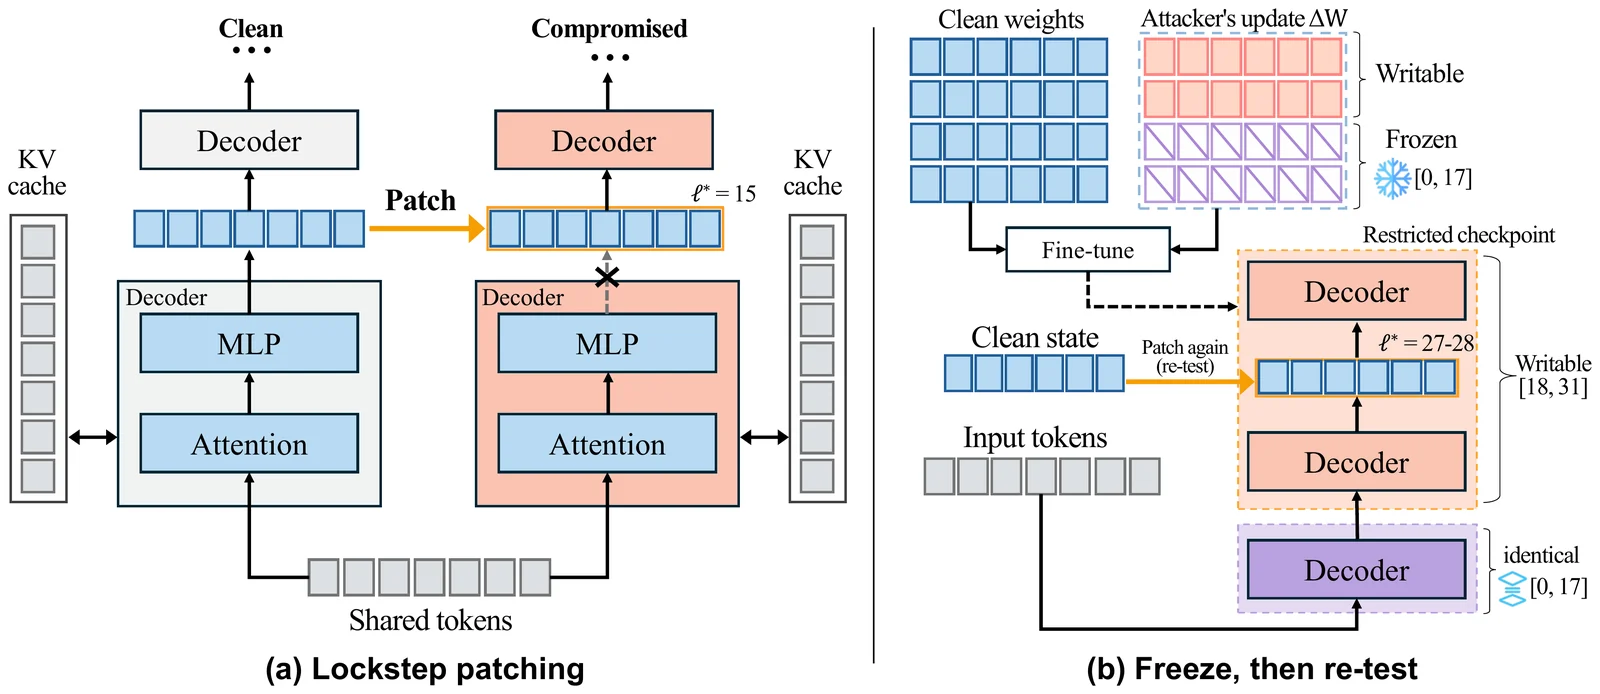
(a) ロックステップ活性化パッチングは、プリフィル時と各デコーディングステップで侵害されたモデルの層出力をクリーンな状態で上書きする。(b) 対応するLlama攻撃では、層0–17を凍結すると半減衰遷移が15から27–28へ移動する。
pip install "git+https://github.com/js-lee-AI/refusal-relocates.git"
import numpy as np
import refusal

rng = np.random.default_rng(0)
A = rng.standard_normal((16, 512)) / 512 ** 0.5    # LoRA factors of one module, rank 16
B = rng.standard_normal((512, 16)) / 16 ** 0.5
for name, decay in [("ordinary", 0.5), ("spread", 1.0)]:
    b = B * decay ** np.arange(16)                  # energy in a few directions, or spread flat
    before, after = refusal.update_stats(A, b), refusal.update_stats(*refusal.remove_top_k(A, b, k=2))
    print(f"{name:8s}  PR/r {before['pr_over_r']:.2f}  top-2 energy {before['top2_energy_fraction']:.2f}"
          f"  norm left after top-2 removal {after['unscaled_norm'] / before['unscaled_norm']:.2f}")
# ordinary  PR/r 0.10  top-2 energy 0.94  norm left after top-2 removal 0.24
# spread    PR/r 0.94  top-2 energy 0.18  norm left after top-2 removal 0.90
通常のファインチューニングは更新の大部分を少数の特異方向に集中させるため、上位2方向を除去するとその大半が失われる。分散した更新はスペクトルが平坦であるため、同じ除去を行ってもその大部分が残る。PR/r(LoRAランクに対する参加率)は、論文のスペクトル検出器のスコアでもある。
これはCPU上で約1秒で実行され、何もダウンロードしない。同じコードはexamples/quickstart.pyにあり、CIはプッシュのたびにこれを実行する。
実際のチェックポイントをトレーニング、パッチ適用、評価するには、models エクストラをインストールする。
pip install "refusal-relocates[models] @ git+https://github.com/js-lee-AI/refusal-relocates.git"
| install | 追加されるもの | 十分な用途 |
|---|---|---|
pip install "git+https://github.com/js-lee-AI/refusal-relocates.git" | numpy | スペクトルコア、top-k 除去、検出器、拒否スコアラー、refusal コマンド |
pip install "refusal-relocates[models] @ git+https://github.com/js-lee-AI/refusal-relocates.git" | torch, transformers, peft, accelerate, safetensors, scikit-learn, datasets | モデル上でのトレーニング、lockstep パッチ適用、プローブ、評価 |
git clone してから pip install -e ".[models,test]" | pytest | experiments/、records/、tests/ |
Python 3.11.5、PyTorch 2.10.0、Transformers 4.57.3、PEFT 0.18.0 でテスト済み。モデルは CUDA デバイス上で bfloat16 としてロードされます。
import refusal

data = refusal.load_data("data/prompt_sets.json")        # built by `refusal prepare`, see below
prompts = data["advbench"][:40]
clean, tokenizer = refusal.load_model("meta-llama/Llama-3.1-8B-Instruct")
attacked, _ = refusal.load_model("meta-llama/Llama-3.1-8B-Instruct", adapter="runs/attack/adapter")

for layer in [6, 9, 12, 15, 18]:
    responses = refusal.lockstep_generate(clean, attacked, tokenizer, prompts, layer=layer)
    print(layer, sum(refusal.is_refusal(r) for r in responses) / len(prompts))
両モデルは同じトークンを読み取り、選択したレイヤーで侵害されたモデルの出力がクリーンなモデルの出力に置き換えられます。refusal patch は床・天井・2つの対照を含む完全な測定を実行し、パープレキシティゲートと Llama-Guard で一貫した拒否をスコアリングし、遷移深度を報告します。
import refusal

stats = refusal.update_stats(A, B)                 # one module, A is rank x in and B is out x rank
A2, B2 = refusal.remove_top_k(A, B, k=2)           # the top-two repair, as new LoRA factors
result = refusal.calibrate_detector(benign_scores, attack_scores, budget=0.05)
アダプターの検出スコアは、そのアテンション射影全体で平均化されたPR/rであり、refusal spectra は保存されたアダプターからCPU上でこれを計算します。
| 呼び出し | 動作 | 必要なもの |
|---|---|---|
refusal.update_stats(A, B) | 1つのLoRA更新の参加率、PR/r、上位2つのエネルギー、ノルム | 基本インストール |
refusal.remove_top_k(A, B, k) | 最大のk個の特異方向を除去した更新の因子 | 基本インストール |
refusal.calibrate_detector(benign, attacks, budget) | 良性の偽陽性予算における閾値と、それがフラグを立てる攻撃 | 基本インストール |
refusal.is_refusal(text), refusal.summarize(...) | 明示的拒否パターン、パープレキシティゲート付きの一貫した拒否 | 基本インストール |
refusal.transition_depth(rows, ceiling, floor, rescaled=True) | 半範囲以上の回復を示す最初のパッチ適用層 | 基本インストール |
refusal.prepare(...), refusal.load_data(path) | 公開データから凍結プロンプトセットを再構築して検証 | 基本インストール |
refusal.load_model(name, adapter=...) | bfloat16のチェックポイント、オプションでLoRAアダプター付き | [models] |
refusal.lockstep_generate(clean, attacked, tokenizer, prompts, layer) | 1つの層にクリーン状態をパッチ適用した貪欲デコーディング | [models] |
refusal.add_adapter(model, freeze="bottom", n_frozen=18) | 書き込み可能な層のみへのLoRA | [models] |
refusal.remove_top(model, k), refusal.adapter_stats(path) | ロード済みまたは保存済みアダプターに対するtop-k修復とスペクトル統計 | [models] |
基本インストールと記された呼び出しはtorchなしでインポートできます。重いモジュールは、その名前が初めて使用されたときにロードされます。
パッケージをインストールすると refusal コマンドが追加され、python -m refusal でも同じものが実行されます。
refusal --help
refusal demo                                                    # the quickstart, on CPU
refusal prepare --pku ... --alpaca ... --advbench ... --xstest ...   # rebuild the frozen prompt sets
refusal train --freeze bottom --n-frozen 18 --out runs/freeze   # LoRA attack with layers 0 to 17 frozen
refusal patch --adapter runs/freeze/adapter --out runs/freeze/patch     # lockstep patching
refusal evaluate --adapter runs/freeze/adapter --ranks 1,2,4 --out runs/freeze/evaluate
refusal spectra --adapter runs/freeze/adapter --out spectrum.json        # on CPU
refusal detector --benign benign/*.json --attacks attacks/*.json --out detector.json
100件の有害な例では、6つのチェックポイントすべてで拒否率はほぼゼロのままであり、回復の遷移は凍結境界を上回っている。