

benign-instruction-bench
 lzwhehe/benign-instruction-bench
Neubewertung von Prompt-Injection-Detektoren bei Tool-Ausgaben von LLM-Agenten (Paper-Entwurf, Skripte, Bewertungen)
defensive-toolsvulnerability-analysismachine-learning+3
lzwhehe/benign-instruction-benchNeubewertung von Prompt-Injection-Detektoren bei Tool-Ausgaben von LLM-Agenten (Paper-Entwurf, Skripte, Bewertungen)
 hoodoer/colonelclustered
Ein Java-Burp-Plugin, das Text-Clustering auf Antworten durchführt, um Ausreißer/Gruppen basierend auf dem tatsächlichen Inhalt der Server-Antworten…
 rbidou/pyrasp
Runtime Application Self Protection für Python-Webserver, serverlose Funktionen und MCP-Server, die Angriffe, Prompt-Injection und Datenlecks ohne…
 euph00/zoneclaw-code
Benchmark- und Verteidigungscode für persistente Speicherangriffe auf Computer-Use-Agenten im OpenClaw-Stil, mit Memory-Zoning-Mitigation,…
 sliu11-byte/mea-bench
Ein Lifecycle-Benchmark für Black-Box-LLM-Extraktionsangriffe, Verteidigungen und adaptive Angriffe.
 js-lee-ai/refusal-relocates
Refusal localizes, the damage relocates, safety layers under few-sample fine-tuning
 liuz233/harde
Forschungscode für HARDE, ein Agent-Harness, das Komponenten für die Laufzeit-Risikoerkennung und Ausführungskontrolle über…
 kevinchunye/prompt_injection
Benchmark-Harness zur Messung, an welcher Stelle Prompt-Injection-Abwehrmechanismen in LLM-Agent-Pipelines mit Tool-Nutzung auslösen, wobei…
 joshuaprovoste/deserializer
AST-basierter statischer Code-Analysator mit agentischer, LLM-gestützter Beziehungszuordnung zur Entdeckung von Python-RCE-Pfaden und tiefen…
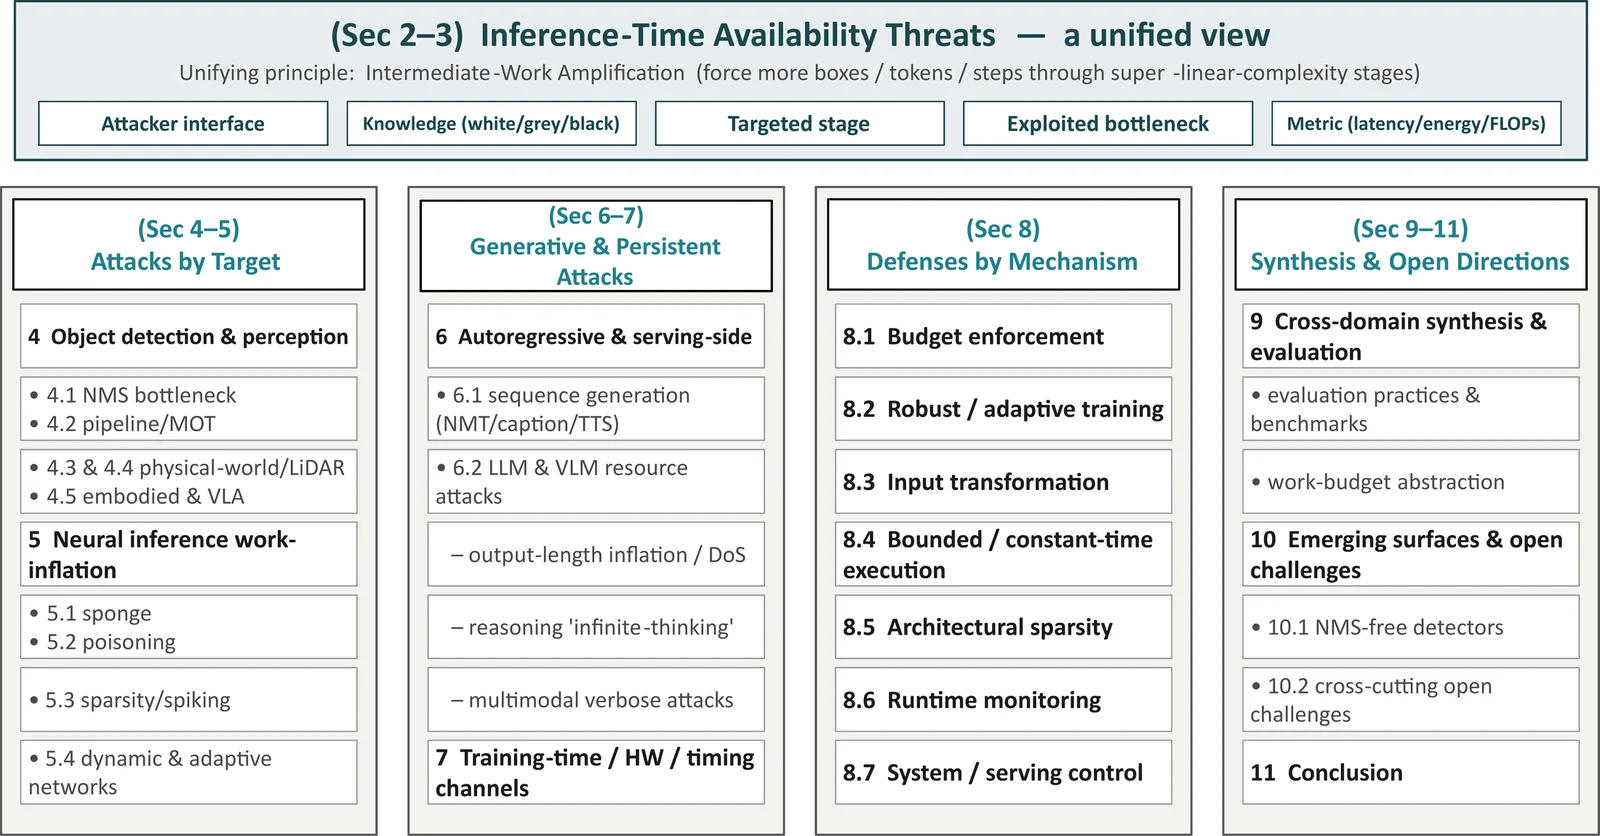 guzonghua/awesome-latency-attacks
Kuratierter Index zu Deep-Learning-Latenz-, Energie-Latenz- und Timing-(Verfügbarkeits-)Angriffen und -Verteidigungen — Begleitmaterial zur…
 facebookresearch/meta_secalign
Open-Weight-LLMs und Trainings-/Evaluierungscode zur Verteidigung gegen Prompt-Injection-Angriffe, mit Benchmarks für agentisches Tool-Calling und…
 kaill-jlq/mmskillrisk
Benchmark- und Evaluierungs-Harness, der testet, ob LLM-Agenten bösartigen Anweisungen widerstehen, die in multimodalen Skill-Bildern verborgen sind,…
 zju-llm-safety/trace
Agentic jailbreak framework for LLM-based agents using scheme-based task decomposition, multi-turn disguising strategies, and adaptive self-evolution…
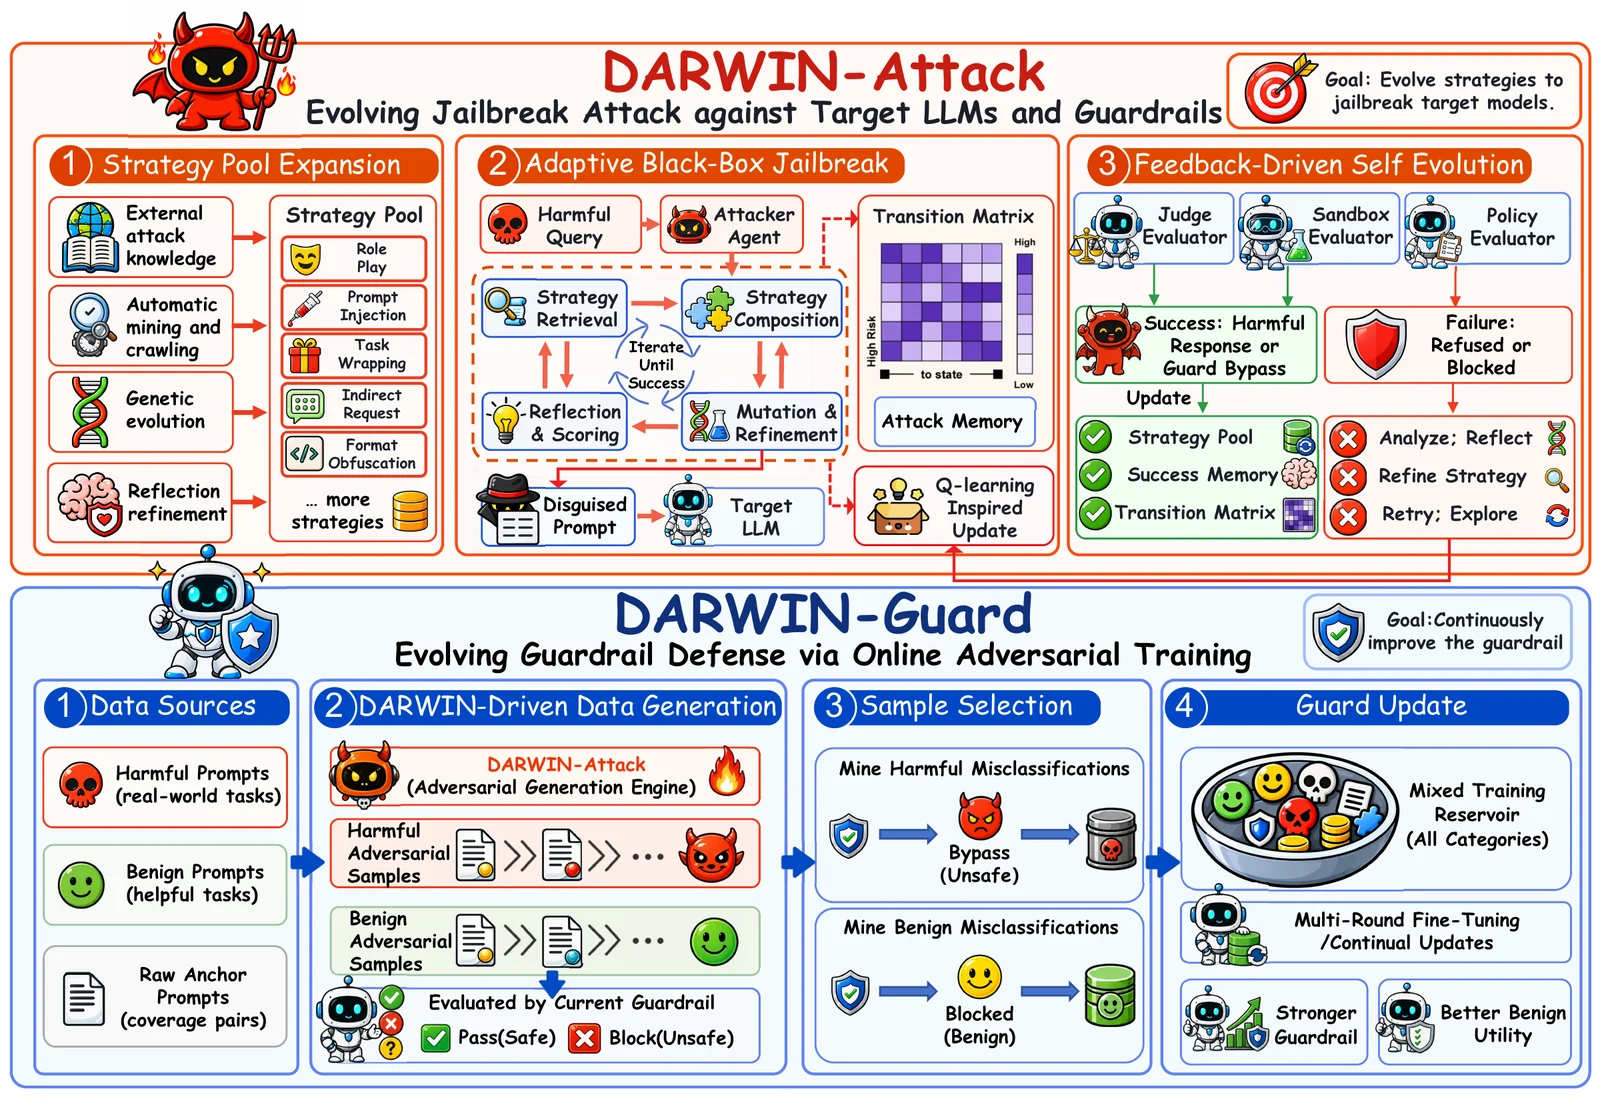 zju-llm-safety/darwin
Evolutionäres LLM-Jailbreak- und Guardrail-Framework, das einen wiederverwendbaren Strategiepool durch genetische Mutation, Markov-Auswahl und…
 albert-y1n/piforge
Offenes Framework für RL-basiertes Red Teaming bei Prompt-Injection, mit einem gemeinsamen Trainer, Curriculum Learning und Benchmarks wie AgentDojo,…
 123wwwa/flowname
JavaScript-Identifikator-Wiederherstellung der nächsten Generation mit LLMs.
 wsu-cyber-security-lab-ai/clipguard
Adversarielles Bildstörungswerkzeug, das SAM-Segmentierung und CLIP-Modelle nutzt, um KI-basierte Betrugsbild-Klassifikatoren für…
 azzzzliao/aegis-audio-defense
Defense framework that keeps audio-language models frozen and adds a mid-layer risk gate with late-layer safety adapters to block audio jailbreaks at…