
 js-lee-ai/refusal-relocates
LLM-Sicherheit: Analysiere, wie Fine-Tuning das Ablehnungsverhalten verändert, und bewerte Layer-Freezing- und Low-Rank-Verteidigungen.





Projektseite · Schnellstart · Verwendung · CLI · Ergebnisse · Reproduzieren · FAQ · Zitation
Ein paar Dutzend schädlicher Beispiele können die Verweigerung schädlicher Anfragen bei einem ausgerichteten Modell aufheben. Frühere Arbeiten lokalisieren die Sicherheit in bestimmten Schichten und Richtungen, was nahelegt, den gefundenen Ort zu schützen. Dieses Repository prüft diese Prämisse so, wie es ein adaptiver Angreifer tun würde. Es findet heraus, wo die Verweigerung wiederhergestellt werden kann, friert diesen Bereich ein und greift erneut an, und es repariert das Gewichtsupdate und lässt dann den Angreifer es ausbreiten.
Die Studie stützt sich auf drei Messungen.
Dieses Repository enthält die Messung und beide Verteidigungen als kleine Bibliothek sowie die Laufprotokolle und Skripte, die die Tabellen des Papers neu erstellen.
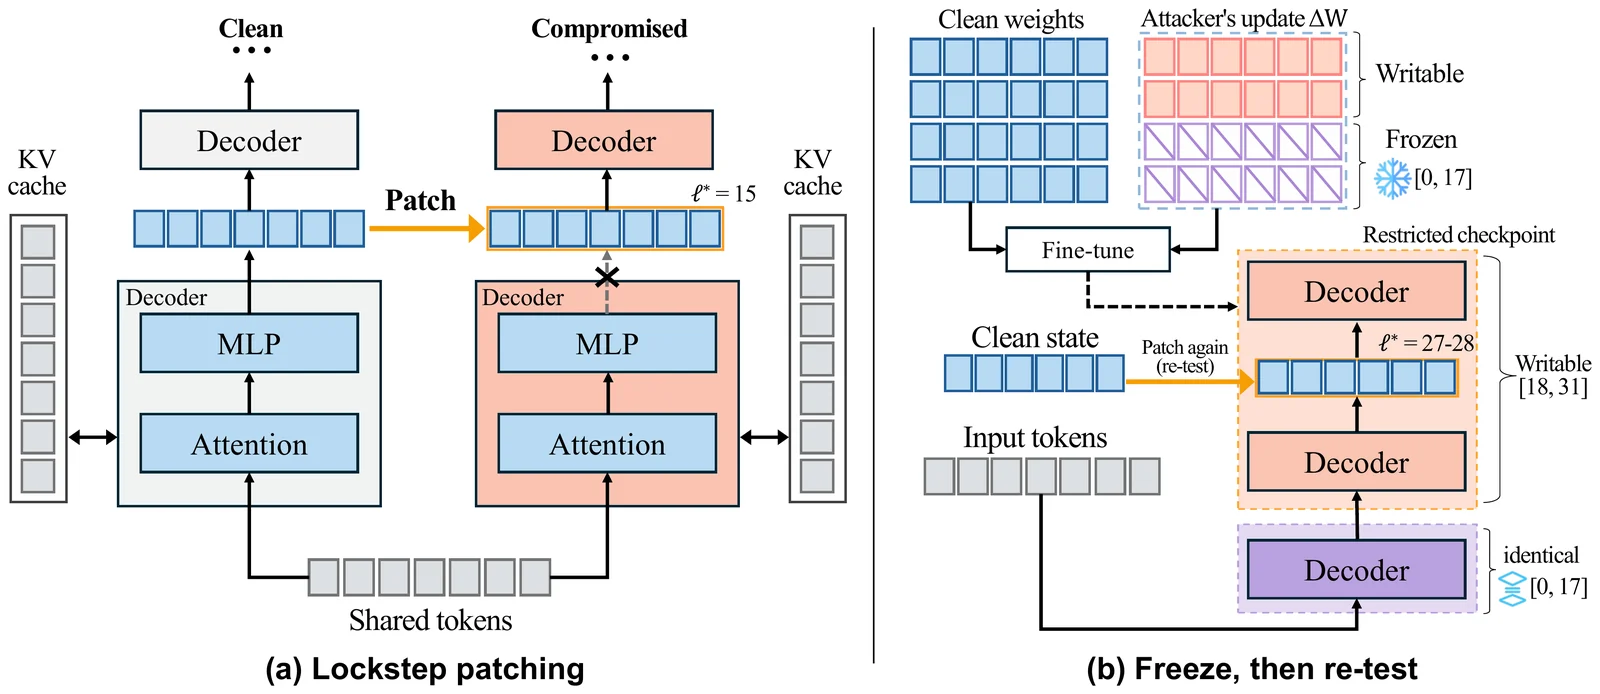
(a) Lockstep-Aktivierungspatching überschreibt die Schichtausgabe des kompromittierten Modells mit dem sauberen Zustand beim Prefill und bei jedem Decoding-Schritt. (b) Im abgestimmten Llama-Angriff verschiebt das Einfrieren der Schichten 0–17 den Half-Ceiling-Übergang von 15 auf 27–28.
pip install "git+https://github.com/js-lee-AI/refusal-relocates.git"
import numpy as np
import refusal

rng = np.random.default_rng(0)
A = rng.standard_normal((16, 512)) / 512 ** 0.5    # LoRA factors of one module, rank 16
B = rng.standard_normal((512, 16)) / 16 ** 0.5
for name, decay in [("ordinary", 0.5), ("spread", 1.0)]:
    b = B * decay ** np.arange(16)                  # energy in a few directions, or spread flat
    before, after = refusal.update_stats(A, b), refusal.update_stats(*refusal.remove_top_k(A, b, k=2))
    print(f"{name:8s}  PR/r {before['pr_over_r']:.2f}  top-2 energy {before['top2_energy_fraction']:.2f}"
          f"  norm left after top-2 removal {after['unscaled_norm'] / before['unscaled_norm']:.2f}")
# ordinary  PR/r 0.10  top-2 energy 0.94  norm left after top-2 removal 0.24
# spread    PR/r 0.94  top-2 energy 0.18  norm left after top-2 removal 0.90
Ein gewöhnliches Fine-Tuning legt den Großteil seiner Aktualisierung in wenige singuläre Richtungen, sodass das Entfernen der obersten zwei den größten Teil davon entfernt. Eine verteilte Aktualisierung hat ein flaches Spektrum, sodass dasselbe Entfernen den größten Teil davon an Ort und Stelle lässt. PR/r, das Partizipationsverhältnis über den LoRA-Rang, ist zugleich der Score des spektralen Detektors aus dem Paper.
Dies läuft auf einer CPU in etwa einer Sekunde und lädt nichts herunter. Derselbe Code ist examples/quickstart.py, und CI führt ihn bei jedem Push aus.
Um echte Checkpoints zu trainieren, zu patchen und zu evaluieren, installieren Sie das Extra models.
pip install "refusal-relocates[models] @ git+https://github.com/js-lee-AI/refusal-relocates.git"
| Installation | fügt hinzu | ausreichend für |
|---|---|---|
pip install "git+https://github.com/js-lee-AI/refusal-relocates.git" | numpy | den spektralen Kern, die Top-k-Entfernung, den Detektor, den Refusal-Scorer, den Befehl refusal |
pip install "refusal-relocates[models] @ git+https://github.com/js-lee-AI/refusal-relocates.git" | torch, transformers, peft, accelerate, safetensors, scikit-learn, datasets | Training, Lockstep-Patching, Probes und Evaluierung an einem Modell |
git clone und dann pip install -e ".[models,test]" | pytest | experiments/, records/ und tests/ |
Getestet mit Python 3.11.5, PyTorch 2.10.0, Transformers 4.57.3 und PEFT 0.18.0. Modelle werden in bfloat16 auf einem CUDA-Gerät geladen.
import refusal

data = refusal.load_data("data/prompt_sets.json")        # built by `refusal prepare`, see below
prompts = data["advbench"][:40]
clean, tokenizer = refusal.load_model("meta-llama/Llama-3.1-8B-Instruct")
attacked, _ = refusal.load_model("meta-llama/Llama-3.1-8B-Instruct", adapter="runs/attack/adapter")

for layer in [6, 9, 12, 15, 18]:
    responses = refusal.lockstep_generate(clean, attacked, tokenizer, prompts, layer=layer)
    print(layer, sum(refusal.is_refusal(r) for r in responses) / len(prompts))

