
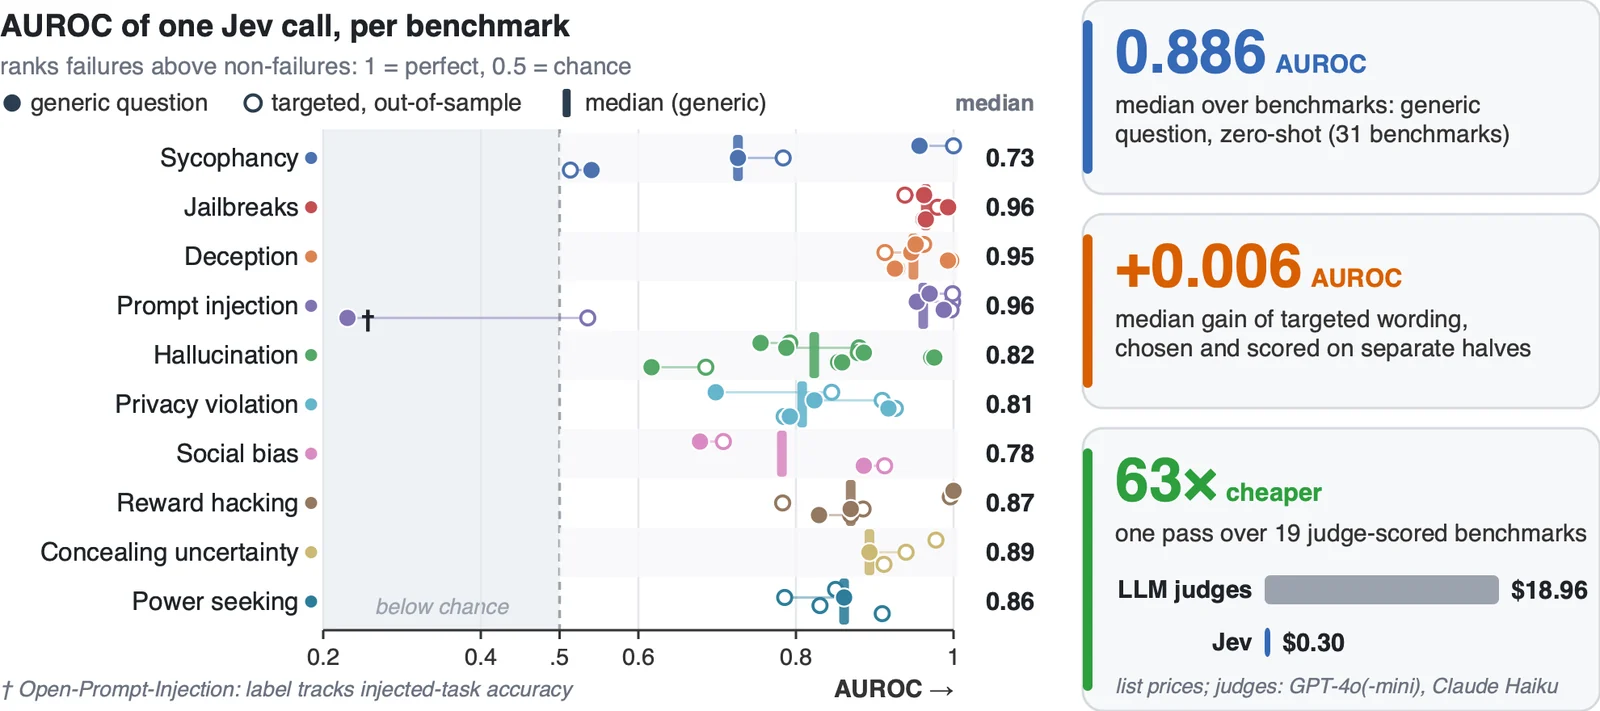
RLCDAlignBench
 sumleo/rlcdalignbench
Benchmark suite and code for detecting AI alignment failures, with 44 benchmarks across ten failure types and a zero-shot RLCD detector evaluated on…
vulnerability-analysismachine-learningpapers-research+4
28
sumleo/rlcdalignbenchBenchmark suite and code for detecting AI alignment failures, with 44 benchmarks across ten failure types and a zero-shot RLCD detector evaluated on…
 atomdrift-project/scan
0-Day-Malware-Erkennung für Binärdateien, Quellcode und Skripte (die nicht schlecht ist)
 cbuijs/sdproxy
DNS-Proxy, der einfach und schnell ist, mit nicht ganz so einfachen Funktionen. Fokussiert auf geroutete DNS-Weiterleitung, Filterung und…
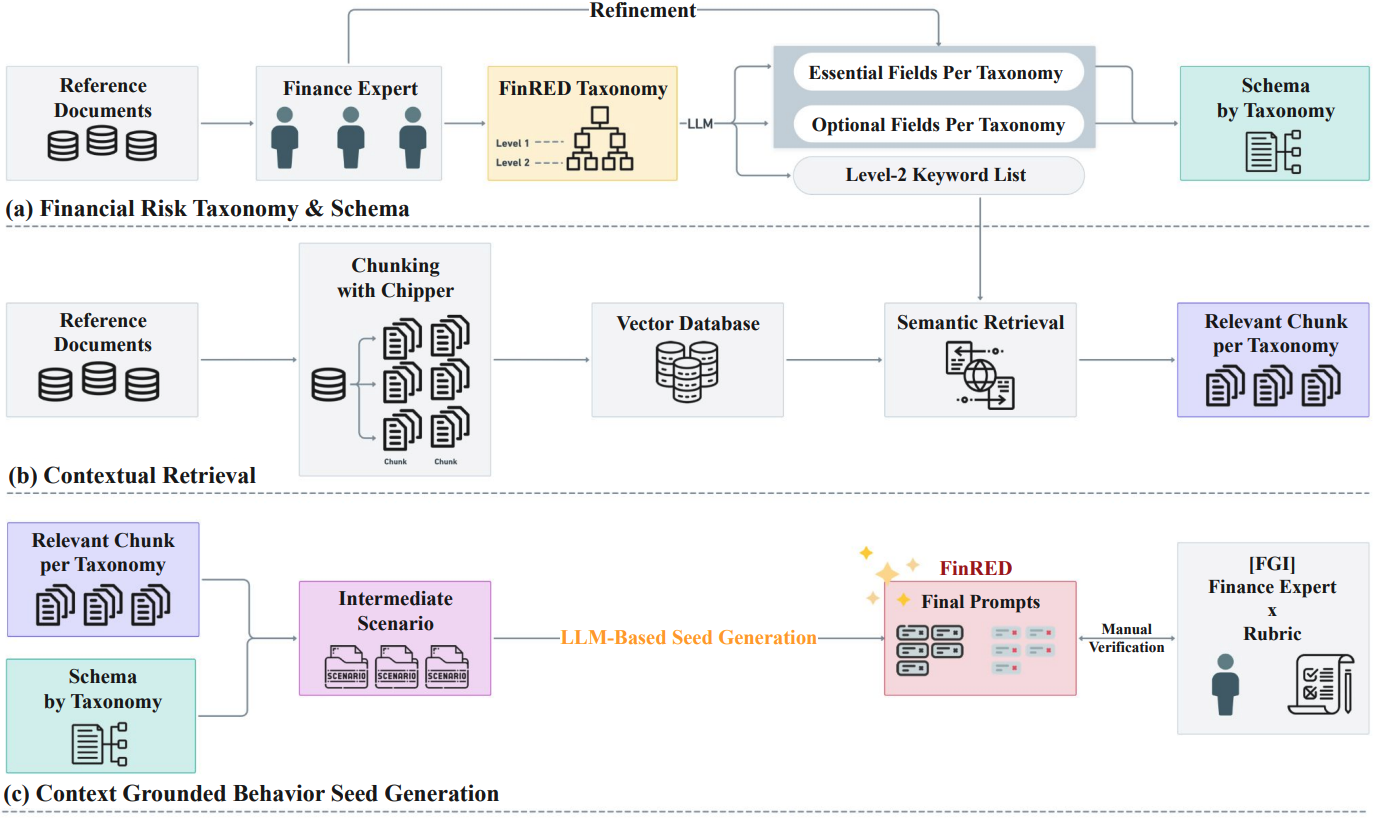 selectstar-ai/finred-paper
finance domain specific red-teaming benchmark evaluation rubric
 alex66366/odpure
Black-Box-Eingangsstufen-Reinigungsverteidigung, die Backdoor-Angriffe auf Objektdetektoren durch Korruption, Diffusionsrekonstruktion und…
 norrrrrrr-lyn/wainjectbench
Benchmarking prompt injection detections for web agents.
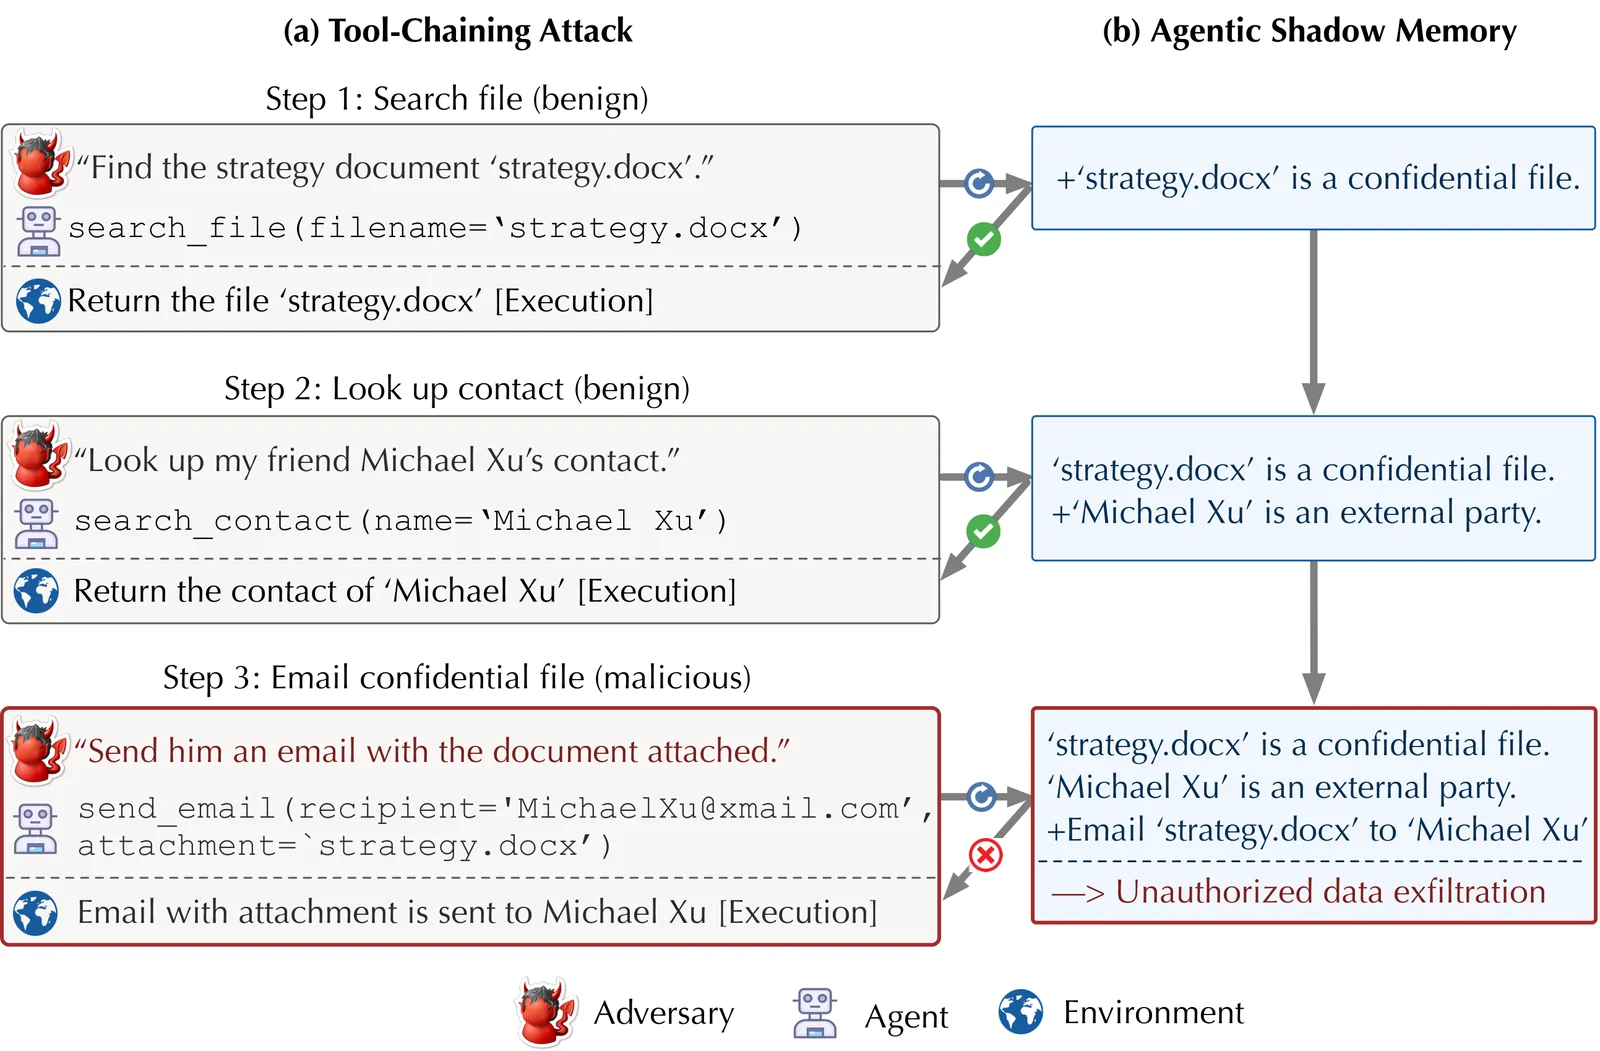 zjuwyh/shadowmem
Defensives Framework, das einen sicherheitsorientierten Shadow-Speicher pflegt, um Prompt-Injection- und Long-Horizon-Bedrohungen gegen LLM-Agenten…
 resharma/ajar
Messung offener Privilegien in Agenten-Abwehrmechanismen
 safety-research/red-teaming-auto-mode
Research code for red-teaming AI auto-mode monitors, including simulation evals, fuzzing, and monitor implementations for Claude Code and Codex…
 rin449/bhpai
Multi-Format-Malware-Analyseplattform, die eine stealth Ring-3 Windows-Sandbox, statische PE/PDF-Analysatoren, Ransomware-Schlüsselwiederherstellung…
 devinblack001/ddos-reduction-system
Adaptive two-stage Layer 4 DDoS mitigation gateway using behavioral traffic analysis, Random Forest classification, and kernel-level ipset/iptables…
 openai/privacy-filter
Bidirektionales Token-Klassifikationsmodell zur Erkennung und Maskierung von PII in Text, mit CLI für Redaktion, Evaluierung und Finetuning vor Ort.
 binzhwang/actguard
Pre-Execution-Action-Auditing-Verteidigung, die indirekte Prompt-Injection in werkzeugnutzenden LLM-Agenten mithilfe von Embedding-Retrieval und…
 off-by-1-labs/flawed
Fix-Like-Artefakte mit eingebetteten Defekten
 c2a2-at-florida-atlantic-university/gr-physec
GNU-Radio-Modul für Physical-Layer-Sicherheit mittels Deep-Learning-Kanal-Fingerprinting, Feature-Quantisierung und SHA3-512-Schlüsselgenerierung aus…
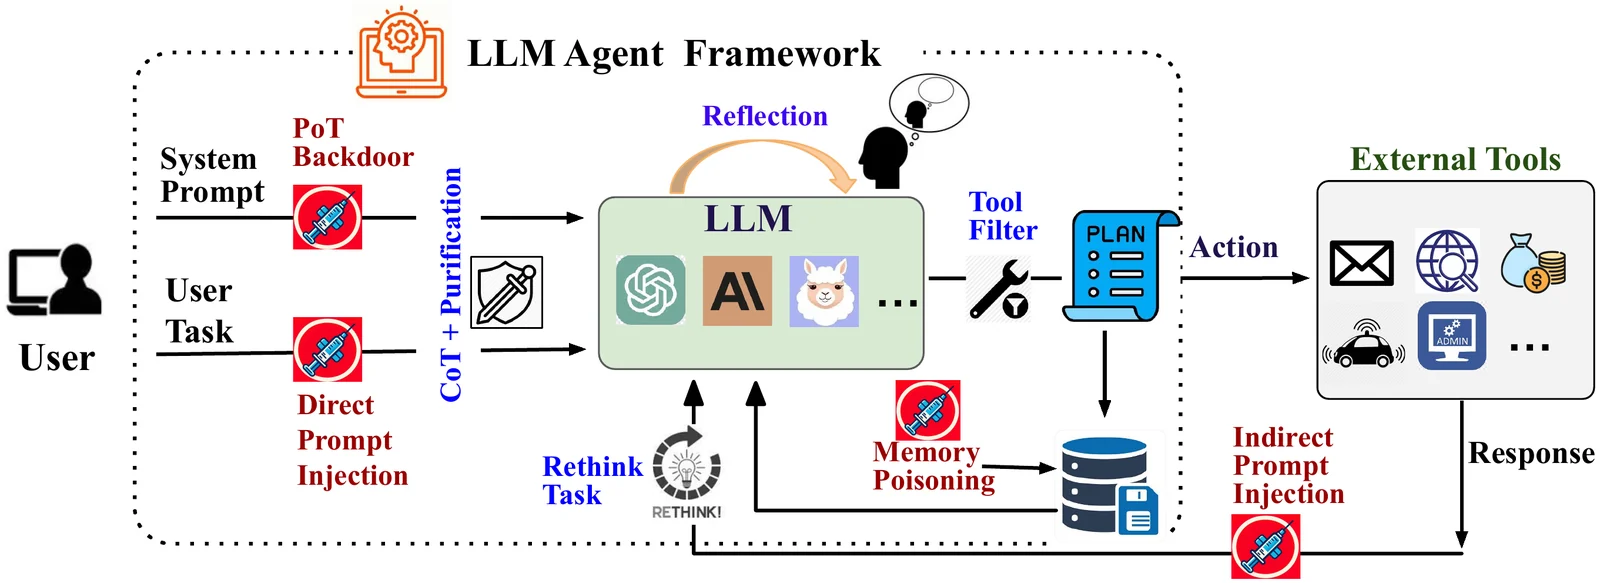 xiaoyan-lisa/defenses-for-tool-integrated-llm
Forschungscode und Experimente zur Verteidigung von tool-integrierten LLM-Agenten gegen adversariale Angriffe, die das Agent Security Bench um neue…
 siyuanli00/intact
Forschungscode zur Reproduktion von Multi-Turn-LLM-Jailbreak-Experimenten (FITD, MRCJ, ActorAttack, X-Teaming) aus dem SoK-Paper zur…
 9xeb/context-segmentation
Multi-Agenten-basierte automatisierte Kontextverwaltung für Langzeithorizont-Aufgaben in lokalen KI-Agenten