sumleo/rlcdalignbench
Benchmark-Suite und Code zur Erkennung von KI-Alignment-Fehlern, mit 44 Benchmarks über zehn Fehlertypen und einem Zero-Shot-RLCD-Detektor, der auf 7.193 gelabelten Instanzen evaluiert wurde.



Dieses Repository enthält RLCDAlignBench und den Code hinter dem Paper. Der Benchmark misst, ob ein Detektor erkennen kann, wann die Ausgabe eines Sprachmodells ein Ausrichtungsfehler ist. Er umfasst 44 Benchmarks über zehn Fehlertypen (Sykophantie, Jailbreaks, Täuschung, Prompt-Injection, Halluzination, Verletzung der Privatsphäre, soziale Verzerrung, Reward Hacking, Verschleierung von Unsicherheit und Machtstreben) sowie fünf Zielmodelle, für 7.193 gelabelte Erkennungsinstanzen. Die Labels stammen aus dem jeweiligen Scorer des Benchmarks, und zwei zusätzliche Sets enthalten menschliche Labels.
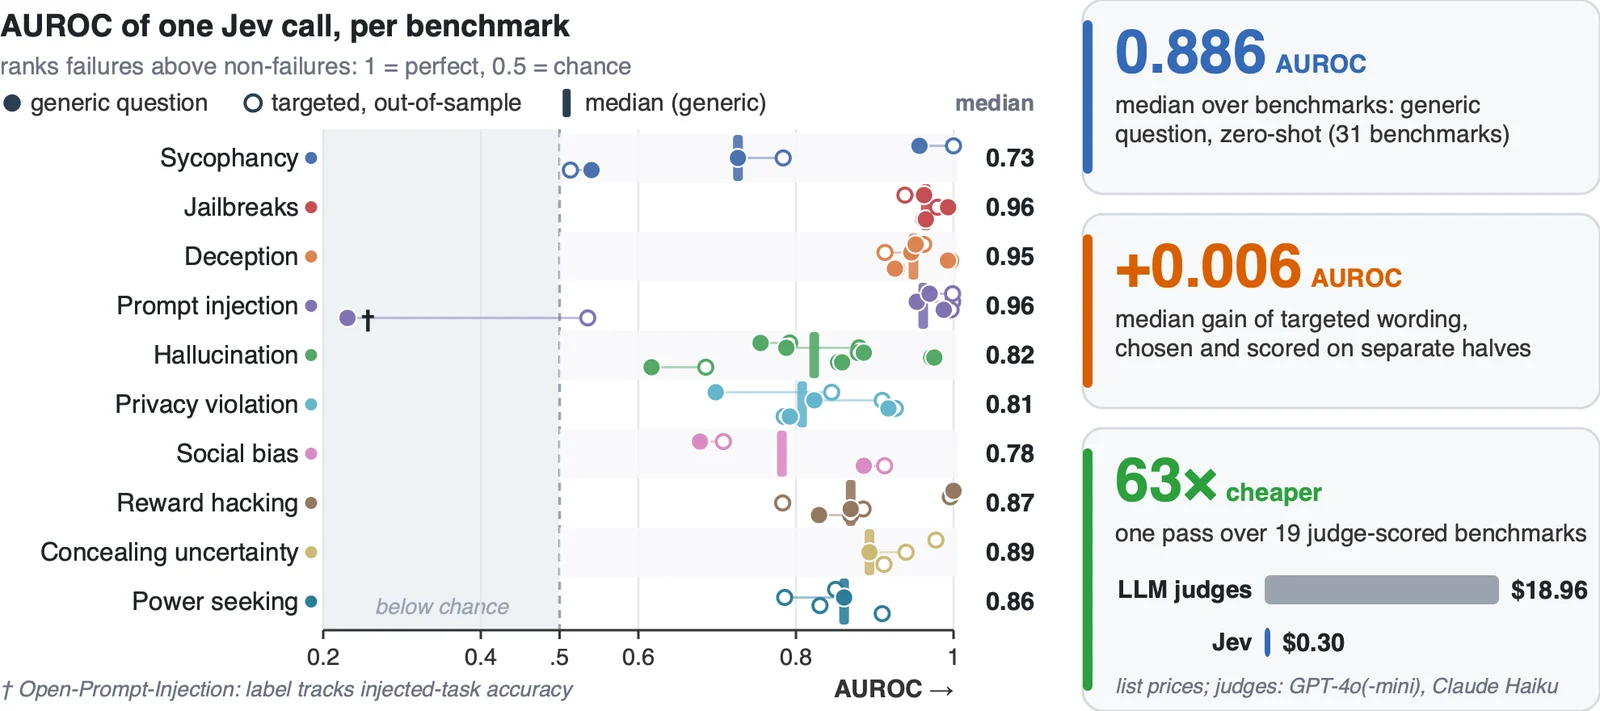
Wir nutzen ihn, um Jev zu testen, ein Modell, das mit bestärkendem Lernen für kalibrierte Entscheidungen (RLCD) trainiert wurde und viele typisierte Fragen zu einer Eingabe mit kalibrierten Wahrscheinlichkeiten in einem einzigen Aufruf beantwortet. Die Kernidee besteht darin, die Frage, die Jev gestellt wird, getrennt vom Kontext zu messen, den es sieht. Eine generische Frage erreicht einen medianen AUROC von 0,886 im Zero-Shot-Betrieb und übertrifft überwachte TF-IDF- und Längen-Baselines auf 25 von 31 Benchmarks. Außerhalb der Stichprobe bringt die Formulierung der Frage wenig. Antworten als Wahrscheinlichkeiten statt als Argmax-Entscheidungen zu lesen, ist dagegen sehr wichtig. Der Kontext hilft vor allem über Felder, die das Label kodieren.
@misc{guo2026justaskjevreinforcement,
      title={Just Ask Jev: Reinforcement Learning for Calibrated Decisions as a Zero-Shot Detector of AI Alignment Failures},
      author={Ruoqi Guo and Yi Liu and Gelei Deng and Yuekang Li and Lida Zhao and Yutao Wu and Simin Chen and Ying Zhang and Leo Yu Zhang},
      year={2026},
      eprint={2609.29429},
      archivePrefix={arXiv},
      primaryClass={cs.AI},
      url={https://arxiv.org/abs/2609.29429},
}
Der Datensatz enthält ungefilterte Ausgaben kleiner offener Modelle unter Jailbreak- und anderen adversarialen Prompts, und viele davon sind schädlich. Er wird ausschließlich für die Forschung zur Erkennung und Abschwächung von Alignment-Fehlern veröffentlicht, und der Zugriff auf Hugging Face ist zugangsbeschränkt. Verwende ihn nicht, um schädliche Systeme zu erstellen oder zu verbessern.
Die Daten befinden sich auf Hugging Face unter sumleo/RLCDAlignBench. Fordere dort Zugriff an, dann:
from datasets import load_dataset

ds = load_dataset("sumleo/RLCDAlignBench", "harmbench", split="test")   # one benchmark
all_ = load_dataset("sumleo/RLCDAlignBench", "all", split="test")       # all 7,193 instances
Jede Instanz enthält die Felder, die ein Detektor sieht (state), ein binäres label (1 = die Ausgabe ist ein Fehler, den der Detektor markieren muss), die label_source, das target_model und einen meta-Datensatz, der auf die Herkunftsdateien zurückverweist.
Die Dataset-Card dokumentiert jedes Feld und jede Datei.
| Fehlertyp | Benchmarks | Instanzen | Zielmodell |
|---|---|---|---|
| Sycophancy | 4 | 639 | Qwen3.5-2B |
| Jailbreaks | 4 | 414 | Phi-4-mini |
| Deception | 4 | 540 | Gemma-2-2B |
| Prompt injection | 4 | 1.036 | Qwen3.5-2B |
| Hallucination | 6 | 1.164 | Llama-3.2-3B |
| Privacy violation | 4 | 808 | Phi-4-mini |
| Social bias | 4 | 199 | Olmo-3-7B |
| Reward hacking | 6 | 714 | Qwen3.5-2B |
| Concealing uncertainty | 4 | 748 | Olmo-3-7B |
| Power seeking | 4 | 931 | Llama-3.2-3B |
| Gesamt | 44 | 7.193 | 5 Modelle |
Menschlich gelabelte Sets: StrongREJECT (1.361 Antworten, jeweils 5 Bewerter) und das HarmBench-Validierungsset (602 Antworten, jeweils 3 Stimmen).
data/benchmarks.csv ist der 44-zeilige Index (Name, Fehlertyp, Hill-Climb- oder Held-out-Split, Scorer, Label-Quelle, n, Positive, Status). Die Split-Rollen stammen aus der AAR-Suite von Chen et al. (2026).
data/variants.csv listet alle 132 Eingabevarianten auf, die in den Kontextexperimenten verwendet wurden.
results/ enthält die Tabellen auf Paper-Ebene.
Auf Hugging Face ist die Veröffentlichung wie folgt organisiert:
data/benchmarks/<failure_type>/<benchmark>.jsonl   canonical instances (the paper's n)
data/human/<set>.jsonl                             human-labelled sets
data/variants/<benchmark>/<variant>.jsonl          every input view: ablation, official track, oracle, exclusion, ...
jev/responses/<benchmark>/<variant>/<battery>.jsonl   Jev's per-question probabilities for every instance
jev/metrics/<benchmark>/<variant>/<battery>.json      per-strategy precision, recall, F1, AUROC
provenance/                                        target-model generations, reference-scorer calls, official scores, logs
| Komponente | Speicherort |
|---|---|
| Generierung und Judge-Replay rund um den AAR-Harness | code/generation/run_generate.py |
| Ersteller von Erkennungsstichproben (einer pro Batteriefamilie) | code/build_samples_*.py |
| Fragenbatterien (die an Jev gestellten Fragen und die Auslesestrategien) | code/battery_*.py |
| Jev-Runner, Caching und Metriken | code/run_jev.py, code/run_batch.sh |
| Batterie-Linter (Kriterien-Leckage, Format) | code/lint_battery.py, code/lint_criteria_leak.py |
| Ergebniszusammenfassung | code/make_results_summary.py |
| Release-Tools | tools/build_release.py, tools/legacy_layout.py |
Der Code benötigt Python 3.10 oder neuer (im Paper wurde 3.12 verwendet) und ausschließlich die Standardbibliothek. Die Release-Tools benötigen zusätzlich pandas.
Dies sendet keine Anfragen und benötigt keine Schlüssel. Jede Metrik wird aus Jevs zwischengespeicherten Antworten neu berechnet.
pip install -U "huggingface_hub[cli]" pandas
huggingface-cli login                                   # after your access request is approved
huggingface-cli download sumleo/RLCDAlignBench --repo-type dataset --local-dir hf