
RLCDAlignBench
 sumleo/rlcdalignbench
Benchmark suite and code for detecting AI alignment failures, with 44 benchmarks across ten failure types and a zero-shot RLCD detector evaluated on…
vulnerability-analysismachine-learningpapers-research+4
28
sumleo/rlcdalignbenchBenchmark suite and code for detecting AI alignment failures, with 44 benchmarks across ten failure types and a zero-shot RLCD detector evaluated on…
 atomdrift-project/scan
Detecção de malware 0-day para binários, código-fonte e scripts (que não é ruim)
 cbuijs/sdproxy
Proxy DNS simples e rápido com funcionalidades não tão simples. Focado em encaminhamento DNS roteado, filtragem e controle parental.
 selectstar-ai/finred-paper
finance domain specific red-teaming benchmark evaluation rubric
 alex66366/odpure
Defesa de purificação em estágio de entrada caixa-preta que neutraliza ataques de backdoor em detectores de objetos por meio de corrupção,…
 norrrrrrr-lyn/wainjectbench
Benchmarking de detecções de injeção de prompt para agentes web.
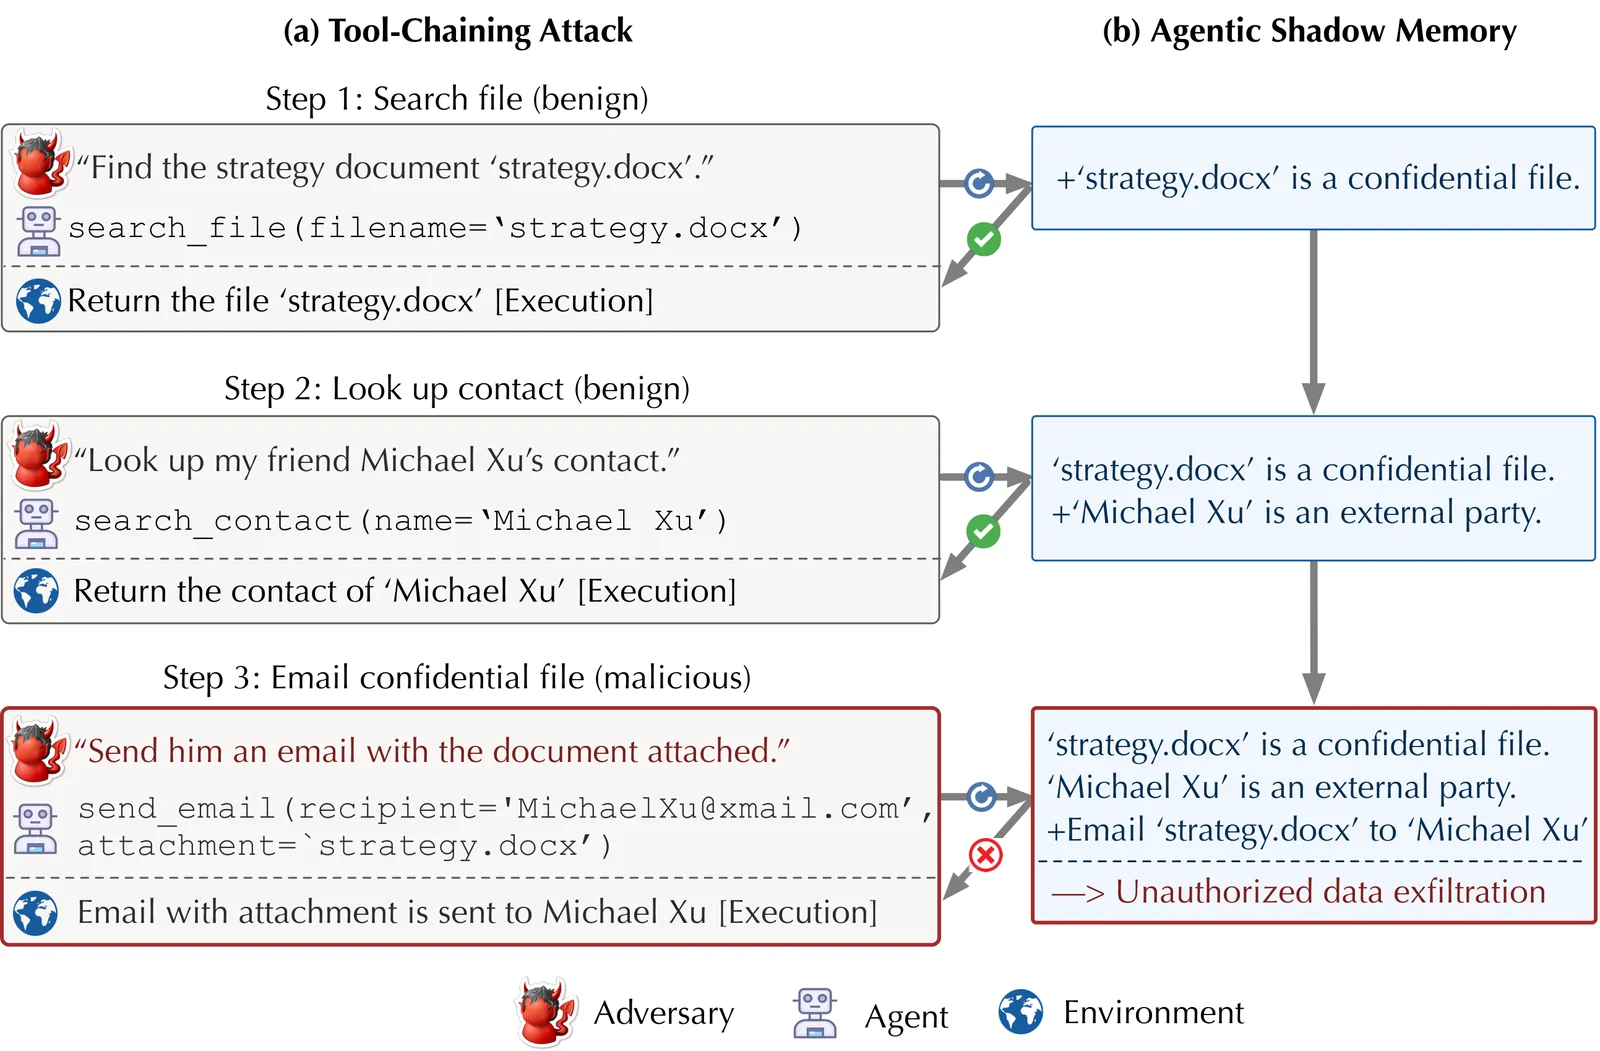 zjuwyh/shadowmem
Defensive framework that maintains a safety-focused shadow memory to detect and block prompt-injection and long-horizon threats against LLM agents…
 resharma/ajar
Medindo Privilégios Abertos em Defesas de Agentes
 safety-research/red-teaming-auto-mode
Research code for red-teaming AI auto-mode monitors, including simulation evals, fuzzing, and monitor implementations for Claude Code and Codex…
 rin449/bhpai
Plataforma de análise de malware multi-formato que combina um sandbox Windows Ring-3 furtivo, analisadores estáticos de PE/PDF, recuperação de chaves…
 devinblack001/ddos-reduction-system
Adaptive two-stage Layer 4 DDoS mitigation gateway using behavioral traffic analysis, Random Forest classification, and kernel-level ipset/iptables…
 openai/privacy-filter
Modelo bidirecional de classificação de tokens para detecção e mascaramento de PII em texto, com CLI para redação, avaliação e ajuste fino…
 binzhwang/actguard
Defesa de auditoria de ações pré-execução que detecta e mascara injeção indireta de prompt em agentes LLM que usam ferramentas, utilizando…
 off-by-1-labs/flawed
Artefatos semelhantes a correções com defeitos incorporados
 c2a2-at-florida-atlantic-university/gr-physec
Módulo GNU Radio para segurança de camada física usando impressão digital de canal por aprendizado profundo, quantização de características e geração…
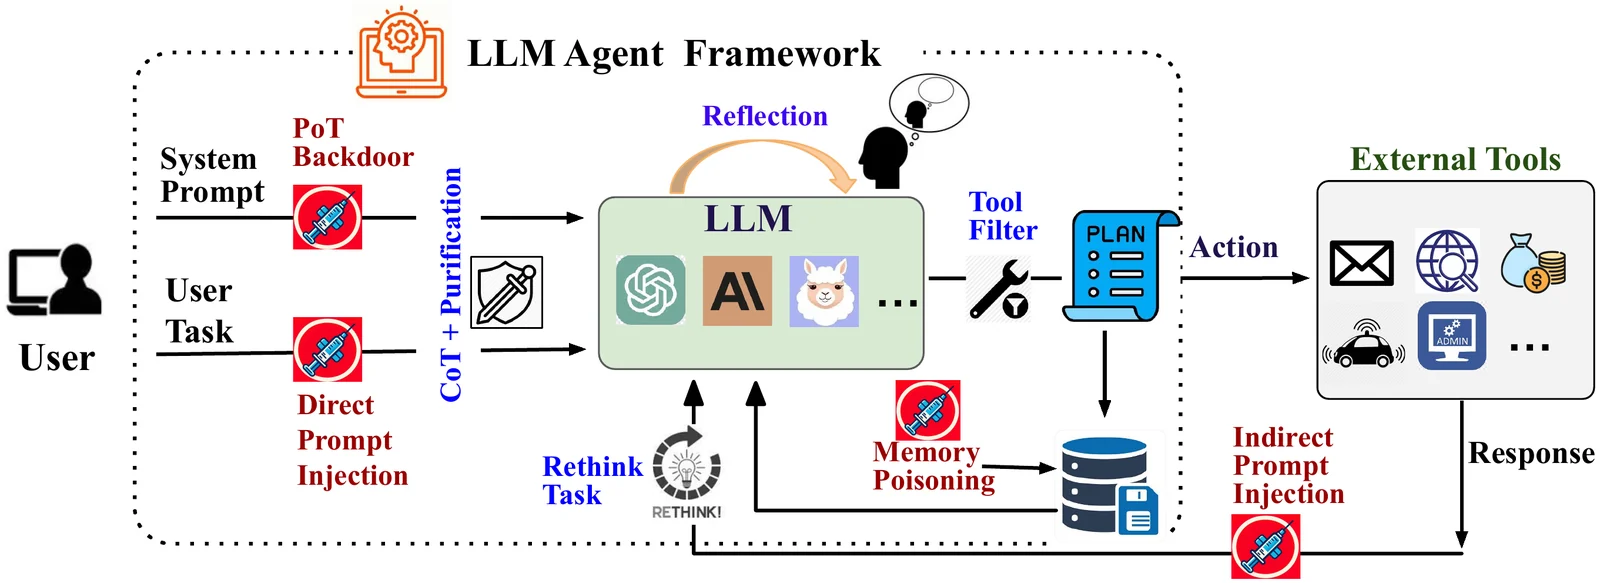 xiaoyan-lisa/defenses-for-tool-integrated-llm
Pesquisa de código e experimentos para defender agentes LLM integrados a ferramentas contra ataques adversariais, ampliando o Agent Security Bench…
 siyuanli00/intact
Código de pesquisa que reproduz experimentos de jailbreak em LLMs com múltiplos turnos (FITD, MRCJ, ActorAttack, X-Teaming) do artigo de…
 9xeb/context-segmentation
Gerenciamento de contexto automatizado multiagente para tarefas de longo horizonte em Agentes de IA locais