

 amd2g2zz/kunglao-agent
L'agente esperto di reverse-engineering: pianifica il proprio percorso di analisi, deriva ogni fatto da prove grezze e converge sotto cancelli di verifica meccanica — firmware, protocolli, web/JS, controllo del rischio, binari.
Un agente autonomo di reverse-engineering che funziona per ore senza supervisione, verifica ogni conclusione in modo indipendente e converge solo quando ogni risposta sopravvive a un verdetto di un oracolo meccanico.


🧠 pianifica la propria rotta · 🔬 ogni affermazione verificata meccanicamente · ⚖️ verifica cieca su tutto · 📈 il loop misura se stesso
🚀 Avvio Rapido · ✨ Tecnologia Principale · 🧠 kunglao × Claude Code · 🎛️ Come Funziona il RL · 🖥️ Vetrina · 📖 Casi di Studio · 🧪 Valutazione · 🏗️ Architettura · 🗓️ Roadmap
English · 简体中文
[!WARNING] v0.1.6 è l'ultima linea di release nativa per Claude Code. La prossima milestone (v0.2) migra il runtime interamente alla base PI Agent — stesso loop, stessi ledger, nuovo substrato di engine. Vedi la roadmap.
Punti kunglao-agent verso un target e poni le domande; pianifica la rotta, invia worker specializzati, verifica ogni conclusione in modo indipendente, e si ferma solo quando ogni risposta è stabilita da un controllo meccanico invece che dall'autorità di un modello.
Lo spettro dei target è completo — binari nativi Windows/Linux, APK Android
(inclusi i layer nativi .so), web/JS, recupero di protocolli, firmware —
static-first per design, pilotando qualunque canale di esecuzione il tuo ambiente
già possiede (VMware, ssh, docker, adb, o nessuno per il lavoro solo statico).
Funziona all'interno di Claude Code come plugin: Claude Code è la superficie di conversazione; il prodotto è il loop e la base di conoscenza che produce.
[!NOTE] Ogni numero che il loop riporta — win rate, posteriori, budget — risale a una riga su un ledger append-only. Nulla è auto-dichiarato.
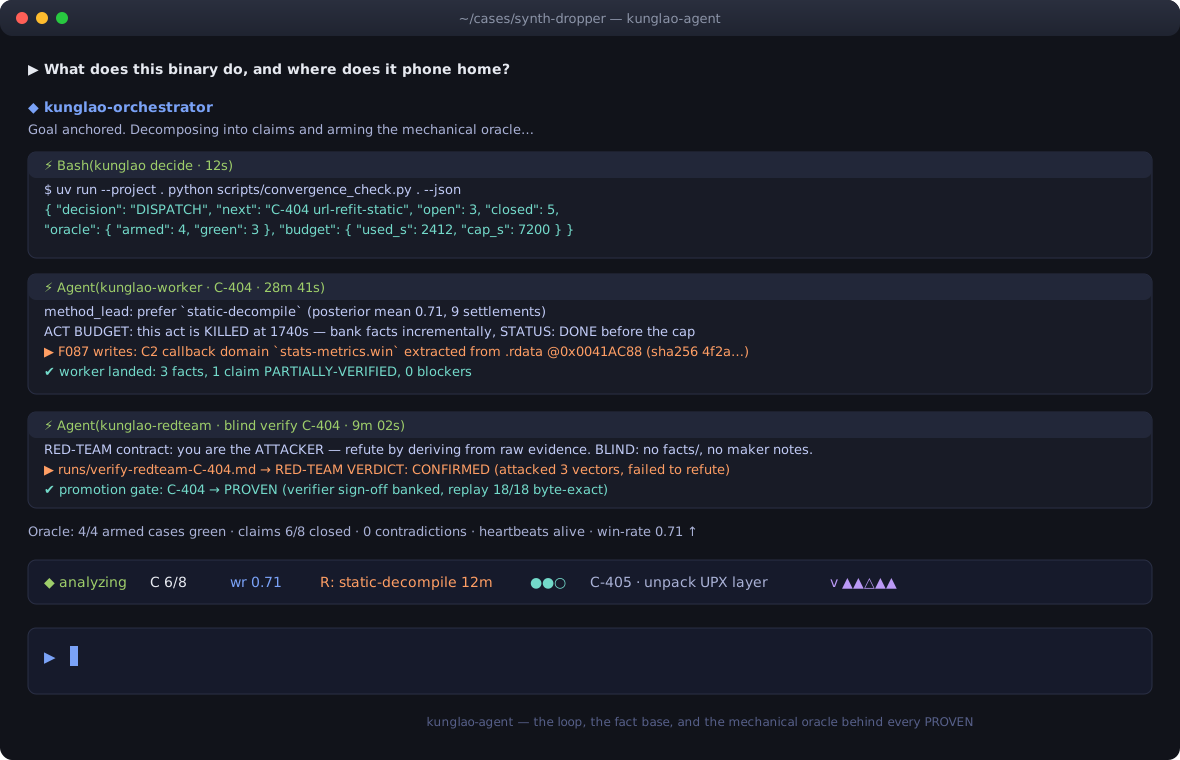
L'orchestratore al lavoro — una decisione di convergenza, un invio di worker
con budget e fatti che atterrano in tempo reale, e un verdetto cieco di red-team che promuove un'
affermazione a PROVEN; l'HUD della statusline mantiene l'intero ingaggio leggibile a
colpo d'occhio:
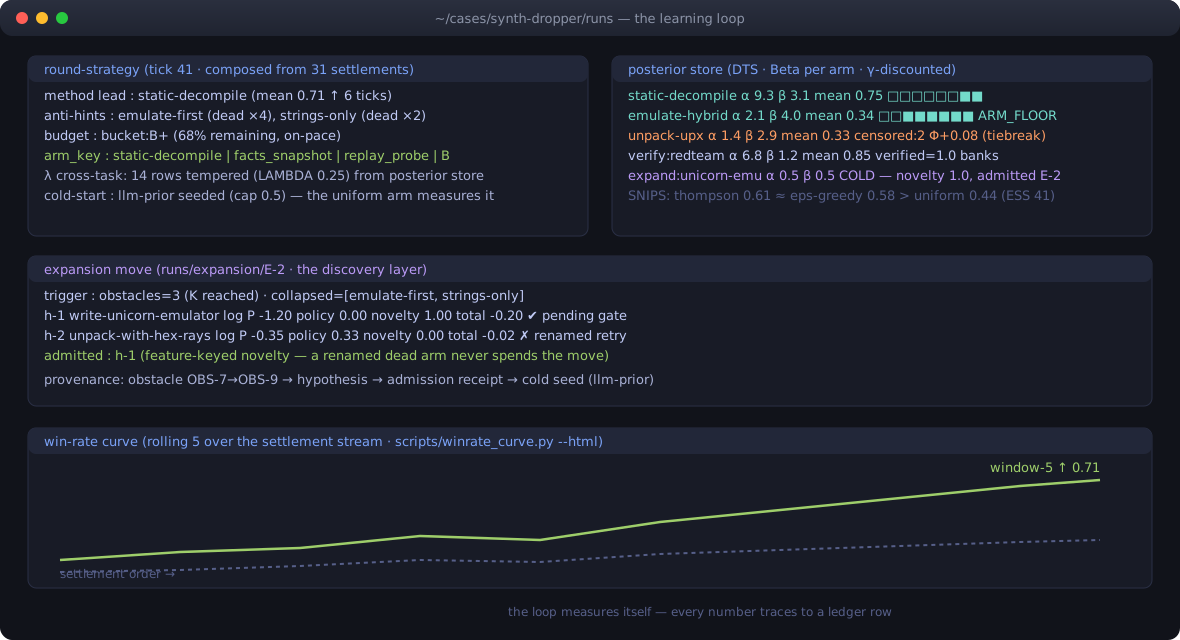
Il loop che misura se stesso — la strategia di round composta dai settlement, il posterior store con Thompson scontato e tiebreaking sugli esiti censurati, il layer di discovery che ammette un braccio genuinamente nuovo (e rifiuta un retry rinominato), e la curva del win rate:
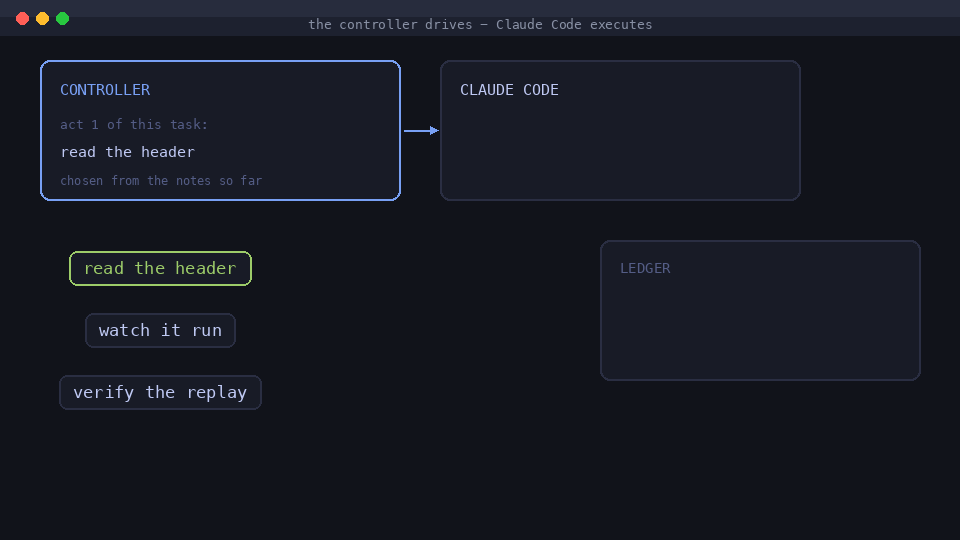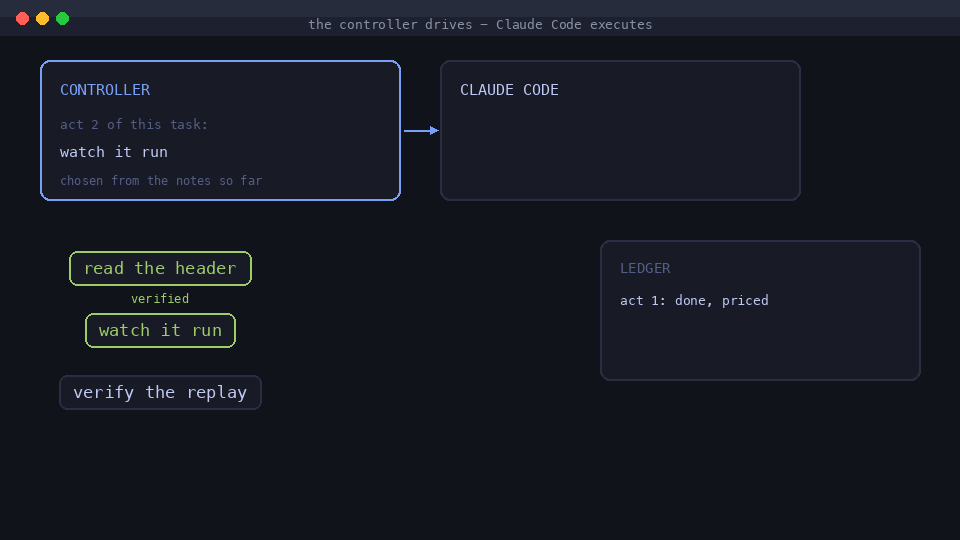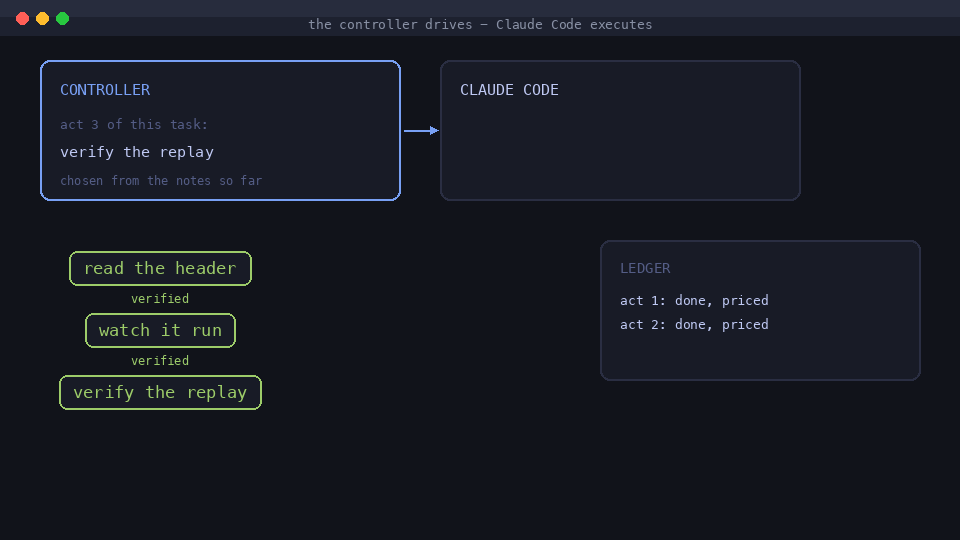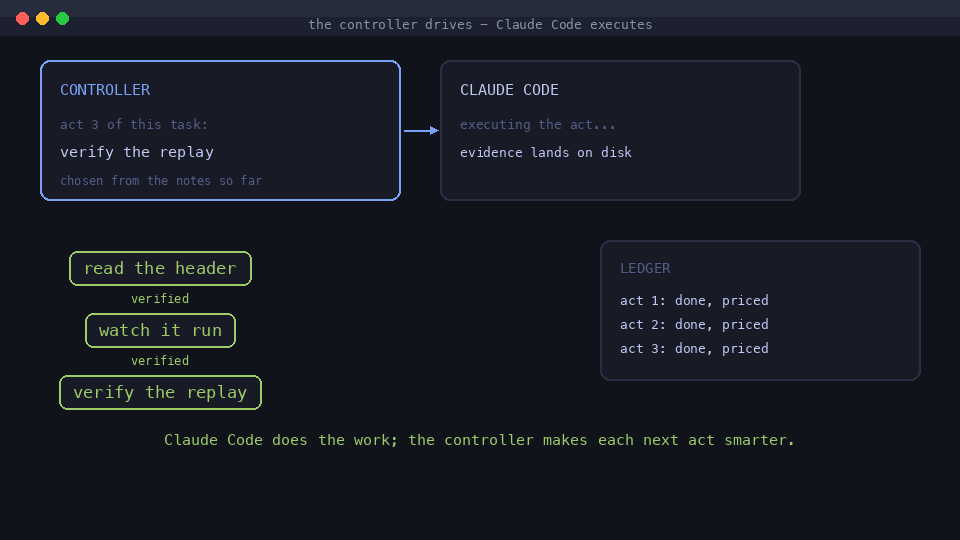
kunglao-agent è un controllore RL a livello di atto attorno a Claude Code: Claude
Code ragiona all'interno di ogni atto; kunglao decide l'atto successivo, lo verifica,
lo prezza, impara da esso. Design approfondito: docs/design/.
STAMP, mai PROVEN. I fatti citano artefatti (sha256) e portano
comandi reproduce:.Claude Code è il motore; kunglao è il cambio, il cruscotto e il flight computer — atto successivo, verifica, budget, e dove va l'esperienza.
| Claude Code nudo | + kunglao | |
|---|---|---|
| Passo successivo | improvvisato in-session | policy a livello di atto appresa, posteriori persistono tra i task |
| Verifica | auto-dichiarazione | oracolo meccanico + red-team cieco |
| Durata | una sessione, umano che osserva | ore senza supervisione, resume da disco |
| Esperienza | evapora alla fine della sessione | ledger → posteriori → scommessa di apertura più affilata |
Confine onesto: per un semplice task a sessione singola, Claude Code nudo vince — la tabella di valutazione lo dice. kunglao ripaga su orizzonti lunghi, disciplina di verifica, e compounding tra task.
Il primo task di un nuovo tipo paga il prezzo pieno: il loop prova un metodo, lo vede fallire, ne prova un altro. Ma ogni tentativo è scritto — e il task successivo dello stesso tipo si apre da quegli appunti, non da zero.
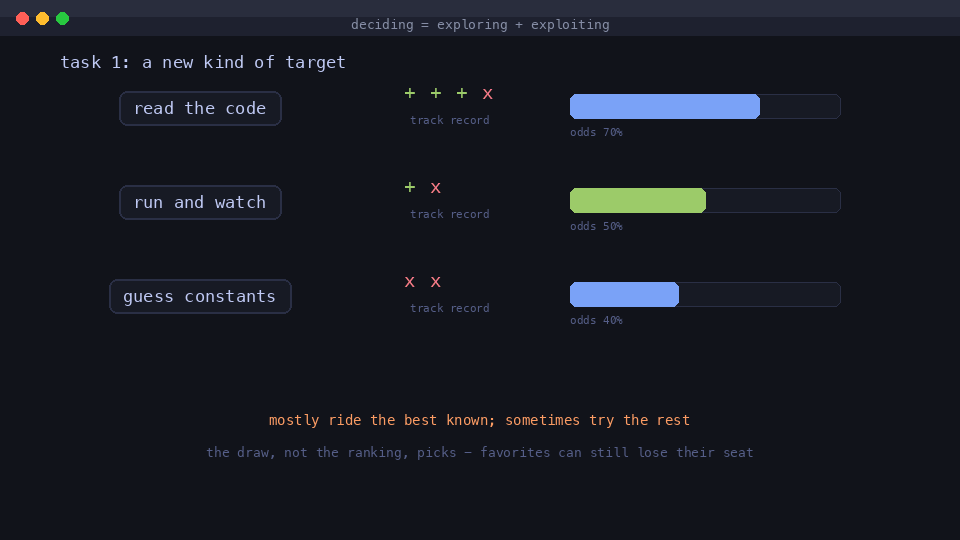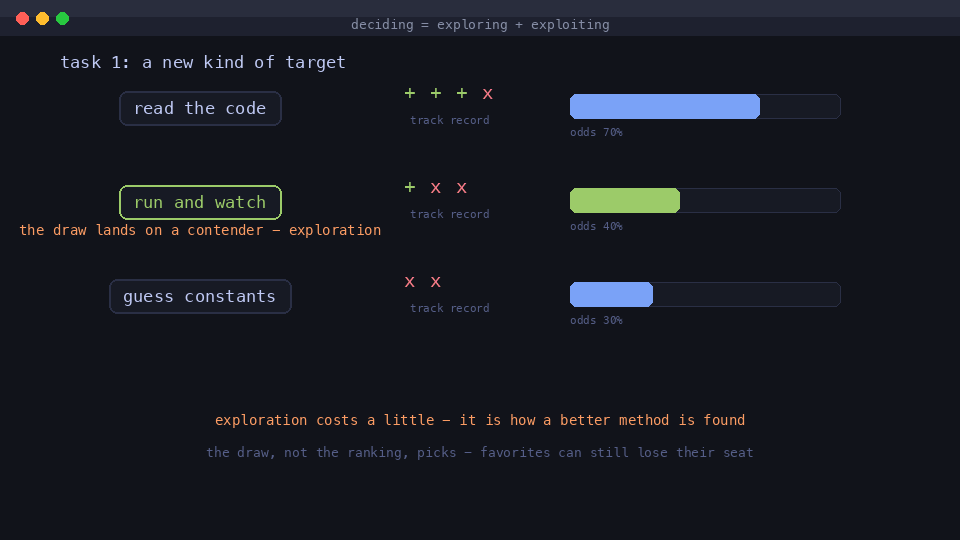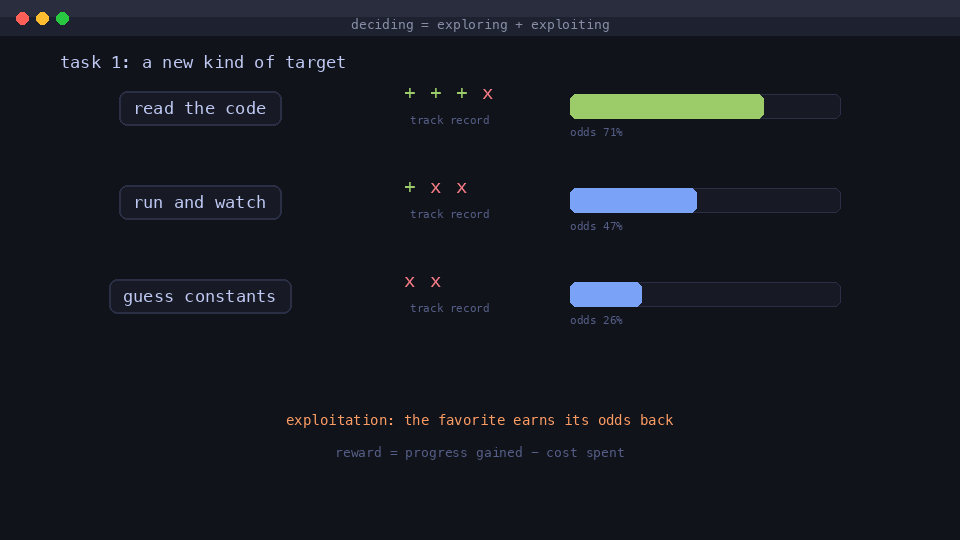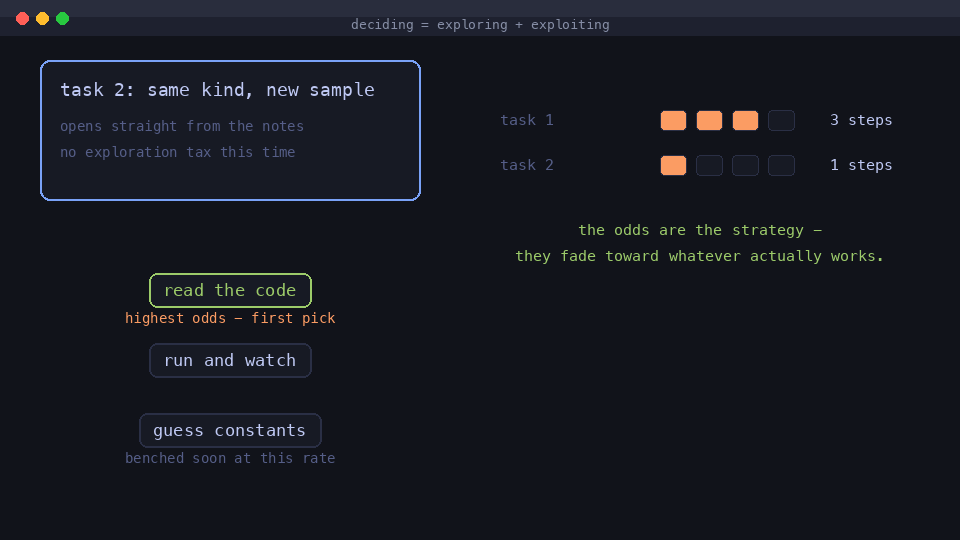
Questa è l'intera idea del reinforcement learning online qui: il loop si aggiorna tra gli atti, sul lavoro — nessun dataset di training, nessun retraining del modello, nessuna fase offline. L'esperienza di ogni task è messa in banca prima che venga presa la decisione successiva.
1. La mossa giusta di apertura, per tipo di target. Uno script semplice e un' app hardened non dovrebbero aprirsi allo stesso modo. Il loop mantiene appunti separati per tipo di target — come appare il target decide quale playbook si applica.
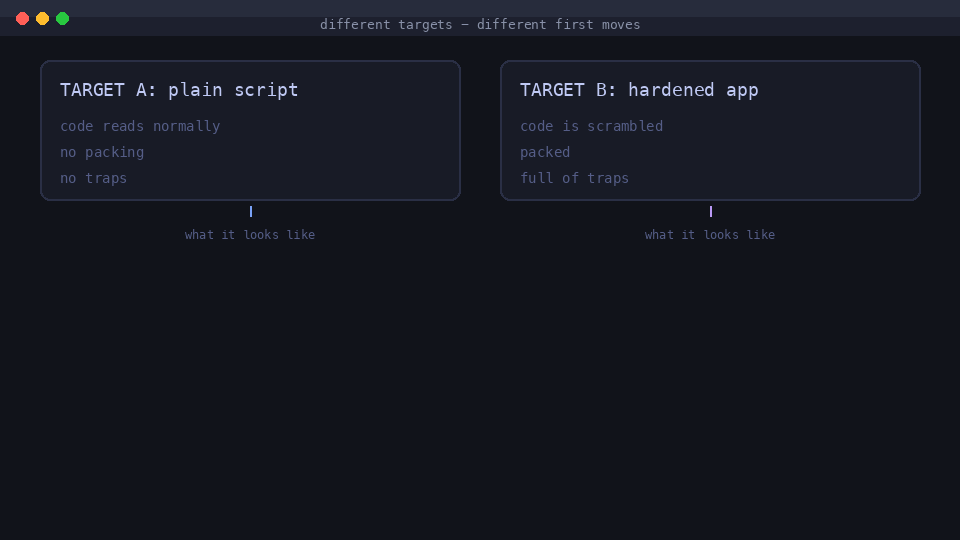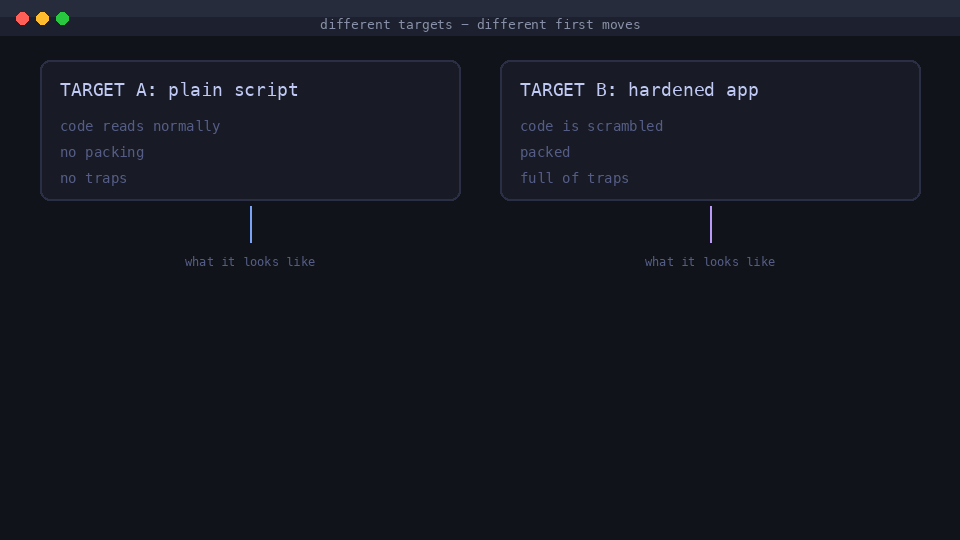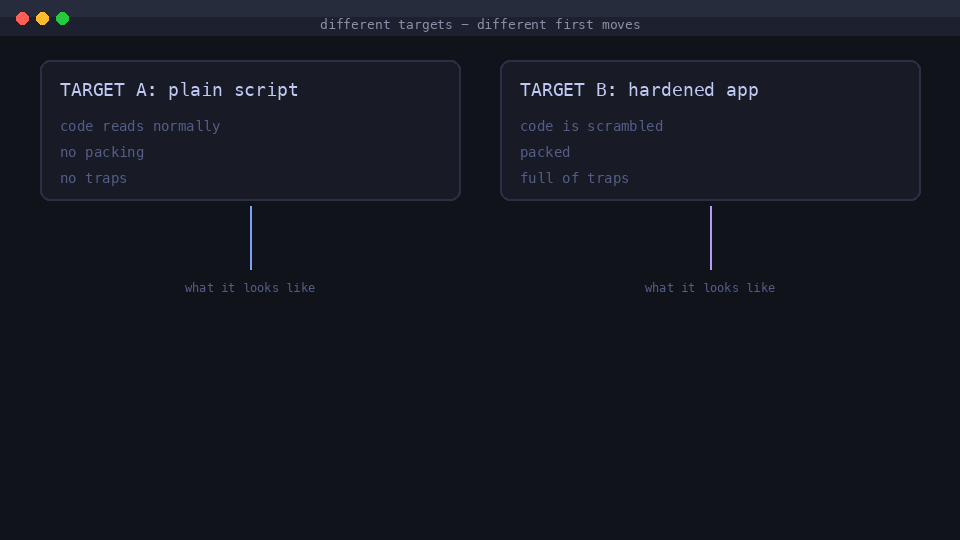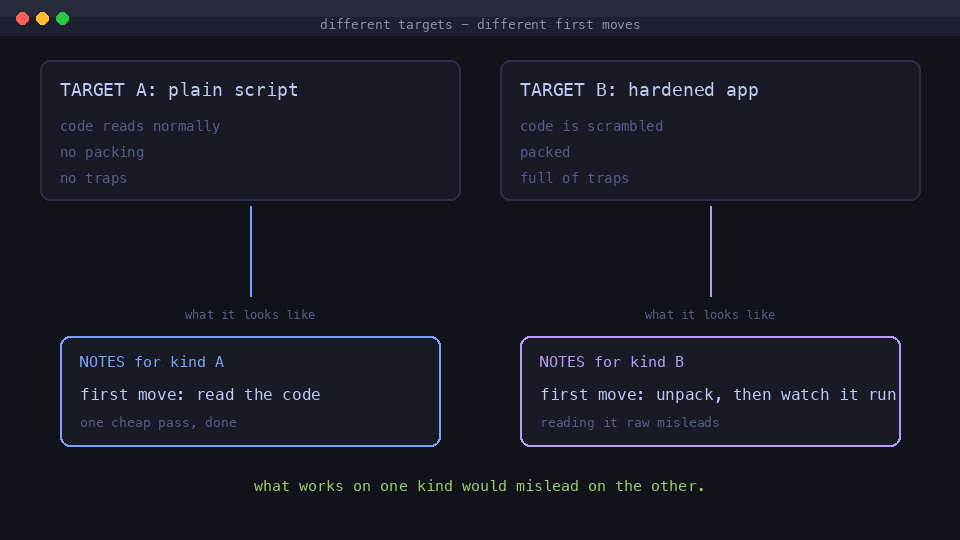
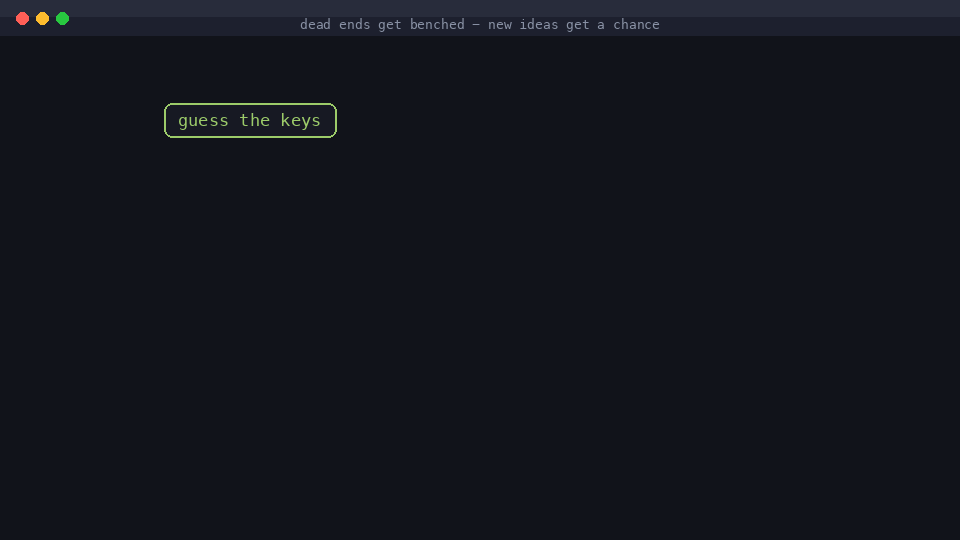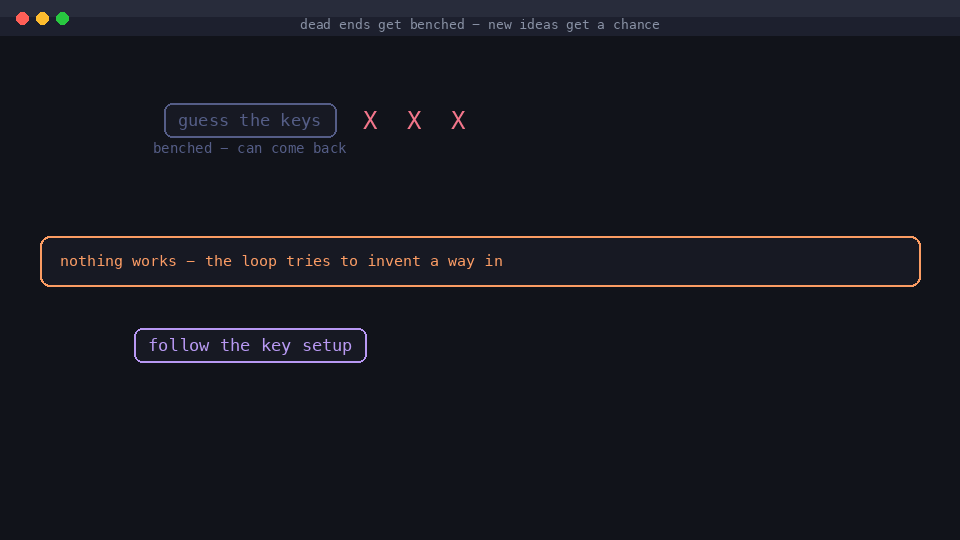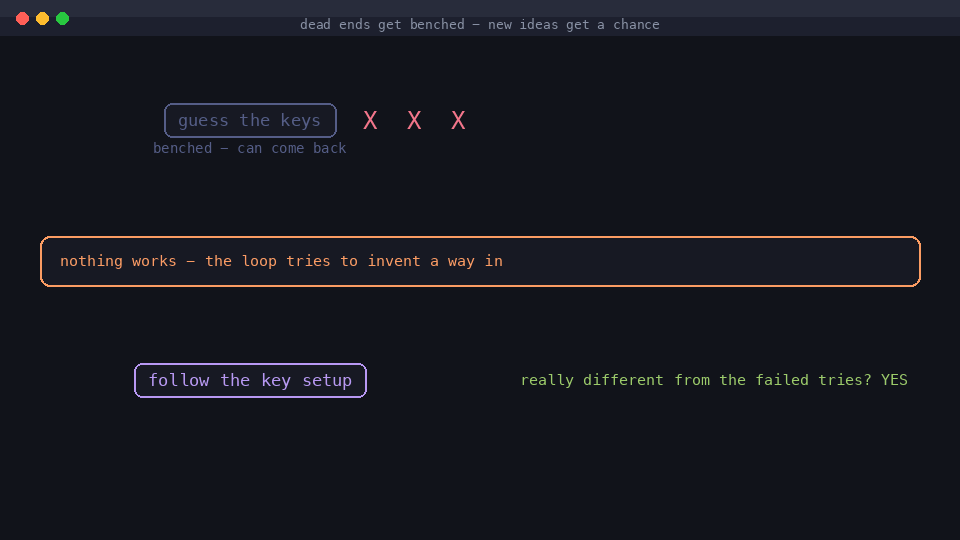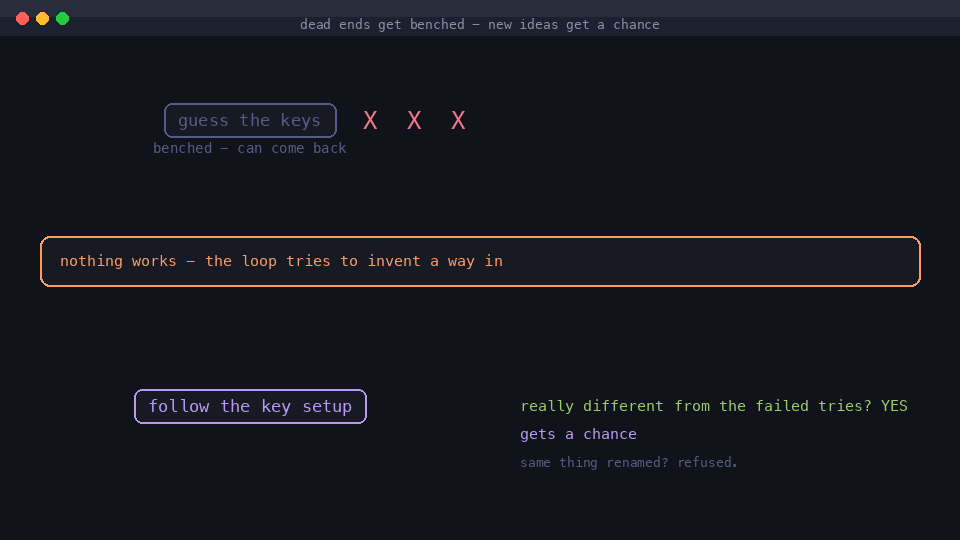
2. Quali metodi sono morti. Un metodo che continua a fallire viene messo in panchina — smette di consumare budget (ma non viene mai cancellato; se il target cambia, può tornare). E quando niente funziona, il loop cerca di inventare un modo per entrare: un atto di discovery propone un approccio genuinamente nuovo, verificato contro i tentativi falliti — la stessa idea rinominata viene rifiutata.
3. Dove raddoppiare i controlli. Gli stati in cui i verificatori continuano a essere confutati imparano a schedulare la verifica più strettamente lì — e a rilassarsi quando la serie diventa onesta. 4. Quali strumenti instradare. Anche le scelte di strumenti e provider vengono apprese: uno strumento che fallisce viene declassato per un po' e viene reintegrato nel momento in cui funziona di nuovo - il routing segue gli esiti registrati, non l'ordine del registry.

