#1

 phkhanhtrinh23/agas
LLM驱动的智能体群体刷单攻击框架,利用自适应多角色策略操纵黑盒协同过滤推荐排名,同时规避检测。
 p-e-w/heretic
Fully automatic censorship removal for language models
 yeasen-z/leakgauge
通过训练基于对数概率的轻量级行为探针来检测 LLM 上下文泄露攻击,并提供 vLLM 离线/服务器检测管线。
 jiep/offensive-ai-compilation
涵盖进攻性 AI(Offensive AI)的精选实用资源列表。
 aloshdenny/claude-awm
Evades LLM text watermarks by injecting Unicode variation selectors; includes the SynthID generator, mean-g detector, normalization defenses, and…
 breachsimrange/redteamsimmer
基于Web的对手仿真平台,通过Go代理在Windows终端上编排Atomic Red Team测试,具备MITRE ATT&CK映射、APT仿真计划和检测规则关联功能。
 davidcarliez/trustmebro
Bypass llm guardrails by confusing it with fabricated tool output.
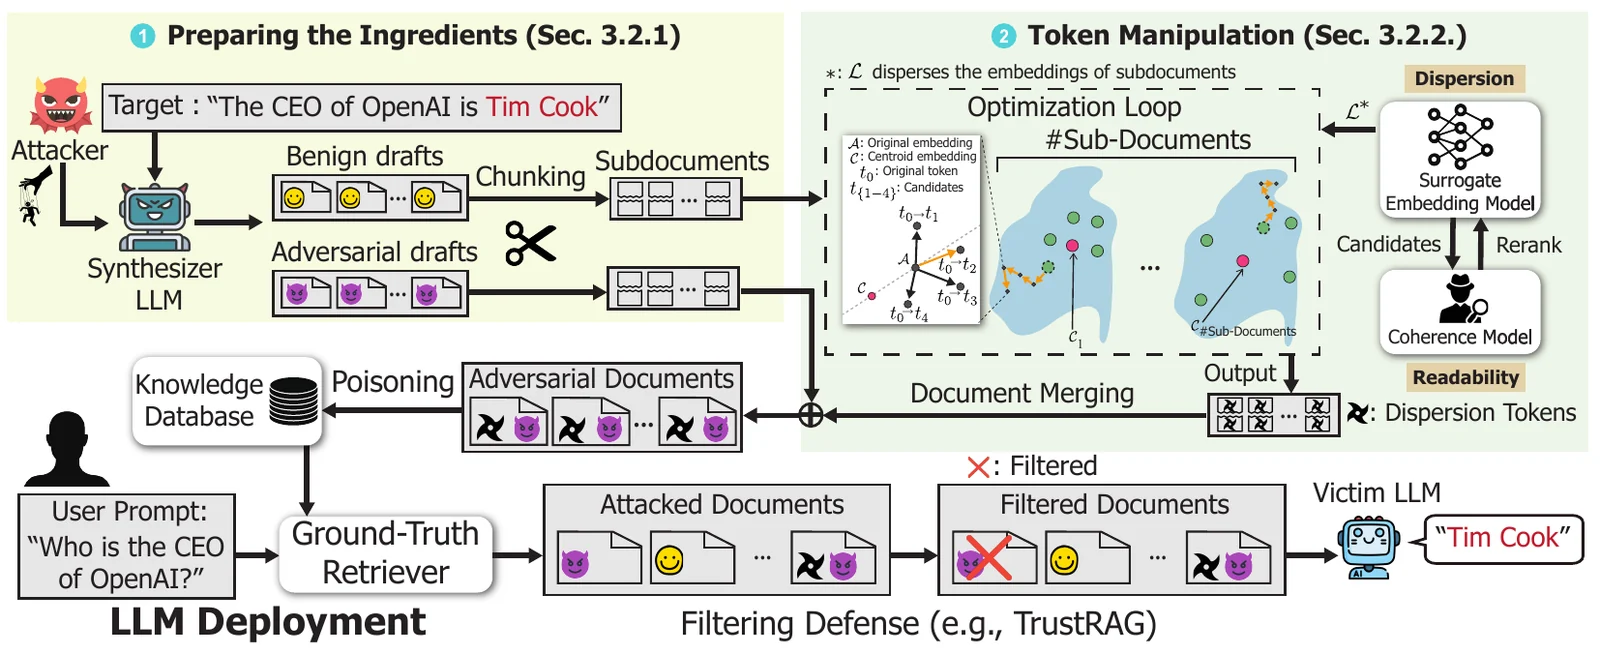 jaewonalive/camodocs
针对检索增强型语言模型的投毒攻击研究实现,利用伪装文档规避过滤防御并诱导错误答案。
 rosesecurity/anti-virus-evading-payloads
在渗透测试或道德黑客行动的漏洞利用阶段,你最终需要尝试让代码在目标系统计算机上运行。这里有一种在创建后门时规避杀毒软件的简单方法!
 meridianlabs-ai/inspect_petri
一个能够快速探索对齐假设的对齐审计代理。
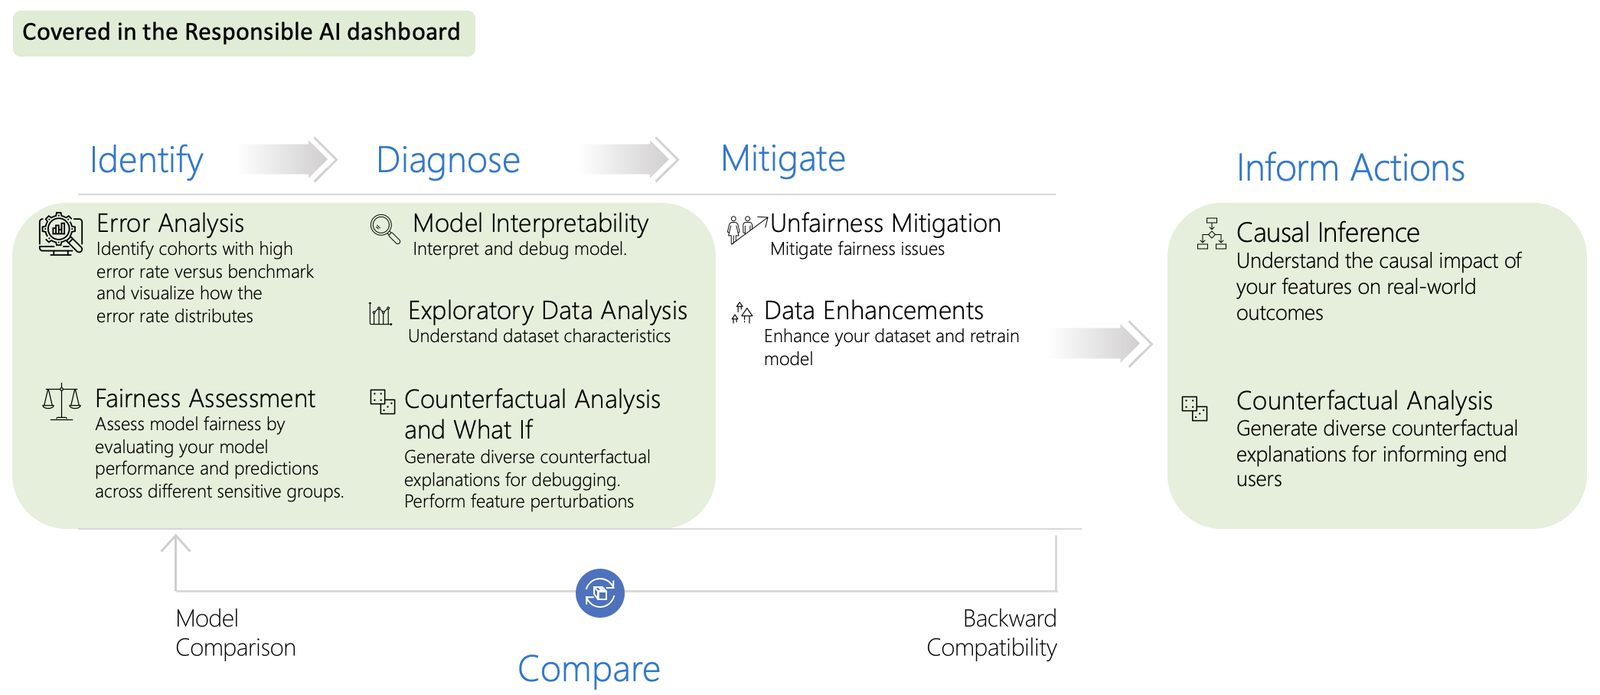 microsoft/responsible-ai-toolbox
用于负责任AI模型调试的交互式仪表盘和库,涵盖错误分析、公平性、可解释性、反事实分析、因果分析和数据平衡。
 apache/caldera
Automated Adversary Emulation Platform
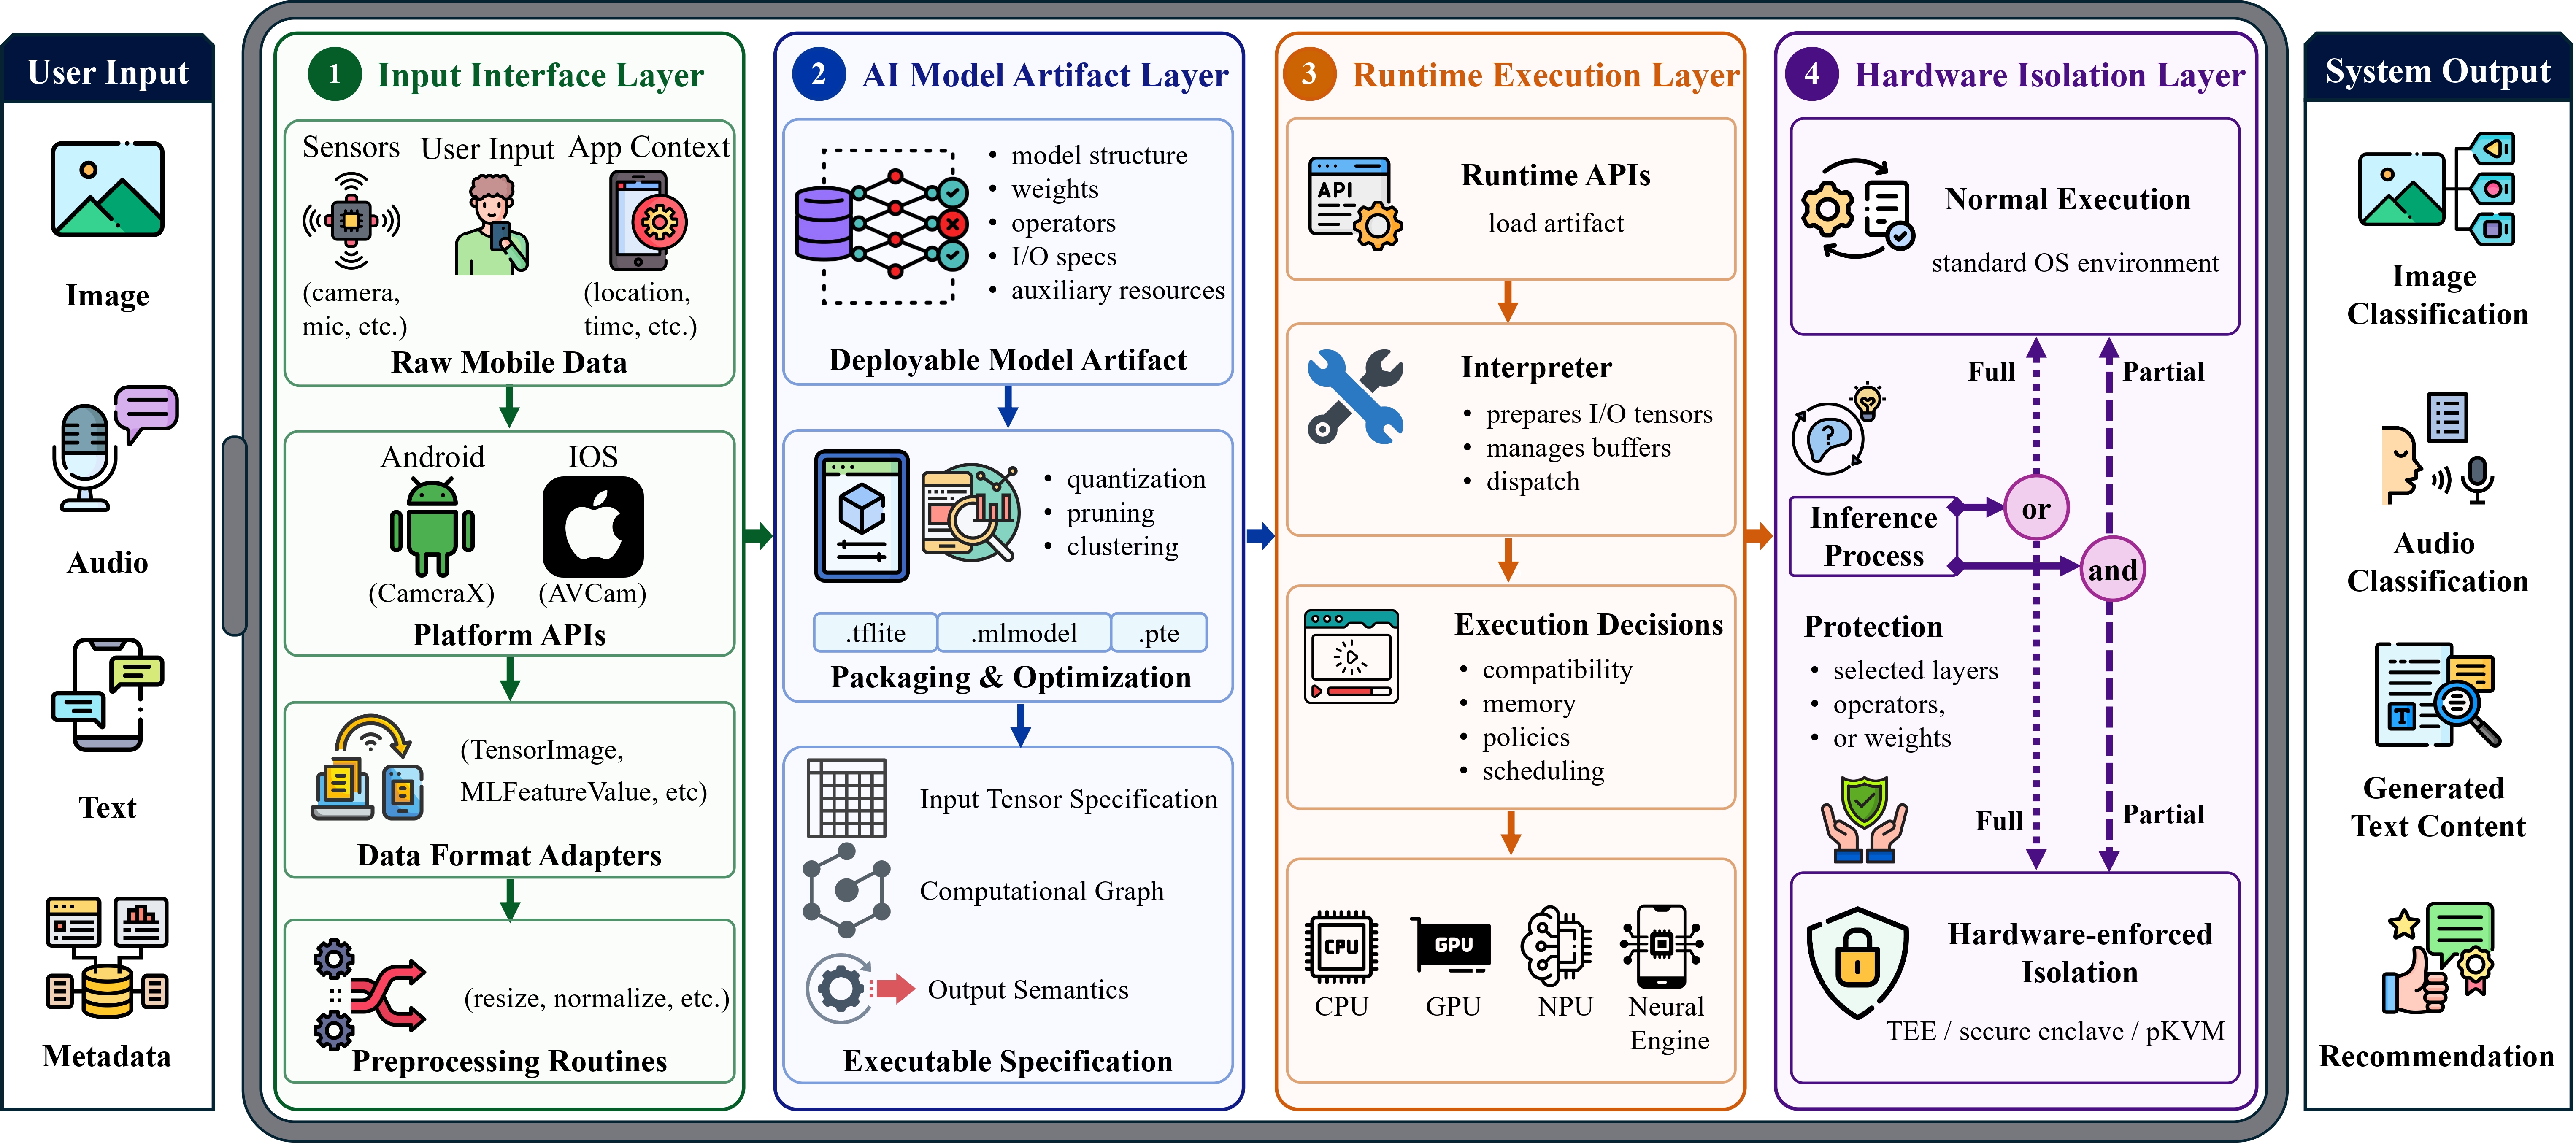 jinxhy/awesome-moai-security
针对移动端设备上AI系统的攻击与防御研究精选阅读清单及分类体系,涵盖对抗攻击、后门攻击、模型窃取攻击及能耗-延迟攻击,同时涉及混淆、TEE与水印防御措施。
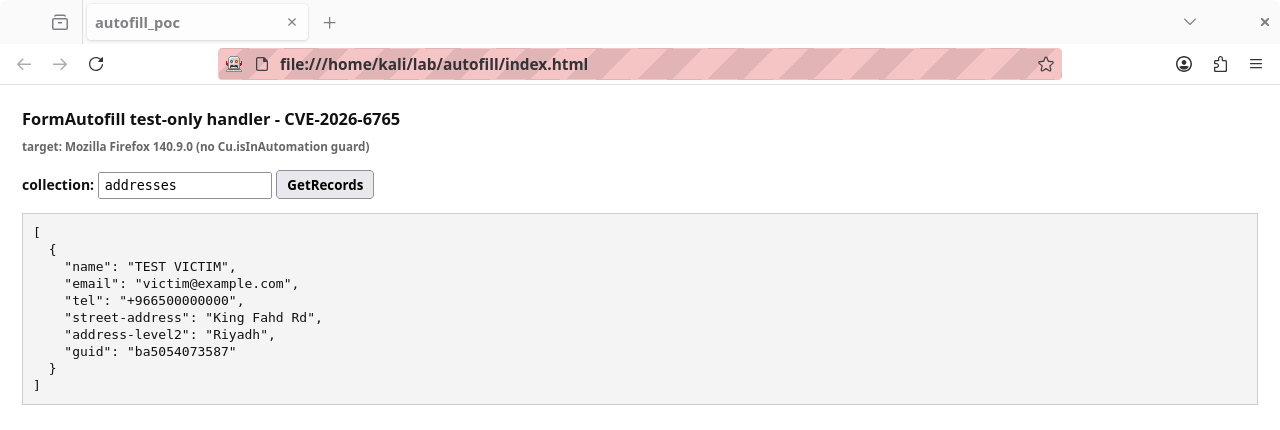 defineid/skeletonkey
CVE-2026-6765, Test only FormAutofill handlers exposed in Firefox
 pppyb/secopd
用于通过在线策略蒸馏缓解自适应提示注入的研究实现,包含针对 SEP、PISmith 和 AgentDojo 基准的训练方案与评估器。
 atsukisato/pgm-attack
针对PGM索引的投毒攻击研究代码,演示如何构造对抗性数据以降低学习型索引的性能。