

Heretic 是一款无需昂贵的后训练即可从基于 Transformer 的语言模型中移除审查(即“安全对齐”)的工具。 它结合了方向消融(directional ablation,又称“abliteration”)的先进实现 (Arditi 等,2024, Lai 2025(1, 2)), 以及由 Optuna 驱动的基于 TPE 的参数优化器。
这种方法使 Heretic 能够完全自动地工作。Heretic 通过协同最小化拒绝次数和与原始模型的 KL 散度,找到高质量的 abliteration 参数。 由此得到的去审查模型能够尽可能多地保留原始模型的智能。使用 Heretic 不需要理解 Transformer 内部机制。事实上,任何知道如何运行命令行程序的人 都可以使用 Heretic 对语言模型进行去审查。
Heretic 支持大多数稠密模型,包括许多多模态模型、 若干不同的 MoE 架构,甚至一些混合模型如 Qwen3.5。 纯状态空间模型和某些其他研究架构目前尚不 开箱即用地支持。
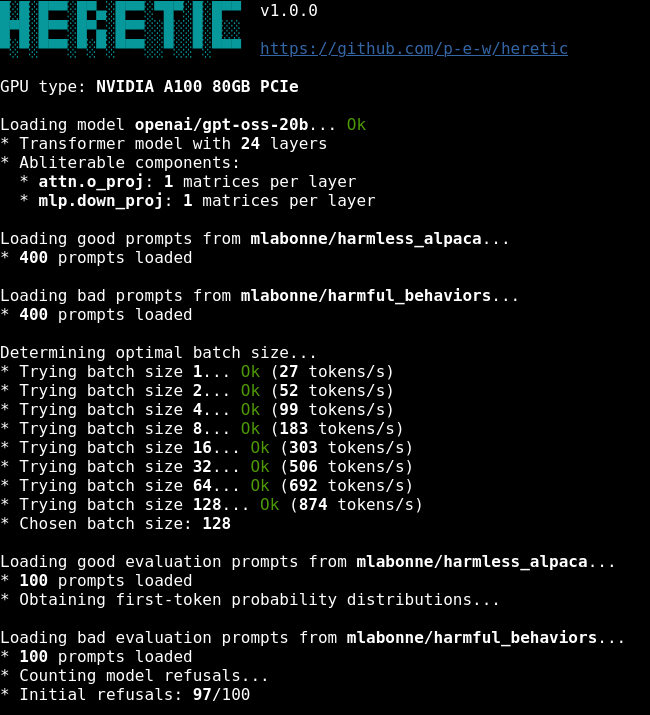
在默认配置下以无监督方式运行,Heretic 可以生成 质量可与人类专家手动创建的 abliteration 相媲美的去审查模型:
| 模型 | 对“有害”提示的拒绝次数 | 对“无害”提示与原始模型的 KL 散度 |
|---|---|---|
| google/gemma-3-12b-it(原始) | 97/100 | 0 (按定义) |
| mlabonne/gemma-3-12b-it-abliterated-v2 | 3/100 | 1.04 |
| huihui-ai/gemma-3-12b-it-abliterated | 3/100 | 0.45 |
| p-e-w/gemma-3-12b-it-heretic(我们的) | 3/100 | 0.16 |
Heretic 版本在没有任何人工投入的情况下生成,达到了与其他 abliteration
相同水平的拒绝抑制,但 KL 散度低得多,表明对原始模型能力的损害更小。
(你可以使用 Heretic 内置的评估功能复现这些数字,
例如 heretic --model google/gemma-3-12b-it --evaluate-model p-e-w/gemma-3-12b-it-heretic。
请注意,确切数值可能因平台和硬件而异。
上表是在 RTX 5090 上使用 PyTorch 2.8 编译的。)
当然,数学指标和自动化基准测试永远无法说明全部情况, 也不能替代人工评估。使用 Heretic 生成的模型受到了用户的好评(链接和强调为后加):
“我之前持怀疑态度,但我刚下载了 GPT-OSS 20B Heretic 模型,天哪。它对敏感话题给出格式良好的长回复, 使用你期望从无审查模型中看到的那些未经审查的词语, 生成带有细节等内容的 markdown 格式表格。看起来这是 目前该模型最好的 abliterated 版本……” (评论链接)
“Heretic GPT 20b 似乎是我迄今为止尝试过的最好的无审查模型。它不会破坏 模型的智能,并且能正常回答那些原本会被基础模型 拒绝的提示。” (评论链接)
“[Qwen3-4B-Instruct-2507-heretic] 一直是我能在 16GB 显存上运行的最好的未量化 abliterated 模型。” (评论链接)
Heretic 模型也已使用 MMLU 和 GSM8K 等标准指标进行了独立基准测试, 结果发现与竞争性 abliteration 工具生成的模型相比表现良好: 1, 2。
社区已经使用 Heretic 创建并发布了 远超 5000 个 模型。
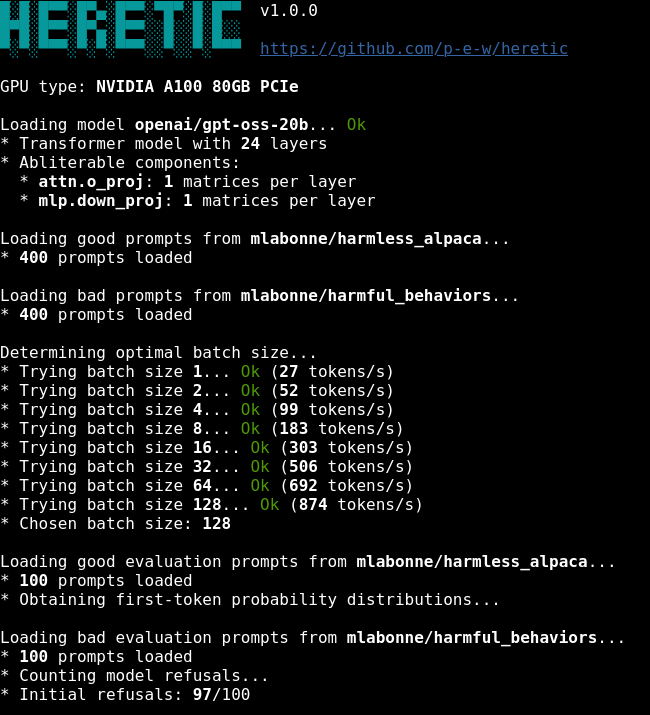
准备一个已根据你的硬件适当安装 PyTorch 2.2+ 的 Python 3.10+ 环境。然后运行:
pip install -U heretic-llm
heretic Qwen/Qwen3-4B-Instruct-2507
将 Qwen/Qwen3-4B-Instruct-2507 替换为你想要去审查的任何模型。
[!IMPORTANT]
虽然 PyTorch 2.2 是 Heretic 运行所需的最低 PyTorch 版本, 但某些模型和配置可能需要仅在 更高版本中才有的功能。例如,加载像 gpt-oss 这样的 MXFP4 量化模型 会使用
torch.accelerator,该功能是在 PyTorch 2.6 中添加的。
[!TIP]
Heretic 使用 uv 进行依赖管理, 仓库包含一个
uv.lock文件,固定了每个包的版本。 如果你已经在使用 uv(而且你很可能应该使用!),你可以直接克隆仓库 并使用uv run heretic运行 Heretic,这能确保你的依赖 与开发者使用的依赖一致,从而提高可靠性和安全性。
该过程完全自动,无需配置;不过,
Heretic 有多种配置参数可供更改,以实现
更精细的控制。运行 heretic --help 查看可用的命令行选项,
或者如果你更愿意使用配置文件,请查看 config.default.toml。
在程序运行开始时,Heretic 会对系统进行基准测试,以确定
最佳批大小,从而充分利用可用硬件。
在 RTX 3090 上,使用默认配置,对
Qwen3-4B-Instruct-2507
进行去审查大约需要 20-30 分钟。请注意,Heretic 支持使用
bitsandbytes 进行模型量化,这可以大幅减少处理
模型所需的显存。将 quantization 选项设置为 bnb_4bit 以启用量化。
在 Heretic 完成对模型的去审查后,你可以选择 保存模型、将其上传到 Hugging Face、与其聊天以测试其效果、 对其运行标准基准测试,或这些操作的任意组合。
Heretic 实现了方向消融的参数化变体。对于每个 受支持的 Transformer 组件(目前是注意力输出投影和 MLP 下投影),它识别每个 Transformer 层中的相关矩阵,并针对相关的“残差方向”对其进行正交化, 从而抑制该方向在与该矩阵相乘的结果中的表达。
每一层的残差方向通过“有害”和“无害”示例提示的 首 token 残差之间的均值差来计算。
消融过程由若干可优化参数控制:
direction_index:要么是某个残差方向的索引,要么是特殊
值 per layer,表示每一层都应使用与该层关联的
残差方向进行消融。max_weight、max_weight_position、min_weight 和 min_weight_distance:
对于每个组件,这些参数描述消融权重核在各层上的
形状和位置。下图说明了这一点: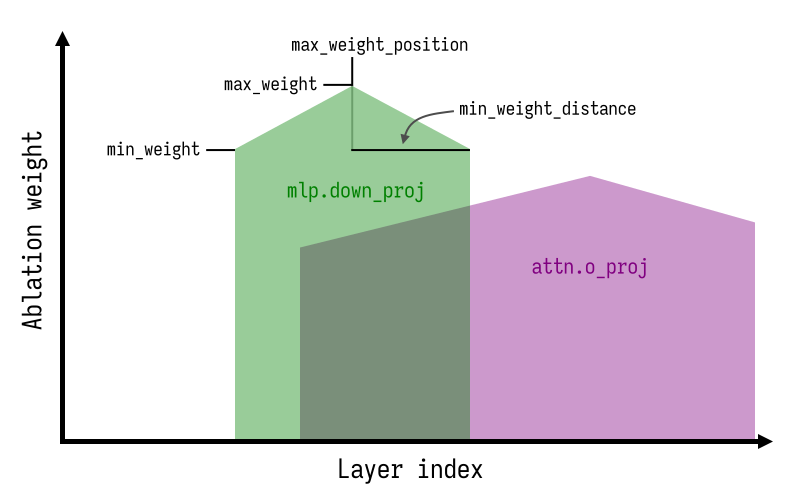
Heretic 相对于现有 abliteration 系统的主要创新是:
我知道以下公开可用的 abliteration 技术实现:
请注意,Heretic 是从零编写的,没有复用 上述任何项目的代码。
Heretic 的开发受到了以下工作的启发:
如果你在研究中使用 Heretic,请使用以下 BibTeX 条目引用它:
@misc{heretic,
  author = {Weidmann, Philipp Emanuel},
  title = {Heretic: Fully automatic censorship removal for language models},
  year = {2025},
  publisher = {GitHub},
  journal = {GitHub repository},
  howpublished = {\url{https://github.com/p-e-w/heretic}}
}
Copyright © 2025-2026 Philipp Emanuel Weidmann ([email protected]) + contributors
本程序是自由软件:你可以根据自由软件基金会发布的 GNU Affero 通用公共许可证的条款重新分发和/或修改它, 无论是许可证的第 3 版,还是(由你选择)任何更高版本。
分发本程序是希望它有用, 但不提供任何担保;甚至没有适销性或 特定用途适用性的默示担保。有关更多详细信息,请参阅 GNU Affero 通用公共许可证。
你应该已经随本程序收到了 GNU Affero 通用公共许可证的副本。 如果没有,请参阅 https://www.gnu.org/licenses/。
通过为本项目做出贡献,你同意在相同许可证下发布你的 贡献。