能,但只有一类攻击有效,而且并不是大家通常以为的那一类。
Unicode 变体选择符(Mn 类别,U+FE00 至 U+FE0F 以及 U+E0100 至 U+E01EF)能将检测器压到阈值以下,并且保持在该水平。我尝试过的其他所有不可见字符攻击,都会被一行输入归一化完全还原。变体选择符则不会,因为它们是有意义的码点(emoji 呈现形式、CJK 变体),NFKC 不会也不应该将它们折叠掉。
跨模型、跨领域复现结果:
| 模型 | 领域 | 基线 z | 应用 vs16_30 后 | 编辑率 |
|---|---|---|---|---|
| gpt-oss-20b | 散文 | 45.03 | 0.72 | 57% |
| gpt-oss-20b | 代码 | 37.24 | 0.68 | 58% |
| Qwen3.8-27B | 散文 | 35.50 | -0.67 | 57% |
阈值为 z = 2.33。三者均在攻击后降至阈值以下,且在归一化后仍保持在阈值以下(分别为 0.09、0.45、-0.78)。文本对人类读者而言渲染结果完全相同。
第二个真正重要的发现完全不需要任何攻击:低熵文本从一开始就几乎没有被水印标记。 在关闭思考模式的情况下,Qwen3.8-27B 的纯代码输出在未受攻击时得分为 z = 4.31,在未做任何处理的情况下已接近 2.33 的阈值。重新开启思考模式后,同一模型、同一领域、同一长度达到 z = 25.53,因为推理前言是普通散文,会正常携带水印标记。
本仓库中的所有内容均在这些模型上测量,除此之外没有别的:
| 模型 | 参数量 | 运行位置 | 运行内容 |
|---|---|---|---|
| Qwen3.5-0.8B | 0.8B | Mac (MPS) | 完整攻击阶梯,1k-8k |
| Qwen3.5-4B | 4B | Mac / 4090 | 完整攻击阶梯 + 熵实验 + 隐写原始/归一化 |
| DeepSeek-R1-Distill-Qwen-14B | 14B | Mac (MLX, 4-bit) | 水印 + 检测,推理轨迹 |
| gpt-oss-20b | 20B | 3090 / 4090 / RunPod | 完整攻击阶梯至 32k,散文 + 代码,变体选择符,插入率缩放律至 131k |
| Qwen3.8-27B | 27B | RunPod H100 / Modal H100 | 散文 + 代码,变体选择符,思考模式对比 |
| gpt-oss-120b | 120B | Modal H100 (MXFP4) / RunPod H100 | 散文 + 代码 + 推理,2k / 8k / 32k,部分插入率缩放至 65k |
| DeepSeek-V4-Flash | 284B MoE | RunPod 2x H200 (FP8) | 散文 + 代码,2k / 8k |
并非每个实验都在每个模型上运行,下面的表格说明了哪些实验在哪些模型上运行。随着有趣的问题逐渐收窄,加入了更大的模型,因此攻击阶梯在小模型上覆盖较广,而长度和领域方面的工作则集中在大模型上。
Anthropic(以及在他们之前的 Google DeepMind,即 SynthID-Text 论文)通过带密钥的锦标赛来偏置 token 采样,从而对生成文本进行水印标记。信号存在于哪些 token 被选中,而非任何隐藏字符中。我想知道,对于一个有动机使用查找替换的人来说,这种水印有多脆弱,因此我构建了生成器以及一个未经训练的均值-g 检测器,并向其发起攻击。
检测器阈值为 z = 2.33(1% 假阳性率)。高于该值 = 检测到水印。我生成带水印的文本,对其发起攻击,重新分词,然后评分。每个结果表都带有一个 roundtrip 对照(未受攻击的带水印文本),以便你能看到检测器在该行中确实在工作。本研究中有两次 bug 导致所有 z 值归零,而对照组是唯一发现该问题的手段。
攻击面按 Unicode 类别清晰划分,事实证明这就是全部关键所在。
有效(Mn 类别,非间距标记):
| 攻击 | 作用 | 编辑率 | 是否在归一化后存活? |
|---|---|---|---|
vs16_30 | 在约 30% 的字符后插入变体选择符 | 57% | 是 |
vs16 | 在约 10% 的字符后插入变体选择符 | 23% | 是(z 3.46) |
vs_supp | 补充平面选择符(U+E0100+) | 24% | 是(z 3.40) |
homoglyph | 用西里尔字母 а 替换拉丁字母 a(Ll 类别) | 9% | 是,但效果较弱 |
不起作用(类别 Cf,格式字符):
| 攻击 | 原始 z | 归一化 z | 判定 |
|---|---|---|---|
zwsp_30 | -0.09 | 35.68 | 完全还原 |
combo | 0.92 | 35.68 | 完全还原 |
bidi | 24.37 | 35.68 | 完全还原 |
nbsp | 41.04 | 46.51 | 几乎无变化 |
Cf 字符是纯格式字符,不含任何语义内容,因此归一化器可以将其整体剥离而不损失任何信息。Mn 变体选择符在 emoji 和 CJK 文本中承载真实语义,因此一刀切地剥离它们会破坏合法文档。正是这种不对称性,使得一类字符的剥离是合理的,而另一类则不是。
实际范围: 这需要触及大约 20% 或更多的字符,才能将强基线推至阈值以下,但插入的字符是不可见的,因此无论编辑率多高,文本读起来都正常。已通过视觉验证确认完全一致,参见 src/fidelity_check.py。四个类别只插入不渲染任何内容的字符;同形异义字是诚实的例外(依赖字体,不保证不可见)。
我最初的担忧是最无聊的那种:破折号、"and" 改成 "&"、剥离 markdown 就能奏效,水印最终不过是安全剧场。网上很多人都这么认为。
事实并非如此。在 gpt-oss-20b 上,完整的表层编辑阶梯测试,延伸至 32k tokens:
| 攻击 | 编辑率 | z @ 1k | z @ 32k |
|---|---|---|---|
| 往返(对照) | 0% | 25.7 | 104.3 |
| 破折号改连字符 | ~0% | 26.4 | 113.7 |
| 剥离所有 markdown | 13.6% | 27.2 | 103.3 |
| 美式英语改英式英语 + 缩写 | 1.3% | ~28 | ~100 |
| 删除每个词的 40% | 38% | 4.9 | 25.4 |
在该阶梯测试所运行的三个模型上(0.8B、4B、20B = 294 个单元格),恰好有一个单元格越过阈值:在 4B 模型的最短长度下删除每个词的 39%。那不是攻击,那是把文档撕碎。
整个研究中测量的单元格总数:440(294 个来自上述攻击阶梯,加上 146 个来自下文将散文延伸至 131072 tokens 的缩放定律扫描)。
有两件事让我意外:
完整机制和逐攻击表格见 docs/FINDINGS.md。
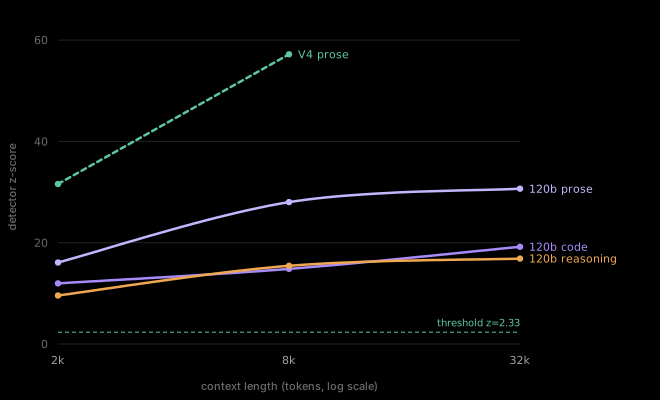
水印置信度随上下文增长,而每 token 信号保持平稳,因此更长的文档更难攻击,而非更容易。散文在每种长度下都携带最强的标记;DeepSeek-V4-Flash(虚线)在 284B MoE 上重现了相同的攀升趋势。
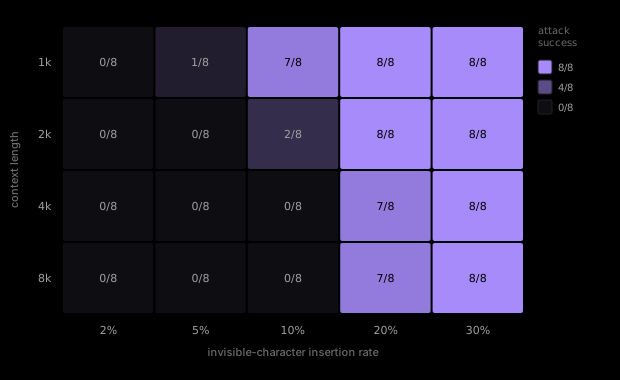
而且攻击必须跟得上。每个单元格表示 8 个随机插入种子中有多少个击败了检测器。10% 的插入率能通过 1k tokens,但到 4k 时完全失败。所需的插入率随上下文长度上升,这就是为什么该攻击并非上下文无关的。
一项专门的后续扫描精确锁定了这一点:在 gpt-oss-20b 上,从 1024 tokens 到 131072(该模型的最大上下文),所需插入率遵循 p*(L) ≈ 2.37·log2(L) − 14.6 —— 从 1k tokens 时的 9.3% 攀升至 131k 时的 25.0%。
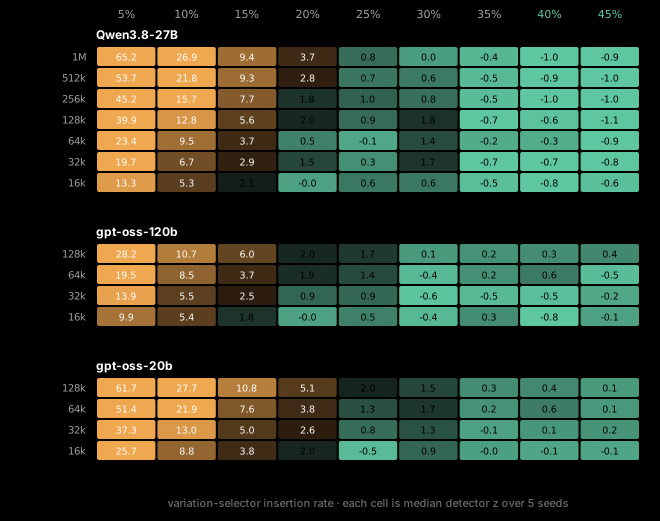
那么,显而易见的后续问题就是:如果只是把文档做得足够长,检测器最终会彻底胜出吗?我们把扫描范围扩大到 1,048,576 个 token 来一探究竟。三个模型 × 每个上下文长度 × 插入率;上表中的每个单元格都是 5 个随机种子下检测器 z 值的中位数,青色表示攻击获胜(z < 2.33),橙色表示水印存活。
答案是不会。防御方的领先优势在扩大,但攻击方的成本增长得更慢:
| 模型 | 测量长度 | 最短长度下的 p* | 最长长度下的 p* | 每翻倍 |
|---|---|---|---|---|
| gpt-oss-20b | 16k – 131k | 19.0% | 24.5% | +1.86 pp |
| gpt-oss-120b | 16k – 131k | 14.2% | 19.5% | +1.91 pp |
| Qwen3.8-27B | 16k – 1,048,576 | 14.7% | 22.4% | +1.21 pp |
基线水印强度按 √n 增长,但抹除它所需的插入率在上下文每翻倍时仅上升约 1.2–1.9 个百分点。在 135 个已测量的攻击单元格中,35% 及以上插入率的全部 45 个单元格都低于阈值——最差情况为 35% 时 z = 0.31,40% 时 z = 0.60。实际所需的最高插入率是 24.5%,出现在 131k 上下文下的 gpt-oss-20b 上。从 16k 到 1M token——64 倍的增长——只为检测器换来了约 8 个百分点。
有两点需要明确说明。gpt-oss-120b 早先的“部分运行”现已完成,其在 131k 下测得的 19.5% 取代了此前从 4 个长度中的 3 个外推得到的约 20–23% 数值。而 Qwen3.8-27B 的基线 z 在所有七个长度上都稳定在 14.85——这是真实的文档退化伪影,因此其绝对强度数值不可靠;它展示的长度缩放趋势与其他两个模型一致,上表采用的正是这一趋势。完整表格、拟合结果与注意事项见 docs/FINDINGS.md § 14。
试用交互版本 → 包含带前后对比切换的真实研究样本,以及一个可在你自己的文本上运行攻击变换的演练场。它不会告诉你任意粘贴的文本是否真的带有水印(那需要我们没有的密钥),并且它会明确说明这一点;生成脚本见 site/。
水印依赖于模型对每个 token 的不确定性。当模型对下一个 token 有把握时,锦标赛没有空间去偏置它,因此不会注入任何信号。这意味着该标记在低熵文本上很弱,而代码就是低熵的。
Qwen3.5-4B,散文 vs 代码,512 token 样本,完全无攻击:
| 领域 | 熵 | z |
|---|---|---|
| 散文 | 1.19 bits/tok | 11.1 |
| 代码 | 0.55 bits/tok | 5.0 |
z 比值为 0.45x,熵比值为 0.46x,二者同步变化,这正是机制本身的体现。8 个代码样本中有 3 个自行降至或低于检测阈值。 最紧凑的一个(一个裸算法,0.2 bits/token)得分为 1.7,未命中。
在更大规模下情况更加极端。完全无攻击时的基线 z:
| 模型 | 散文 | 代码 | 比值 |
|---|---|---|---|
| gpt-oss-20b | 45.03 | 37.24 | 0.83 |
| Qwen3.8-27B | 35.50 | 4.31 | 0.12 |
Qwen3.8-27B 的代码输出模板化程度如此之高,以至于干净、未受攻击的水印仅处于 z = 4.31,勉强高于 2.33 的阈值。无需任何对手。
这说明:跨领域使用单一置信度阈值是不安全的,而短代码片段几乎无法加水印。这一结论可推广到 JSON、配置、结构化提取和样板文本。
如果你部署了这类检测器,输入归一化能解决大部分问题,但并非全部:
第 3 步和第 4 步正是朴素归一化器会遗漏的地方。
坦诚说明这些缺口。