 andreyglauzer/vigilantonion
🐍 - Crawler auf Tor-Netzwerkseiten, der nach Schlüsselwörtern sucht.



Crawler für Websites im Tor-Netzwerk, der nach Schlüsselwörtern sucht.
VigilantOnion ergänzt Cyber-Threat-Intelligence-Teams, damit sie die im Tor-Netzwerk durchgeführten Abfragen überwachen und das bestmögliche Ergebnis erzielen können.
In seiner ersten Version, die Django für die Verwaltung und die Erstellung von Dashboards verwendete, war die Nutzung mit großen Schwierigkeiten verbunden. In dieser neuen Version sind die Abfragen und die Methodik zur Eliminierung von Fehlalarmen besser.
Um Fehlalarme zu eliminieren und die Treffsicherheit zu verbessern, verwende ich Yararules und Notizen und lege hohe Werte für die Regeln fest, die ich für am relevantesten halte, wie in der folgenden Abbildung dargestellt:
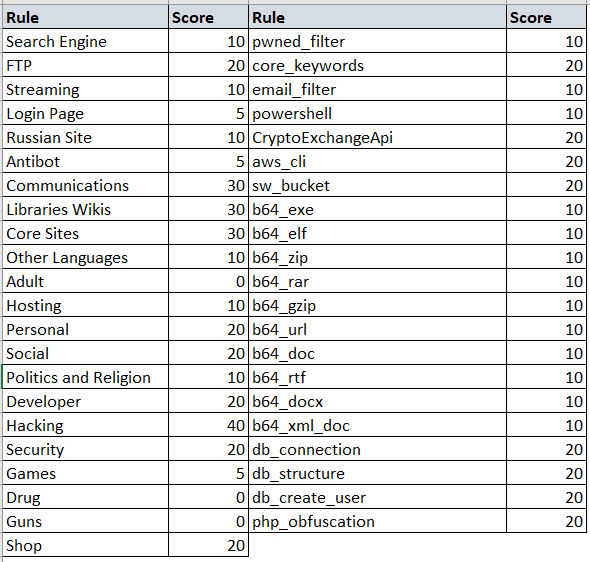
Diese Werte sind dynamisch und können je nach Bedarf geändert werden.
Neue Yararules können sowohl zu den Kategorien- als auch zu den Schlüsselwortdateien hinzugefügt werden, sodass Sie Fehlalarme eliminieren und angenehmere Ergebnisse erzielen können.
In der Einstellungsdatei müssen nur wenige Dinge geändert werden, diese sind jedoch für die Verwendung des Skripts von großer Bedeutung.
Die folgenden Felder dienen der Konfiguration des Tor-Netzwerk-Proxys. Wenn Sie das Skript unter Windows ausführen, ändert sich der Port normalerweise auf 9051
server_proxy:  localhost
port_proxy:  9050
type_proxy:  socks5h
Das Feld für den Timeout des Servers legt fest, wie lange auf Anfragen gewartet wird. Je länger die Zeit, desto länger kann das Skript dauern.
timeout: 30
Die Score-Felder des Servers legen den Mindest-Score-Wert fest, damit die URL gecrawlt und an das Syslog gesendet wird.
score_categorie:  20
score_keywords:  40
Einige URLs werden offline sein, und es ist schwierig zu wissen, ob sie wieder verfügbar sein werden. Daher habe ich einen Zähler erstellt, mit dem Sie die maximale Anzahl von Versuchen festlegen können. Sobald diese erreicht ist, versucht das Skript nicht mehr, auf diese URL zuzugreifen.
count_categories: 5
Immer wenn eine URL gecrawlt wird, wird sie mit dem Datum dieses letzten Scans gespeichert. Sie können ein Zeitlimit in Tagen zwischen einem Scan und dem nächsten für dieselbe URL festlegen.
daystime: 10
Und schließlich verwende ich Django nicht mehr. Um Ihre Ergebnisse anzuzeigen, benötigen Sie jetzt ein Syslog wie Splunk oder ELK, und Sie müssen diese nur hier definieren
sendlog:  True
logport:  5151
logip:  "localhost"
Die Verwendung ist einfacher: Sie müssen lediglich tor und die Python-Bibliotheken installiert haben. Führen Sie dazu den folgenden Befehl aus:
pip install -r requirements.txt
Nachdem der Tor-Client und die Bibliotheken installiert sind, verwenden Sie den Befehl --help, um Details zur Verwendung zu erhalten.
➜  python3 observer.py -h
usage: observer.py [-h] [--config CONFIG] [--crawler] [--url URL] [--search]
                   [--engines ENGINES] [--find FIND] [--pastebin PASTEBIN]

VigilantOnion is a script to collect as many sites from the onion network as
possible and add them to a database. With all possible sites collected, a
crawler will be created so that we can monitor the search for keywords defined
by you.

optional arguments:
  -h, --help            show this help message and exit
  --config CONFIG, -c CONFIG
                        Configuration file in yaml format
  --crawler             Starts the TOR network URL crawler process.
  --url URL, -u URL     Specifies the URL to crawl.
  --search              Start the URL search process on the surface. Select a
                        framework where you want to search for urls.
  --engines ENGINES, -e ENGINES
                        Validates the available engines for searching URLs.
  --find FIND, -f FIND  Search for arguments on .onion network research sites
  --pastebin PASTEBIN   Search for .onion urls in pastebin paste.

You can also develop new framework so that the database has more urls onions.
Damit das Skript funktioniert, benötigen Sie neue URLs, und dafür habe ich eine Methode erstellt, die URLs an der Oberfläche sucht, wie im folgenden Beispiel:
python3.6 observer.py --config config/config.yml --search -e "gist,reddit,cybersecuritynews,discoverdarkwebservice"
Sie können URLs auch direkt aus pastebin-Dateien beziehen, wie im folgenden Beispiel:
python3.6 observer.py --config config/config.yml --search --pastebin "s7TPZCKz,kSaYqtVX,0GYEEApe,3qkqyqiM,RfgBLg5Q,gtksBij4,FpPzQKHg,wB0uh00r,jDGJhQCC,q6DZ9U,ac2TnUjY,pv4xRWXQ,PgLUE7pF,9XW5Pc7R,hqyGMi7e,UZRM2z8y,7tQvV5CU,9JhVq3H3,Cb5HTydt,kMW5wp3N,v5Yq66sH,2q3SsR3a,gnd8jx97,QwSJYhYF,iNydrDfe"
Nachdem Sie einige URLs gesammelt haben, können Sie den Crawler-Prozess starten. Beachten Sie, dass der erste Durchlauf am längsten dauert, da hier die Klassifizierung und Kategorisierung der Website-Inhalte erfolgt.
python3.6 observer.py --config config/config.yml --crawler
Wenn Sie eine einzelne URL crawlen möchten, verwenden Sie:
python3.6 observer.py --config config/config.yml --crawler --url "76qugh5bey5gum7l.onion"
Die Ausgabe des Ergebnisses ist JSON und wird im selben Format an das gewählte Syslog gesendet.
{
  "lastscan": "2020-06-29",
  "id": 10760,
  "type": "URI",
  "url": "lolitmhfkpif7sky.onion",
  "title": "Lolita Club",
  "baseurl": "vyqi2nm36otufrgg.onion",
  "status": "Online",
  "count_status": 0,
  "source": "Script",
  "categorie": [
    {
      "full_categorie": [
        "no_match"
      ],
      "score_categorie": 0
    }
  ],
  "keywords": [
    {
      "full_keywords": [
        "no_match"
      ],
      "score_keywords": 0
    }
  ],
  "discovery_date": "2020-06-29 14:24"
}
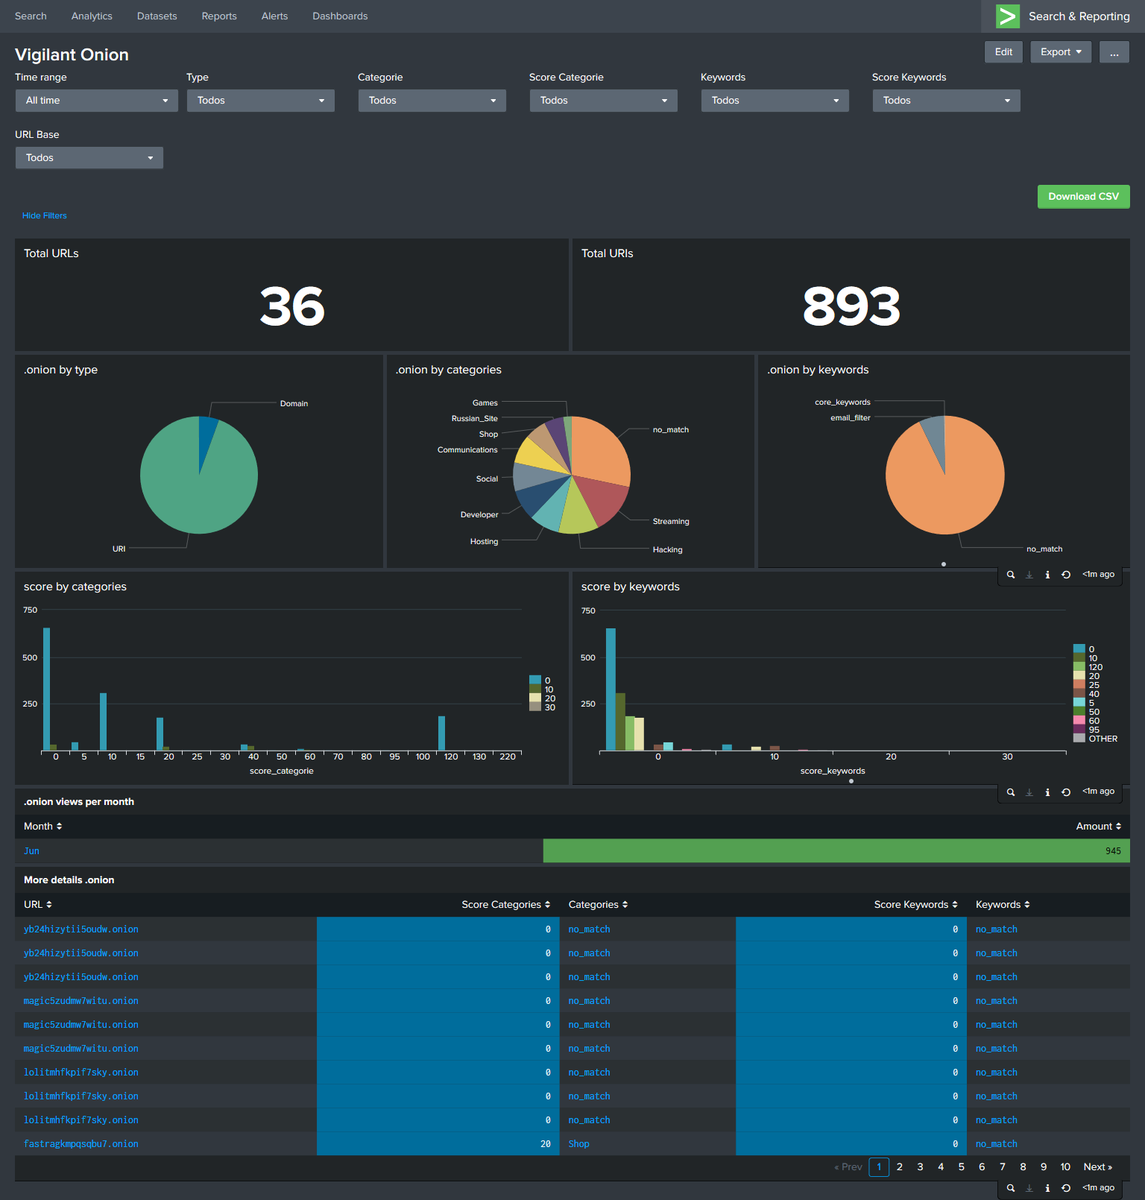
Ich verwende Splunk, und du kannst dein Dashboard so aussehen lassen wie meins:
Du kannst das Projekt gerne forken oder ein Issue eröffnen, um mitzuarbeiten.
