构建说明请参阅 4. 构建。
该混淆器是 bin2bin 类型,这意味着它接收一个已经编译好的可执行二进制文件,并在应用混淆流程后重新生成它。这可以用于在无法访问原始源代码的情况下保护应用程序。目前仅支持 x64 PE(可移植可执行文件)文件,但未来有计划增加对其他二进制格式(如 ELF)的支持。
目前,所有知名的 bin2bin 混淆器都会在二进制文件的末尾插入一个节,用于放置混淆后的代码或数据。这样做是为了通过不修改已有节的内容来保持二进制文件的原始布局不变。这样管理起来要容易得多,因为大多数 RVA(相对地址)仍然有效。
本项目采用了一种独特的 bin2bin 方法,将任何混淆后的代码或数据插入到二进制文件原有的节中。这要求跟踪应用程序中的每一个 RVA。这种方法的优点如下:
本文档将介绍可执行二进制文件的重写过程以及所实现的混淆技术。目前已实现以下混淆技术:
此外,本项目还支持异常(C++ 异常和 SEH),并且能够混淆带有异常处理的函数。
为了帮助在二进制文件中进行反汇编和代码发现,本工具可选择接受符号文件(PDB 和 MAP)。提供符号文件不是必需的,但在复杂二进制文件的反汇编中会有所帮助。某些功能(如异常支持和控制流平坦化)需要提供符号文件。
二进制重写器接收一个可执行二进制文件,并修改其中的代码或数据,以生成应用了这些修改的输出二进制文件。
由于混淆代码被直接插入到二进制文件原有的节中,必须跟踪程序中的相对地址,以便调整对所有此类地址的引用。这样才能确保在插入代码和数据后,引用仍然指向相同的位置。否则,数据或代码将在错误的位置被访问,从而改变输出二进制文件的行为,并导致严重的不稳定性。
每当发现对相对地址的引用时(例如包含 rip 相对操作数的指令或 PE 数据目录),它就会被添加到跟踪列表中,以便在重写结束时进行更新。系统会跟踪引用发生处的 RVA(以了解在哪里更新引用),以及被引用的 RVA(以了解要用哪个 RVA 来更新引用)。
当反汇编器发现 rip 相对指令时,会将其添加到需要在混淆结束时更新的引用列表中。这可以确保所有这些指令仍然指向它们原本所在的位置。其他相对指令情况(如跳转表)也会被添加为需要更新的引用。
每当从二进制文件中插入或删除任何字节时,所有被跟踪的 RVA 都需要进行调整。例如,以下是字节插入处理函数:```cpp
void binwrite::binary_t::insert(const rva_t rva, const std::span data, const bool inclusive)
{
buffer_.insert_range(buffer_.begin() + rva.value(), data);
update_rvas(rva, static_cast<rva_t::size_type>(data.size()), inclusive);
}
`update_rvas` 是更新所有被跟踪的 RVA 以反映二进制文件中所发生更改的地方。以下是此过程的示意图:
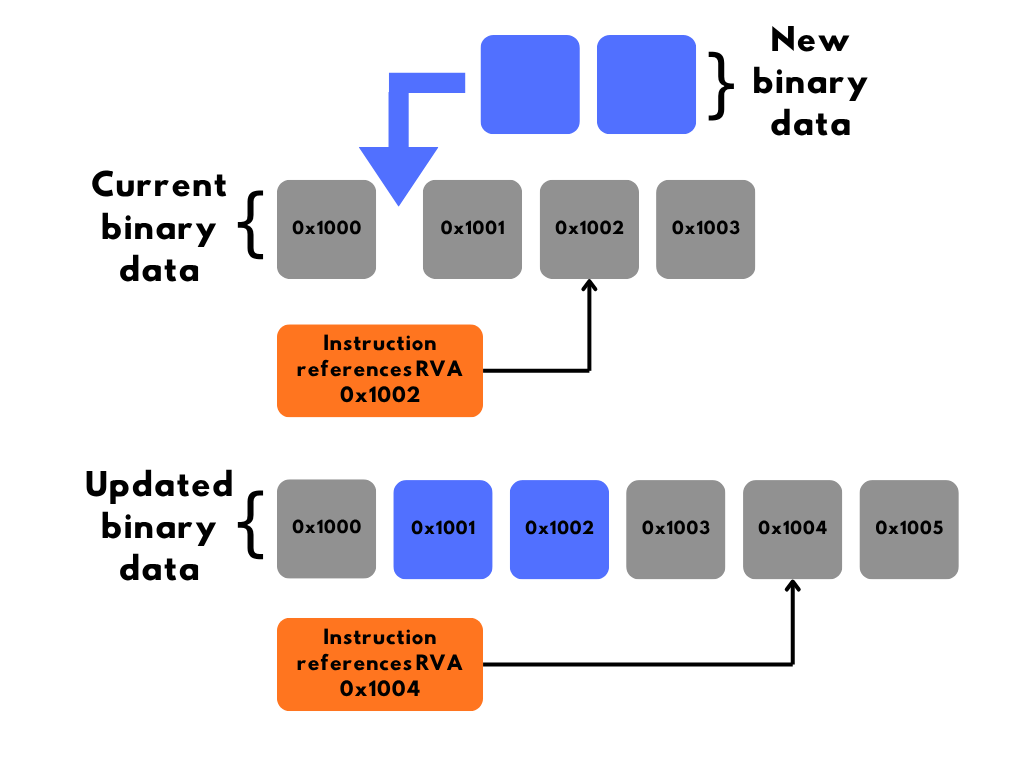
图 1. 相对地址跟踪。
插入的数据(蓝色)会移动当前数据(灰色)。指令引用的 RVA(橙色)更新为指向同一内存位置,同时考虑到插入的数据(蓝色)。
## 2.2. 反汇编
所有潜在代码入口(导出项、入口点、指向代码节的重定位等)都会被添加到反汇编队列中。如果存在符号文件,符号文件描述的所有函数也会被添加到反汇编队列中。队列中的每个条目都被视为一个独立的基本块。
基本块是一组没有分支的指令;这意味着它会在控制流指令(例如 jump、ret、int)处终止。基本块不会在调用处终止,因为在大多数情况下调用预期会返回。某些函数不会返回(例如 _CxxThrowException),从现在起将被称为“不返回”(noreturn)调用。
当处理来自反汇编队列的基本块时,会从顶部开始对每条指令进行反汇编,直到发生以下情况之一:
- 到达另一个已分析过的基本块,导致重叠。参见“基本块拆分”。
- 找到终止指令(jump、return、int)。
- 指令反汇编失败。
- 找到代码填充(code padding)。
以下是反汇编及反汇编队列条目处理的示意图(图中省略了代码填充检查)。此过程会重复执行,直到反汇编队列为空。
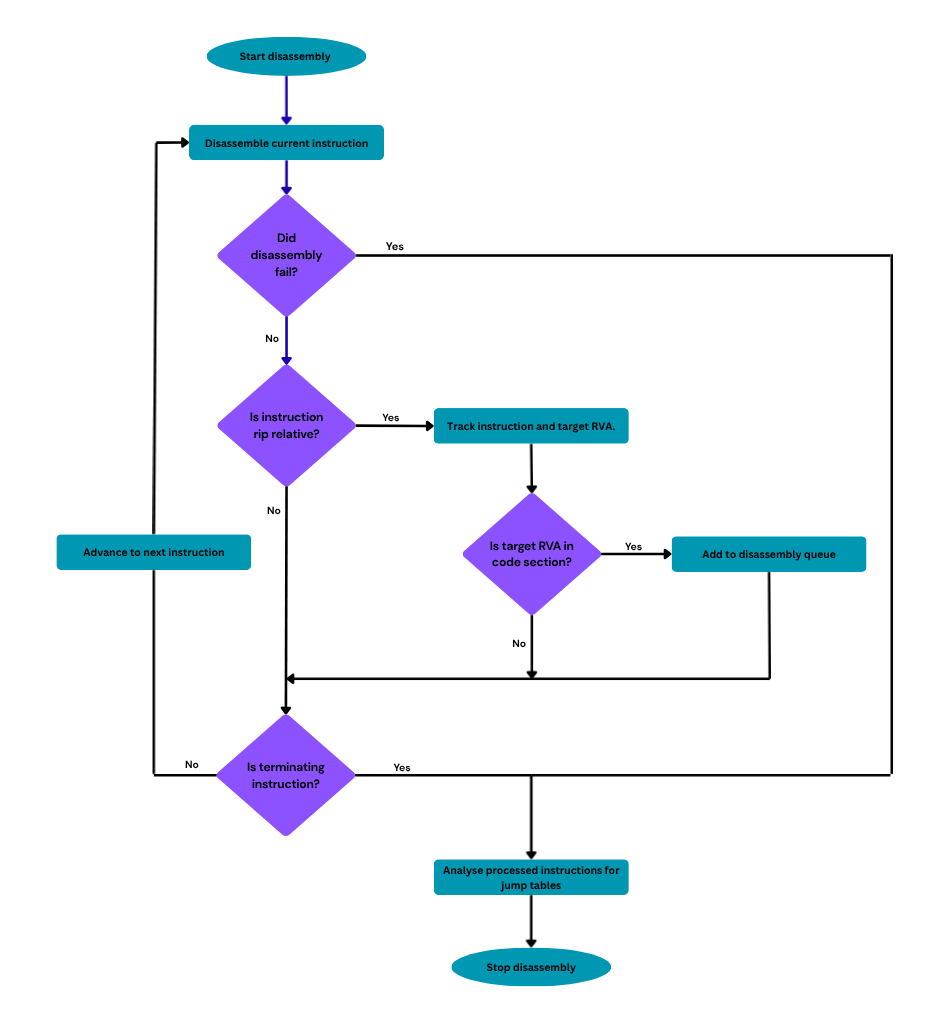
图 2. 反汇编处理。
### 2.2.1 基本块拆分
如果两个基本块重叠,则必须拆分其中一个。这样可以避免两个块描述相同的指令。例如:```asm
wcslen proc
or rax, 0FFFFFFFFFFFFFFFFh
loc_140001078:
inc rax
cmp word ptr [rcx+rax*2], 0
jnz short loc_140001078
retn
wcslen endp
这是 wcslen 的一个实现,用于获取宽字符串的长度。当第一条指令 'or rax, FFFFFFFFFFFFFFFF' 作为基本块的起始被反汇编时,它会一直反汇编到 'retn' 为止。
'jnz loc_140001078' 会向后跳转形成一个循环。该跳转将被添加为一个引用,同时 jnz 的目标地址以及 fallthrough 分支(下一条指令)都会被加入反汇编队列。该指令跳转到了已经分析过的块的中间,因此不能简单地形成一个新的块并再次向下反汇编到 'retn',否则会产生重复的表示。
'jnz'(条件跳转)也会走 fallthrough 分支,从而也创建一个新的基本块。现在将会有 4 个基本块,如下所示:
Block A:```asm
or rax, 0FFFFFFFFFFFFFFFFh
loc_140001078:
inc rax
cmp word ptr [rcx+rax*2], 0
jnz short loc_140001078
块 B:```asm
loc_140001078:
    inc     rax
    cmp     word ptr [rcx+rax*2], 0
    jnz     short loc_140001078
块 C:```asm
retn
块 D:```asm
    retn
这是对基本块的一种错误表示,因为它将相同的指令重复到了 4 个块中。这个问题可以通过拆分任何与当前反汇编重叠的基本块来修复。不再会有任何重复的指令,因为不再在每个重叠位置创建指令的重复表示,而是将现有指令转移到新的基本块中。使用拆分后的正确表示如下:
Block A:```asm
or rax, 0FFFFFFFFFFFFFFFFh
块 B:```asm
    inc     rax
    cmp     word ptr [rcx+rax*2], 0
    jnz     short loc_140001078
块 C:```asm
retn
### 2.2.2. 间接控制流

#### 2.2.2.1. 跳转表

跳转表用于存储 switch 语句中各处理程序的地址。与其为 switch 语句中的每个 case 编写大量 if 语句/条件跳转,不如保存一张包含各 case 处理程序地址的表。以下是一个示例(LLVM/CLANG 二进制文件):```cpp
std::int32_t sub_140004080(const std::int32_t a1)
{
  std::int32_t result;

  switch ( a1 )
  {
    case 0:
      result = 9;
      break;
    case 1:
      result = 4;
      break;
    case 2:
      result = 3;
      break;
    case 3:
      result = 1;
      break;
    default:
      result = 0;
      break;
  }

  return result;
}
这个 switch 语句编译为以下汇编代码:```asm
; ecx = a1
cmp ecx, 3 ; check if above bounds, must be default case
ja short def_140004097 ; goto default if a1 above 3
mov ecx, ecx
mov eax, ecx
lea rcx, jpt_140004097
movsxd rax, ds:(jpt_140004097 - 140004100h)[rcx+rax*4] ; select correct index of jump table for a1
add rax, rcx
jmp rax ; goto index specified - the case handler
jpt_140004097:
dd offset loc_140004099 - 140004100h ; address of handler for first case
dd offset loc_1400040D5 - 140004100h ; address of handler for second case
dd offset loc_1400040BD - 140004100h ; address of handler for third case
dd offset loc_1400040C9 - 140004100h ; address of handler for fourth case
'a1' 值会与 case 的最大值进行比较,如果高于该值,则直接进入默认处理程序。如果 a1 在 case 范围内,则访问跳转表中对应的条目,并跳转到计算出的处理程序地址。

跳转表条目以及对跳转表的引用都会被跟踪,以确保它们保持完整。

##### 2.2.2.1.1. 有界跳转表

如果跳转表未描述 switch 语句可以使用的所有值范围,则它会使用有界表来检查边界。这是为了在超出边界时将 switch 重定向到默认语句。为了解析 case 语句的数量,会检查比较指令以找出条目数量。例如,指令 'cmp ecx, 3' 表示跳转表中的条目数量为 3。

##### 2.2.2.1.2. 无界跳转表

如果跳转表填满了 case 语句可能的所有值(例如,对于 UINT8 类型,从 UINT8 最小值到 UINT8 最大值),则它会使用无界表,不进行边界检查。这是因为编译器知道跳转表覆盖了所有可能的值。此时没有比较指令来提示跳转表条目的数量,因此必须暴力枚举条目。表的基址会被递增检查,以在代码段中寻找有效的 RVA,并跟踪每个有效条目。这种方式并不十分安全,因为它可能将其他数据/指令解析为跳转表条目,这就是为什么在可能的情况下会使用有界跳转表检查。

##### 2.2.2.1.3. 不同类型的跳转表

二进制重写器支持对 MSVC(包括多级表)、LLVM/CLANG 和 GCC 构建的二进制文件进行跳转表处理。

MSVC 跳转表有 2 种形式:普通形式和多级形式。MSVC 的普通跳转表是一个 RVA 数组。每个 RVA 指向 case 语句处理程序。

MSVC 的多级表用于具有大量共享处理程序的 case 语句的 switch 语句。多级版本有 2 个表,一个用于存储处理程序 RVA 的数组,另一个用于将 case 值与第一个表中的索引进行匹配。这样可以避免第一个表中 RVA 的重复,因为每个 case 值只需描述 1 字节的索引,而不是 4 字节的 RVA。下面是一个多级跳转表的示例:```asm
lea     rdx, cs:140000000h
movsxd  rax, edi ; load value
movzx   eax, ds:(byte_1400023D8 - 140000000h)[rdx+rax] ; get handler index by value
mov     ecx, ds:(jpt_14000209D - 140000000h)[rdx+rax*4] ; get RVA of handler by handler index
add     rcx, rdx
jmp     rcx