 iqsec-lab/freemoca
Framework di apprendimento continuo senza memoria per la classificazione del malware tramite interpolazione basata sulla connettività di modi. Supporta scenari incrementali per classi e per domini sui dataset EMBER e Androzoo.

[!NOTE] Questa è l'implementazione ufficiale dell'articolo Continual Learning Trajectory as Memory for Replay-Free Consolidation in Malicious Code Analysis.
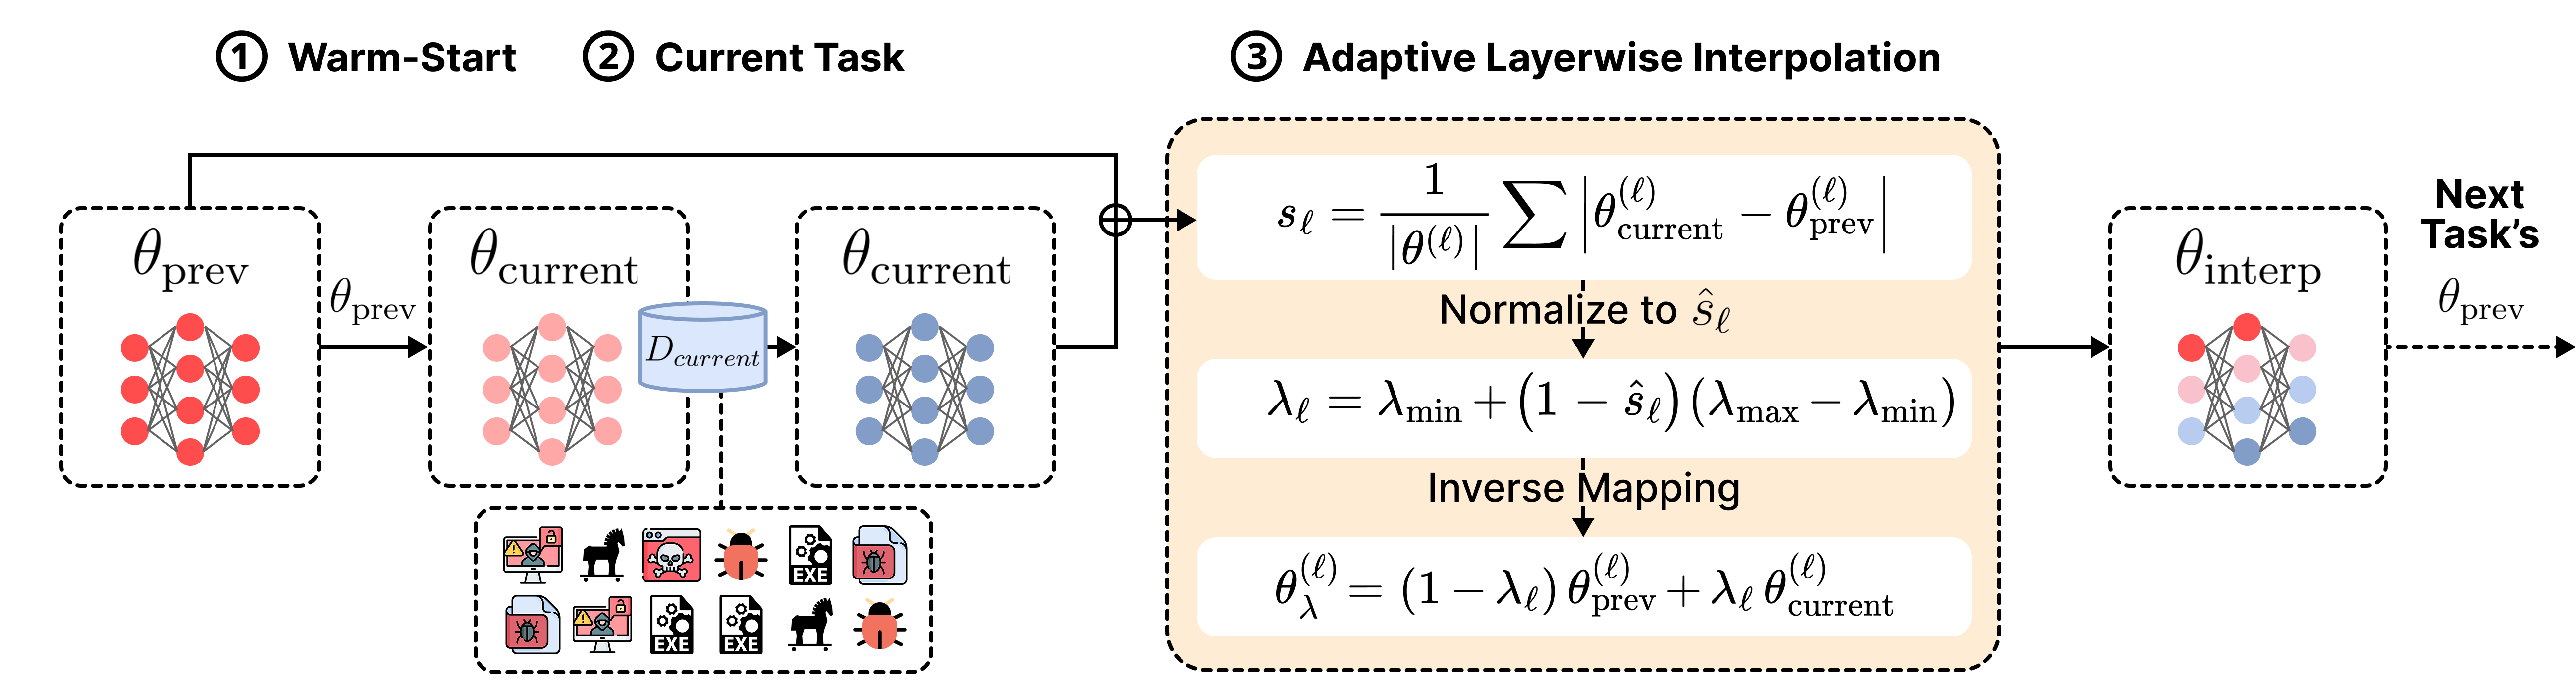
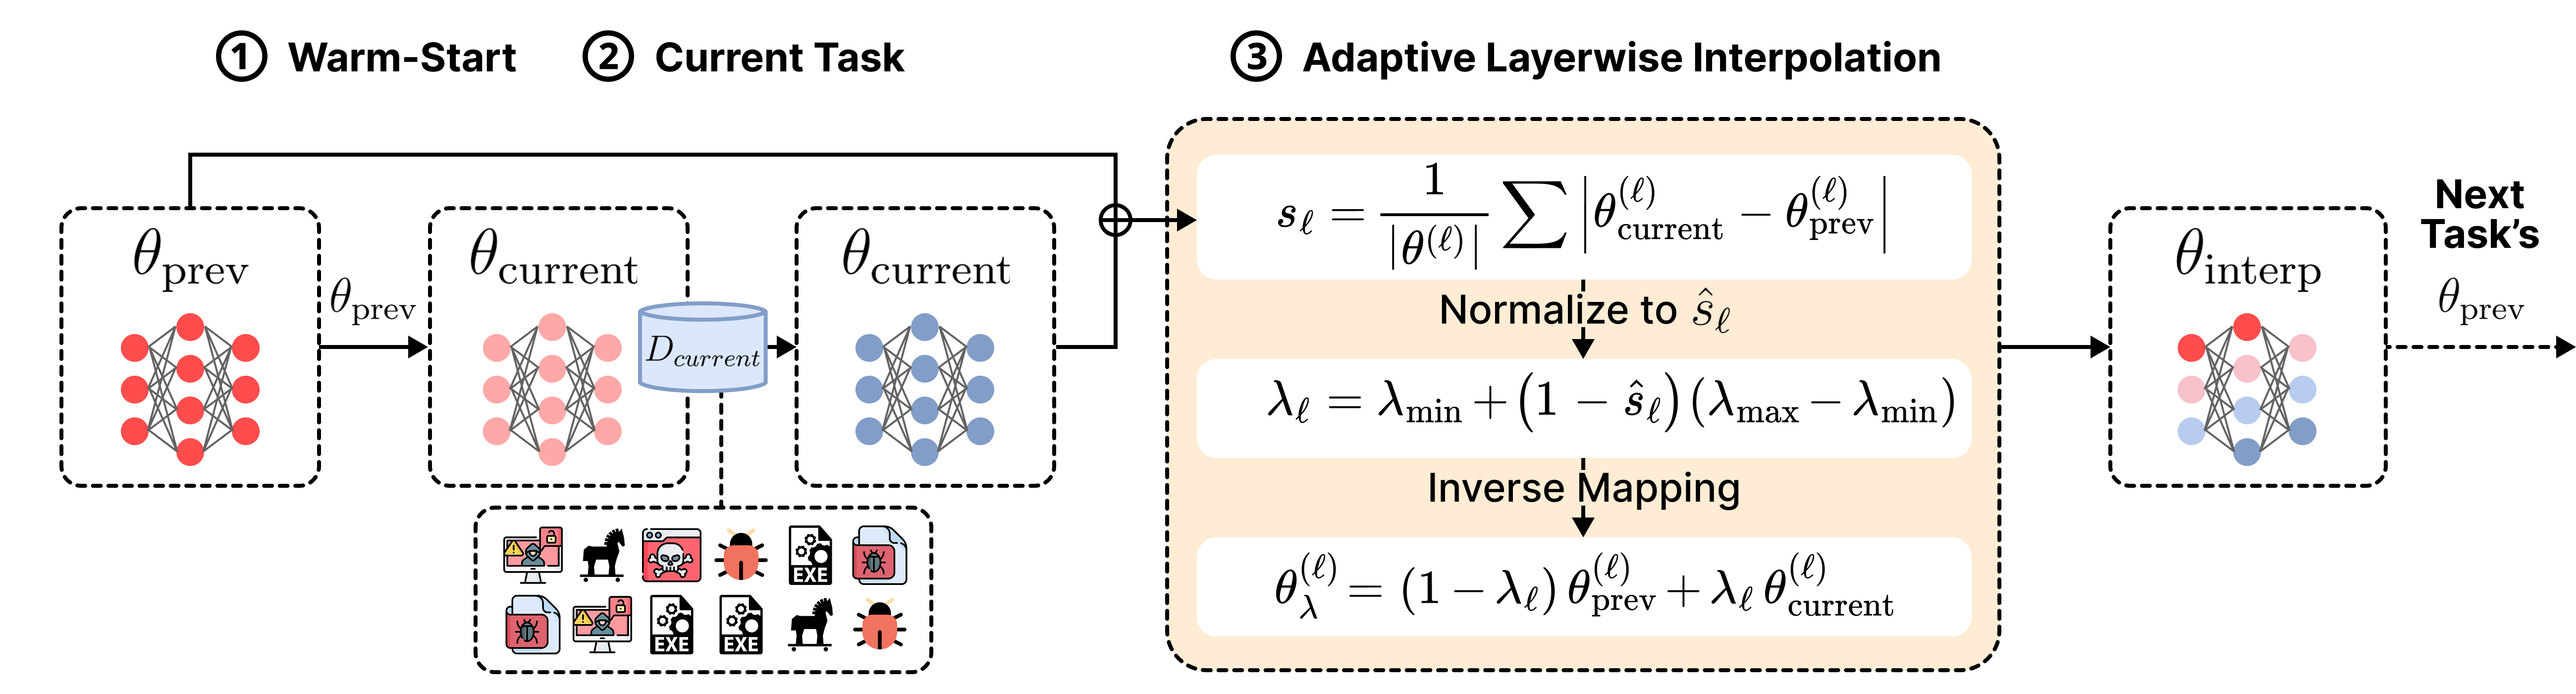
FreeMOCA opera nel seguente processo:
L'intero processo costruisce una catena di soluzioni connesse che giacciono su una varietà a bassa perdita, riducendo significativamente la dimenticanza catastrofica.
FreeMOCA è stato valutato con due dataset di malware su larga scala, EMBER e Androzoo. Fonti dei dataset:
Scarica e configura il dataset nella seguente directory:
FreeMOCA/data/
├── AZ_Class
│   ├── AZ_Class_Test.npz
│   └── AZ_Class_Train.npz
│
├── AZ_Domain
│   ├── 2008_Domain_AZ_Test_Transfo...
│   ├── 2008_Domain_AZ_Train_Transfo...
│   ├── 2009_Domain_AZ_Test_Transfo...
│   └── ...
│
├── EMBER_Class
│   ├── XY_test.npz
│   └── XY_train.npz
│
└── EMBER_Domain
    ├── 2018-01
    ├── 2018-02
    ├── 2018-03
    └── ...
Questo repository supporta due scenari di apprendimento continuo:
Esegui il seguente comando per il
conda create -n freemoca python=3.9
conda activate freemoca
pip install -r requirements.txt
# EMBER Class-IL
cd ./FreeMOCA_Class/EMBER_Class
CUDA_VISIBLE_DEVICES=0 python main.py --train_data /path/to/data --test_data /path/to/data
# AZ Class-IL
cd ./FreeMOCA_Class/AZ_Class
CUDA_VISIBLE_DEVICES=0 python main.py --train_data /path/to/data --test_data /path/to/data
# EMBER Domain-IL
cd ./FreeMOCA_Domain/EMBER_Domain
CUDA_VISIBLE_DEVICES=0 python main.py --data_root /path/to/data/directory
# AZ Domain-IL
cd ./FreeMOCA_Domain/AZ_Domain
CUDA_VISIBLE_DEVICES=0 python main.py --data_root /path/to/data/directory
Per una configurazione più dettagliata degli iperparametri, consulta l'Appendice A. Argomenti Comuni per FreeMOCA.
Per modificare gli iperparametri o le impostazioni sperimentali, utilizza i seguenti argomenti:
| Argomento | Descrizione |
|---|---|
--init_classes | Numero di classi al task 0 |
--epochs | Epoche per task |
--batchsize | Dimensione del batch |
--lr | Tasso di apprendimento |
--momentum | Momento SGD |
--weight_decay | Decadimento dei pesi |
--lambda_min | Peso minimo di interpolazione |
--lambda_max | Peso massimo di interpolazione |
Per modificare l'impostazione predefinita degli argomenti, consulta il file arguments.py.
Il nostro repository supporta esperimenti sulle seguenti baseline standard:
Puoi eseguirlo con il seguente comando:
cd /path/to/experiment/directory
CUDA_VISIBLE_DEVICES=0 python none.py --arugment_you_want
CUDA_VISIBLE_DEVICES=0 python joint.py --arugment_you_want
e seguendo lavori precedenti:
Puoi eseguire le baseline con il seguente comando:
# CLeWI for EMBER-Class
cd ./baselines/CLeWI
CUDA_VISIBLE_DEVICES=6 python main.py --model="clewi" \
  --dataset="seq_ember" --n_tasks=11 \
  --lr=0.001 --buffer_size=500 --n_epochs=50 \
  --seed=42 --optim_wd=0.0 --optim_mom=0.0 \
  --batch_size=512 --sub_dataset="ember"

# CLeWI for AZ-Class
cd ./baselines/CLeWI
CUDA_VISIBLE_DEVICES=6 python main.py --model="clewi" \
  --dataset="seq_ember" --n_tasks=11 \
  --lr=0.001 --buffer_size=500 --n_epochs=50 \
  --seed=42 --optim_wd=0.0 --optim_mom=0.0 \
  --batch_size=512 --sub_dataset="az"
# WSC for EMBER-Class
cd ./baselines/WSC
MODEL_NAME=wsc_20_ember
python main.py --config=./exps/wsc_memory/$MODEL_NAME.json
# WSC for AZ-Class
cd ./baselines/WSC
MODEL_NAME=wsc_20_az
python main.py --config=./exps/wsc_memory/$MODEL_NAME.json
# GR for EMBER-Class
cd ./baselines/GR_EWC_LwF_iCaRL_EMBER
CUDA_VISIBLE_DEVICES=0 python main.py --data_set=EMBER --tasks=11 --replay=generative --metrics --logger_file gr --scenario=class

# GR for AZ-Class
cd ./baselines/GR_EWC_LwF_iCaRL_AZ
CUDA_VISIBLE_DEVICES=0 python main.py --data_set=ANDROZOO --tasks=11 --replay=generative --metrics --logger_file gr --scenario=class
# EWC for EMBER-Class
cd ./baselines/GR_EWC_LwF_iCaRL_EMBER
CUDA_VISIBLE_DEVICES=0 python main.py --data_set=EMBER --tasks=11 --ewc --lambda=50 --metrics --logger_file ewc --scenario=class
