
 h4urek/cve-2026-50679
Write-up ed exploit per un heap buffer overflow di Windows Search (CVE-2026-50679) che consente l'escalation di privilegi locale tramite il dirottamento della vtable di CVIQuery e il caricamento di DLL.

A giugno di quest'anno ho trovato questo heap overflow in Windows Search e mi sono reso conto che era sfruttabile. Ho passato qualche giorno a lavorarci e sono riuscito a ottenere un LPE. Quando l'ho inviato, mi è stato detto che era un duplicato :(. È stato corretto nel Patch Tuesday di luglio ed è stato tracciato da Microsoft come CVE-2026-50679. In ogni caso, il processo di sfruttamento è stato molto divertente.
CPMExternalSearchResultIn (messaggio 245) inserisce un risultato di ricerca esterno in una query esistente. Il suo corpo è composto da tre DWORD seguiti da tre stringhe UTF-16, e ciascuna stringa è descritta da una lunghezza incorporata nel corpo:
WSP_MESSAGE_HEADER          16 bytes
queryNameLength              4 bytes
currentRowsetIndex           4 bytes
remainingRowsetCount         4 bytes
queryName                    queryNameLength UTF-16 chars, null-terminated
rowset metadata              rowsetMetadata, rowsetNameLength, sourceNameLength (12 bytes)
rowsetName                   rowsetNameLength UTF-16 chars, null-terminated
sourceName                   sourceNameLength UTF-16 chars, null-terminated
Tutte e tre le lunghezze provengono dal client. Il trasporto sa quanti byte sono arrivati, ma nulla nel formato del messaggio lega le lunghezze dichiarate a quel numero.
Prima che un messaggio raggiunga un handler, tquery!CProxyMessage::ValidateInputHeader controlla l'header. Verifica l'id del messaggio, i campi riservati, il checksum e la dimensione minima del messaggio per quell'id. Ma non controlla se le lunghezze delle stringhe dichiarate nel messaggio superano la dimensione del buffer del messaggio.
Il messaggio viene quindi inviato a tquery!CRequestServer::DoSetExternalRowset. L'handler alloca un buffer di destinazione dalla lunghezza del messaggio esterno e vi decodifica il buffer inline:
__int64 __fastcall CRequestServer::DoSetExternalRowset(CRequestServer *this, unsigned int msgSize)
{
    /* ... */
    BYTE *buffer = (BYTE *)operator new[](https://github.com/h4urek/cve-2026-50679/blob/main/msgSize);          /* outer message length */
    CPMExternalSearchResultIn *decoded =
        CPMExternalSearchResultIn::CPMExternalSearchResultIn(buffer, this + 0x270);
                                                             /* src = inline request buffer */
    /* ... */
}
Il costruttore è il punto in cui vengono utilizzate le lunghezze incorporate:
CPMExternalSearchResultIn::CPMExternalSearchResultIn(BYTE *dst, BYTE *src)
{
    /* dst: buffer sized by the outer message length */
    /* src: per-connection inline request buffer */
    /* ... */
    DWORD queryNameLength = *(DWORD *)(src + 0x10);
    *(DWORD *)(dst + 0x10) = queryNameLength;
    *(DWORD *)(dst + 0x14) = *(DWORD *)(src + 0x14);
    *(DWORD *)(dst + 0x18) = *(DWORD *)(src + 0x18);

    memcpy(dst + 0x1c, src + 0x1c, 2 * (queryNameLength + 1));

    DWORD rowsetNameLength = *(DWORD *)(src + 2 * queryNameLength + 0x22);
    memcpy(dst + 2 * queryNameLength + 0x2a,
           src + 2 * queryNameLength + 0x2a,
           2 * (rowsetNameLength + 1));

    DWORD sourceNameLength = *(DWORD *)(src + 2 * queryNameLength + 0x26);
    memcpy(dst + 2 * queryNameLength + 2 * rowsetNameLength + 0x2c,
           src + 2 * queryNameLength + 2 * rowsetNameLength + 0x2c,
           2 * (sourceNameLength + 1));
    /* ... */
}
La prima copia è quella ovvia. dst è stato allocato in base alla lunghezza del messaggio esterno; la lunghezza della copia proviene da queryNameLength; nulla confronta le due. La copia può essere molto più grande dell'allocazione e, poiché la sua origine è il buffer inline, supera anche i byte effettivamente arrivati. Il resto dell'origine è qualunque cosa il buffer di connessione contenesse da traffico precedente.
Le due stringhe successive sono peggiori. rowsetNameLength viene letto da src + 2 * queryNameLength + 0x22, un offset calcolato a partire dal queryNameLength controllato dall'attaccante, e sourceNameLength viene letto da un offset vicino. Entrambi sono al di fuori della parte fissa del messaggio, quindi il decoder legge qualunque cosa ci sia, la tratta come una lunghezza e copia di nuovo. Un singolo messaggio di piccole dimensioni produce quindi diverse letture e scritture fuori dai limiti, e nessuna delle lunghezze viene mai confrontata con l'allocazione di destinazione.
Sfruttare questo bug si riduceva a poche domande: quale oggetto corrompere e dirottare per il flusso di controllo, dove reindirizzare quel flusso di controllo e come aggirare l'heap LFH.
Dopo un po' di reversing ho trovato un oggetto adatto da dirottare: CVIQuery. CVIQuery è l'oggetto lato server dietro una query aperta. Quando il client invia una richiesta di query, il server crea un oggetto CVIQuery corrispondente, e il suo primo campo è la vtable dell'oggetto, quindi corrompere questo oggetto consente un dirottamento della vtable.
L'heap era l'ostacolo successivo. CVIQuery viene allocato dall'heap LFH, quindi volevo superare la randomizzazione dell'LFH effettuando uno spray di un gran numero di questi oggetti. La parte buona è che ogni richiesta di query crea un CVIQuery, il che fornisce una comoda primitiva di heap spray. Tuttavia, wsearch limita il numero massimo di richieste aperte a 4096, quindi il numero di spray è limitato, ma è stato sufficiente; serve solo un po' di fortuna :).
Infine dovevo decidere dove reindirizzare il flusso di controllo. Ho fatto qualche ricerca ma non ho trovato una tecnica adatta, quindi ho deciso di trovarne una da solo. Ho presto trovato una DLL caricata dal servizio wsearch: dxcore.dll, e la sua funzione DXCoreDriver::LoadDriverModule sembrava molto interessante:
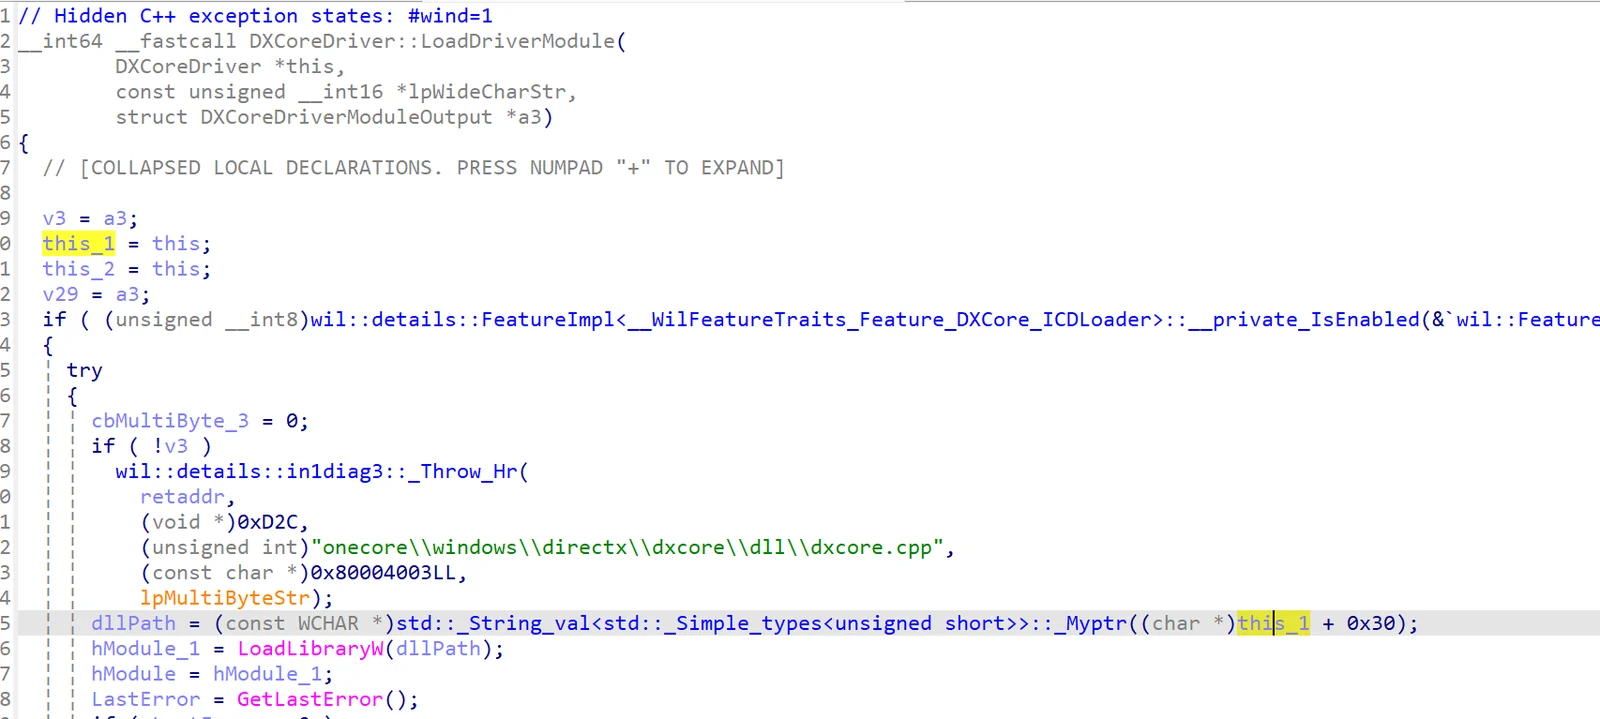
Questa funzione dereferenzia this + 0x30 come stringa di percorso di una DLL e chiama LoadLibraryW per caricare quella DLL. Quindi è sufficiente sovraccaricare CVIQuery e dirottare la sua vtable, poi continuare a sovraccaricare per scrivere il percorso della DLL in CVIQuery + 0x30, e il caricamento arbitrario di DLL è cosa fatta.
Un trucco molto utile. A proposito, quando ho costruito l'exploit questa funzione esisteva solo nelle build Insider, ma ho notato che di recente è comparsa anche nelle build di rilascio.






