
 seclog-open/seclog
Recopila registros de seguridad de múltiples fuentes a partir de escenarios de ataque reproducibles en Docker, construye cadenas de ataque y proporciona el benchmark SecLog-Bench-216 para evaluar el razonamiento de las etapas de ataque de los LLM.

SecLog apoya la investigación sobre el razonamiento de etapas de ataque a partir de registros de seguridad de múltiples fuentes. Proporciona herramientas para recopilar registros de escenarios reproducibles de ataque y actividad normal en Docker, organizar la evidencia en cadenas de ataque, construir conjuntos de datos etiquetados y evaluar las predicciones de los modelos.
La versión incluye SecLog-Bench-216, un benchmark listo para usar de 216 ventanas de evidencia con etiquetas de etapa revisadas y cadenas de razonamiento de referencia. Los investigadores pueden usar el benchmark proporcionado directamente o ejecutar el pipeline de construcción para producir nuevos datos.
Artículo: SecLog-Bench: A Scalable Benchmark for Cybersecurity Log Reasoning with Scaffolded Evidence.
Recursos de construcción en Zenodo: imágenes de Docker, registros sin procesar e índices de alineación, y cadenas de ataque construidas.
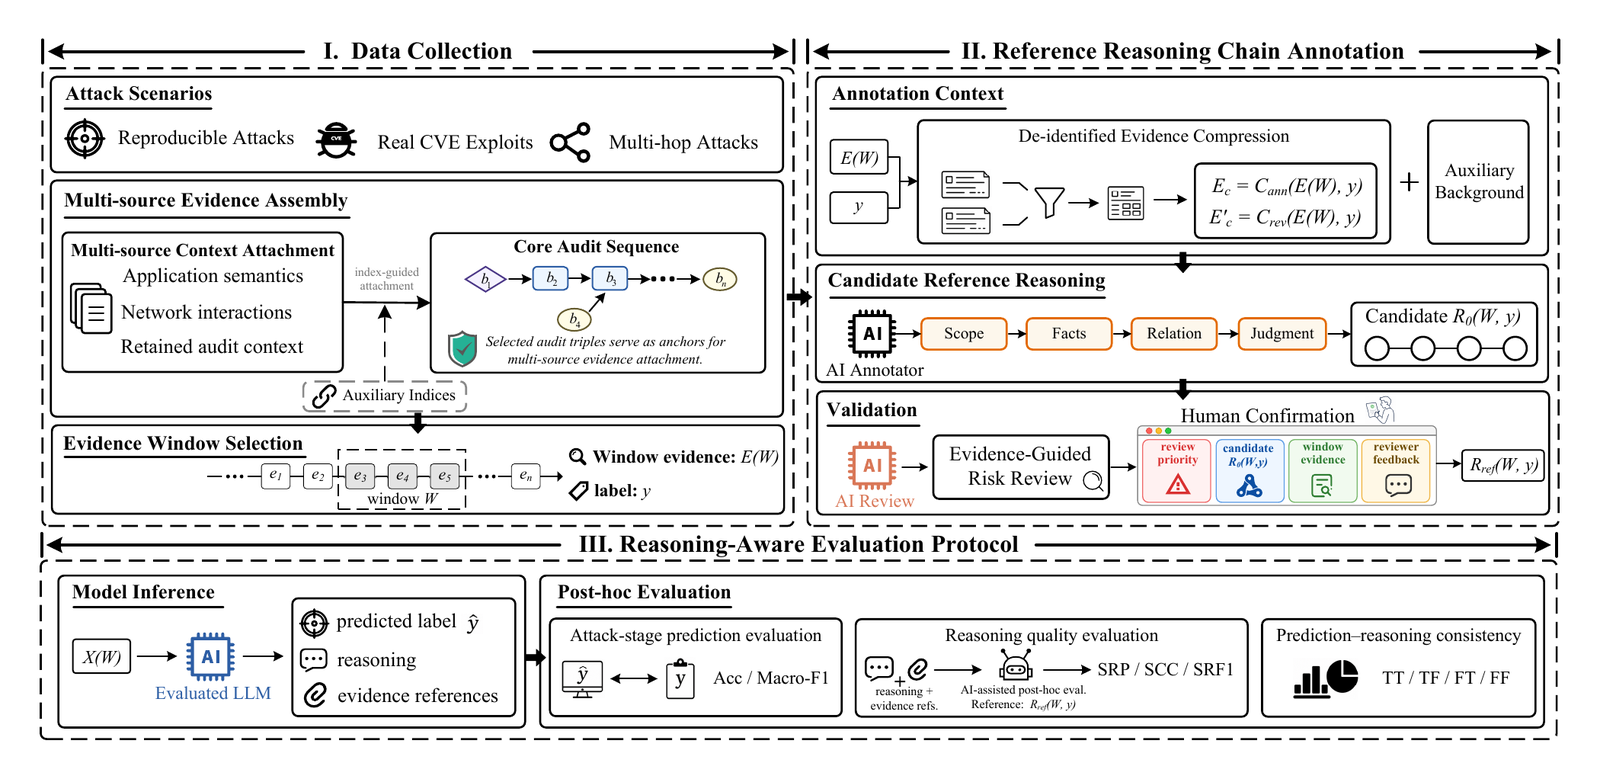
Figura 1. Descripción general de SecLog. La Parte I corresponde a las etapas 01–04, la Parte II al flujo de trabajo de anotación y revisión en 05, y la Parte III al flujo de trabajo de evaluación en 05 con SecLog-Bench-216.
| Tu objetivo | Empieza aquí | Entorno |
|---|---|---|
| Leer o reutilizar el conjunto de datos proporcionado | SecLog-Bench-216 y ejemplos de datos | Cualquier lector de JSONL; Python 3.11 para el validador |
| Evaluar un modelo en el benchmark proporcionado | Inicio rápido | Python 3.11; un endpoint de API y una clave para el ejecutor de inferencia incluido |
| Recopilar nuevos registros y construir un conjunto de datos o benchmark | Construcción de datos | Ubuntu Linux, Python 3.11, Poetry, Docker y herramientas de captura |
Los paquetes de sistema detallados, los componentes opcionales y las versiones de dependencias se enumeran en ENVIRONMENT_DEPENDENCIES.md.
Estos comandos usan Bash y se ejecutan desde la raíz del proyecto. Comienza con un entorno aislado de Python 3.11:
python3.11 -m venv ../seclog-env
source ../seclog-env/bin/activate
Los comandos a continuación utilizan la biblioteca estándar de Python. Para la recopilación de registros, la anotación, la interfaz de revisión y análisis adicionales, consulte la guía de entorno.
python 05_benchmark_annotation_review_evaluation/scripts/validate_public_benchmark.py
El validador comprueba los recuentos de muestras, los IDs, la distribución de etiquetas, las referencias de evidencia y los hashes del manifiesto. Una validación exitosa informa validation_passed: true y sample_count: 216 en su salida JSON.
Reemplace your-model-name con el identificador de modelo admitido por su proveedor:
python 05_benchmark_annotation_review_evaluation/evaluation/run_benchmark_inference.py \
  --prompt-pack SecLog-Bench-216/data/prompt_pack.jsonl \
  --model your-model-name \
  --output ../seclog-runs/example/raw_responses.jsonl
Este comando informa mode: preflight_no_api y el recuento de prompts. No contacta con el proveedor ni crea un archivo de respuesta, y no verifica que el proveedor admita el modelo seleccionado.
Establezca OPENAI_API_KEY en el entorno de su shell, reemplazando el marcador de posición a continuación con la clave de su proveedor, y luego habilite explícitamente las llamadas a la API:
export OPENAI_API_KEY="YOUR_API_KEY"
python 05_benchmark_annotation_review_evaluation/evaluation/run_benchmark_inference.py \
  --prompt-pack SecLog-Bench-216/data/prompt_pack.jsonl \
  --model your-model-name \
  --output ../seclog-runs/example/raw_responses.jsonl \
  --call-api
El ejecutor utiliza un endpoint de chat compatible con OpenAI. Su URL base predeterminada es
https://api.openai.com/v1; use --base-url para otro endpoint y
--api-key-env para otro nombre de variable de clave. Mantenga el directorio de salida
fuera del árbol de la versión, como en este ejemplo. Use una nueva ruta de salida para cada
ejecución, o añada --resume para continuar un archivo de respuestas existente.
Para usar su propio sistema de inferencia, incluidos los modelos que rechazan temperature,
max_tokens o el modo JSON, use SecLog-Bench-216/data/prompt_pack.jsonl y el
formato de predicción, luego pase
las salidas sin procesar al normalizador que se muestra a continuación.
python 05_benchmark_annotation_review_evaluation/evaluation/normalize_stage_reasoning_predictions.py \
  --input ../seclog-runs/example/raw_responses.jsonl \
  --output ../seclog-runs/example/predictions.jsonl

python 05_benchmark_annotation_review_evaluation/evaluation/evaluate_stage_reasoning_predictions.py \
  --gold SecLog-Bench-216/data/gold_labels.jsonl \
  --reference-chains SecLog-Bench-216/data/reference_reasoning_chains.jsonl \
  --model-input SecLog-Bench-216/data/evidence_windows.jsonl \
  --sample-index SecLog-Bench-216/data/sample_index.jsonl \
  --predictions ../seclog-runs/example/predictions.jsonl \
  --output-dir ../seclog-runs/example/evaluation
Los resultados incluyen:
| Salida | Contenido |
|---|---|
predictions.jsonl | Predicciones del modelo normalizadas |
invalid_outputs.jsonl | Respuestas que no pudieron normalizarse correctamente |
evaluation/metrics_summary.json | Métricas de evaluación agregadas |
evaluation/per_sample_results.jsonl | Resultados por muestra |
evaluation/confusion_matrix.csv | Matriz de confusión de predicción de etapas |
evaluation/per_stage_metrics.csv | Métricas por etapa |
evaluation/error_cases.jsonl | Casos conservados para el análisis de errores |
