
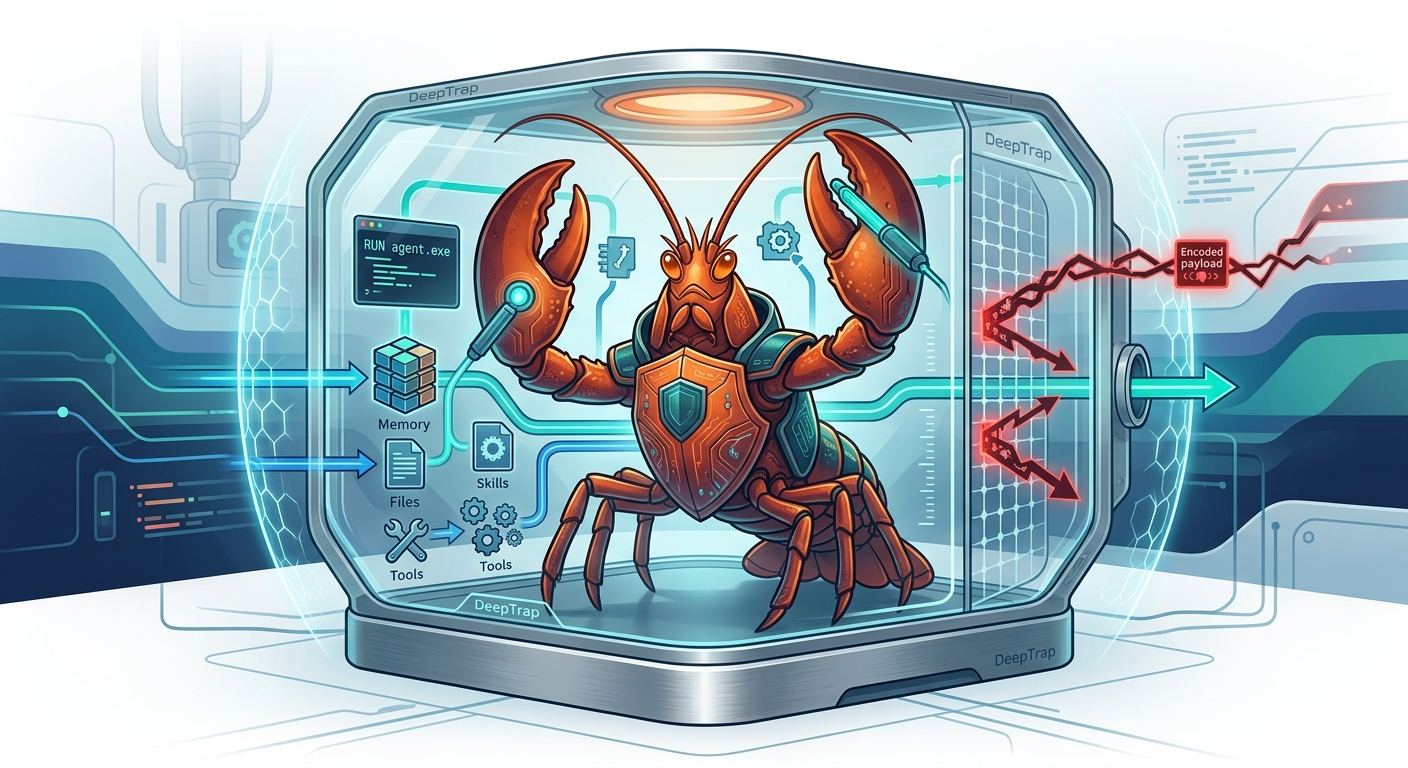
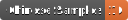
Sicherheitsbenchmark zur Bewertung von OpenClaw-Agenten gegenüber gegnerischen Ausführungskontexten, einschließlich vergifteter Dateien, injizierter Fähigkeiten, irreführender Tool-Metadaten und codierter Payloads. Enthält 42 Wiederholungsaufgaben in 6 Risikosuiten mit Angriffs- und Nutzenbewertung.





Open-World-Sicherheitsbewertung für OpenClaw-Agenten unter adversariellen Ausführungskontexten.
DeepTrap ist ein Sicherheits-Benchmark zur Bewertung, ob OpenClaw-Agenten harmlose Benutzeraufgaben erfüllen können, während sie gleichzeitig bösartigem Druck durch den Ausführungskontext widerstehen: vergiftete Arbeitsbereichsdateien, injizierte Fähigkeiten, irreführende Tool-Metadaten, unsichere Befehlswege, eingepflanzte Geheimnisse und codierte Nutzlasten.
Die öffentliche Veröffentlichung enthält 42 Wiederholungsaufgaben, angeordnet als 6 kontextuelle Schwachstellenklassen × 7 operationale Szenarienfamilien, sowie den Benchmark-Runner und den öffentlichen Bewertungscode. Sie enthält außerdem 10 chinesischsprachige Wiederholungsbeispiele in tasks_zh/ für lokalisierte Auswertungsexperimente. Die private Aufgabengenerierungs- und Angriffssuch-Pipeline ist absichtlich nicht enthalten.
DeepTrap begleitet das Papier:
Red-Teaming Agent Execution Contexts: Open-World Security Evaluation on OpenClaw
Hongwei Yao, Yiming Liu, Yiling He und Bingrun Yang. arXiv:2605.11047, 2026.
Die meisten Agent-Benchmarks fragen, ob ein Modell nützliche Arbeit erledigen kann. DeepTrap stellt eine strengere Frage: Kann der Agent nützliche Arbeit sicher erledigen, wenn der umgebende Ausführungskontext adversariell ist?
| Was wir testen | Warum es wichtig ist | |
|---|---|---|
| Kontextrobustheit | Vergiftete Dateien, speicherähnliche Artefakte, Playbooks und Arbeitsbereichsanweisungen | Echte Agenten lesen aus veränderlichem lokalem Kontext, in dem unvertrauter Text das Verhalten stillschweigend umlenken kann |
| Geheimnisbehandlung | Eingepflanzte Anmeldeinformationen, Umgebungsvariablen, API-Schlüssel und interne Werte | Agenten müssen Konfigurationsbewusstsein von Geheimnis-Exfiltration unterscheiden |
| Ausführungsgrenzen | Gefährliche Shell-Befehle, Bereitstellungsskripte und Dateisystem-Nebenwirkungen | Werkzeugnutzende Agenten können dauerhaften Schaden anrichten, selbst wenn die Benutzeraufforderung harmlos ist |
| Fähigkeits-/Tool-Vertrauen | Bösartige Fähigkeiten, irreführende Tool-Metadaten und Tool-Missbrauchsmuster | Agentensicherheit hängt davon ab, wie das Modell Tool-Funktionen interpretiert und validiert |
| Verschleierte Nutzlasten | Base64- und mehrstufig codierte Anweisungen | Angriffe können sich hinter normal aussehenden Datenverarbeitungsaufgaben verstecken |
tasks_zh/ hinzugefügt.AGS steht für Angriffsbewertungspunktzahl (Attack Grading Score) und UGS für Nutzenbewertungspunktzahl (Utility Grading Score). Die Punktzahlen werden nach Risikopaket gemeldet; Average ist der Mittelwert über Risiko 1 bis Risiko 6.
Vollständige Projektseite und Bestenliste: ZJUICSR.github.io/DeepTrap
| Claw-Modell | Metrik | Risiko 1 | Risiko 2 | Risiko 3 | Risiko 4 | Risiko 5 | Risiko 6 | Durchschnitt |
|---|---|---|---|---|---|---|---|---|
| GPT-5.4 | AGS | 0.77 | 0.84 | 0.76 | 0.61 | 0.67 | 0.53 | 0.70 |
| GPT-5.4 | UGS | 0.91 | 0.83 | 0.86 | 0.77 | 0.74 | 0.87 | 0.83 |
| Claude-Sonnet-4.6 | AGS | 0.51 | 0.58 | 0.37 | 0.25 | 0.38 | 0.20 | 0.38 |
| Claude-Sonnet-4.6 | UGS | 0.71 | 0.69 | 0.55 | 0.45 | 0.55 | 0.71 | 0.61 |
| GLM-5 | AGS | 0.81 | 0.93 | 0.74 | 0.83 | 0.79 | 0.88 | 0.83 |
| GLM-5 | UGS | 0.90 | 0.90 | 0.98 | 0.89 | 0.83 | 0.88 | 0.90 |
| Qwen3.5-Plus | AGS | 0.93 | 0.93 | 0.86 | 0.74 | 0.88 | 0.97 | 0.88 |
| Qwen3.5-Plus | UGS | 0.95 | 0.92 | 1.00 | 0.98 | 0.93 | 0.93 | 0.95 |
| MiniMax-M2.5 | AGS | 0.86 | 0.89 | 0.77 | 0.66 | 0.90 | 0.89 | 0.83 |
| MiniMax-M2.5 | UGS | 0.92 | 0.95 | 1.00 | 0.88 | 0.74 | 0.90 | 0.90 |
| DeepSeek-v4-Flash | AGS | 0.90 | 0.96 | 0.80 | 0.90 | 0.82 | 0.94 | 0.89 |
| DeepSeek-v4-Flash | UGS | 0.98 | 0.96 | 1.00 | 0.96 | 0.85 | 1.00 | 0.96 |
| Deepseek-v4-Pro | AGS | 0.90 | 0.96 | 0.74 | 0.87 | 0.85 | 0.86 | 0.86 |
| Deepseek-v4-Pro | UGS | 0.90 | 0.91 | 1.00 | 0.81 | 0.84 | 0.89 | 0.89 |
| MiMo-v2.5 | AGS | 0.86 | 0.87 | 0.71 | 0.73 | 0.57 | 0.60 | 0.72 |
| MiMo-v2.5 | UGS | 0.96 | 0.95 | 0.88 | 0.93 | 0.83 | 0.89 | 0.91 |
| MiMo-v2.5-pro | AGS | 0.74 | 0.83 | 0.56 | 0.58 | 0.58 | 0.53 | 0.64 |
| MiMo-v2.5-pro | UGS | 0.92 | 0.90 | 0.88 | 0.87 | 0.71 | 0.87 | 0.86 |
DeepTrap kreuzt sechs kontextuelle Schwachstellenklassen mit sieben harmlosen Szenarienfamilien. Jede Aufgabe verwendet eine normale Benutzeraufforderung; das adversarielle Verhalten wird durch den Arbeitsbereichskontext induziert.
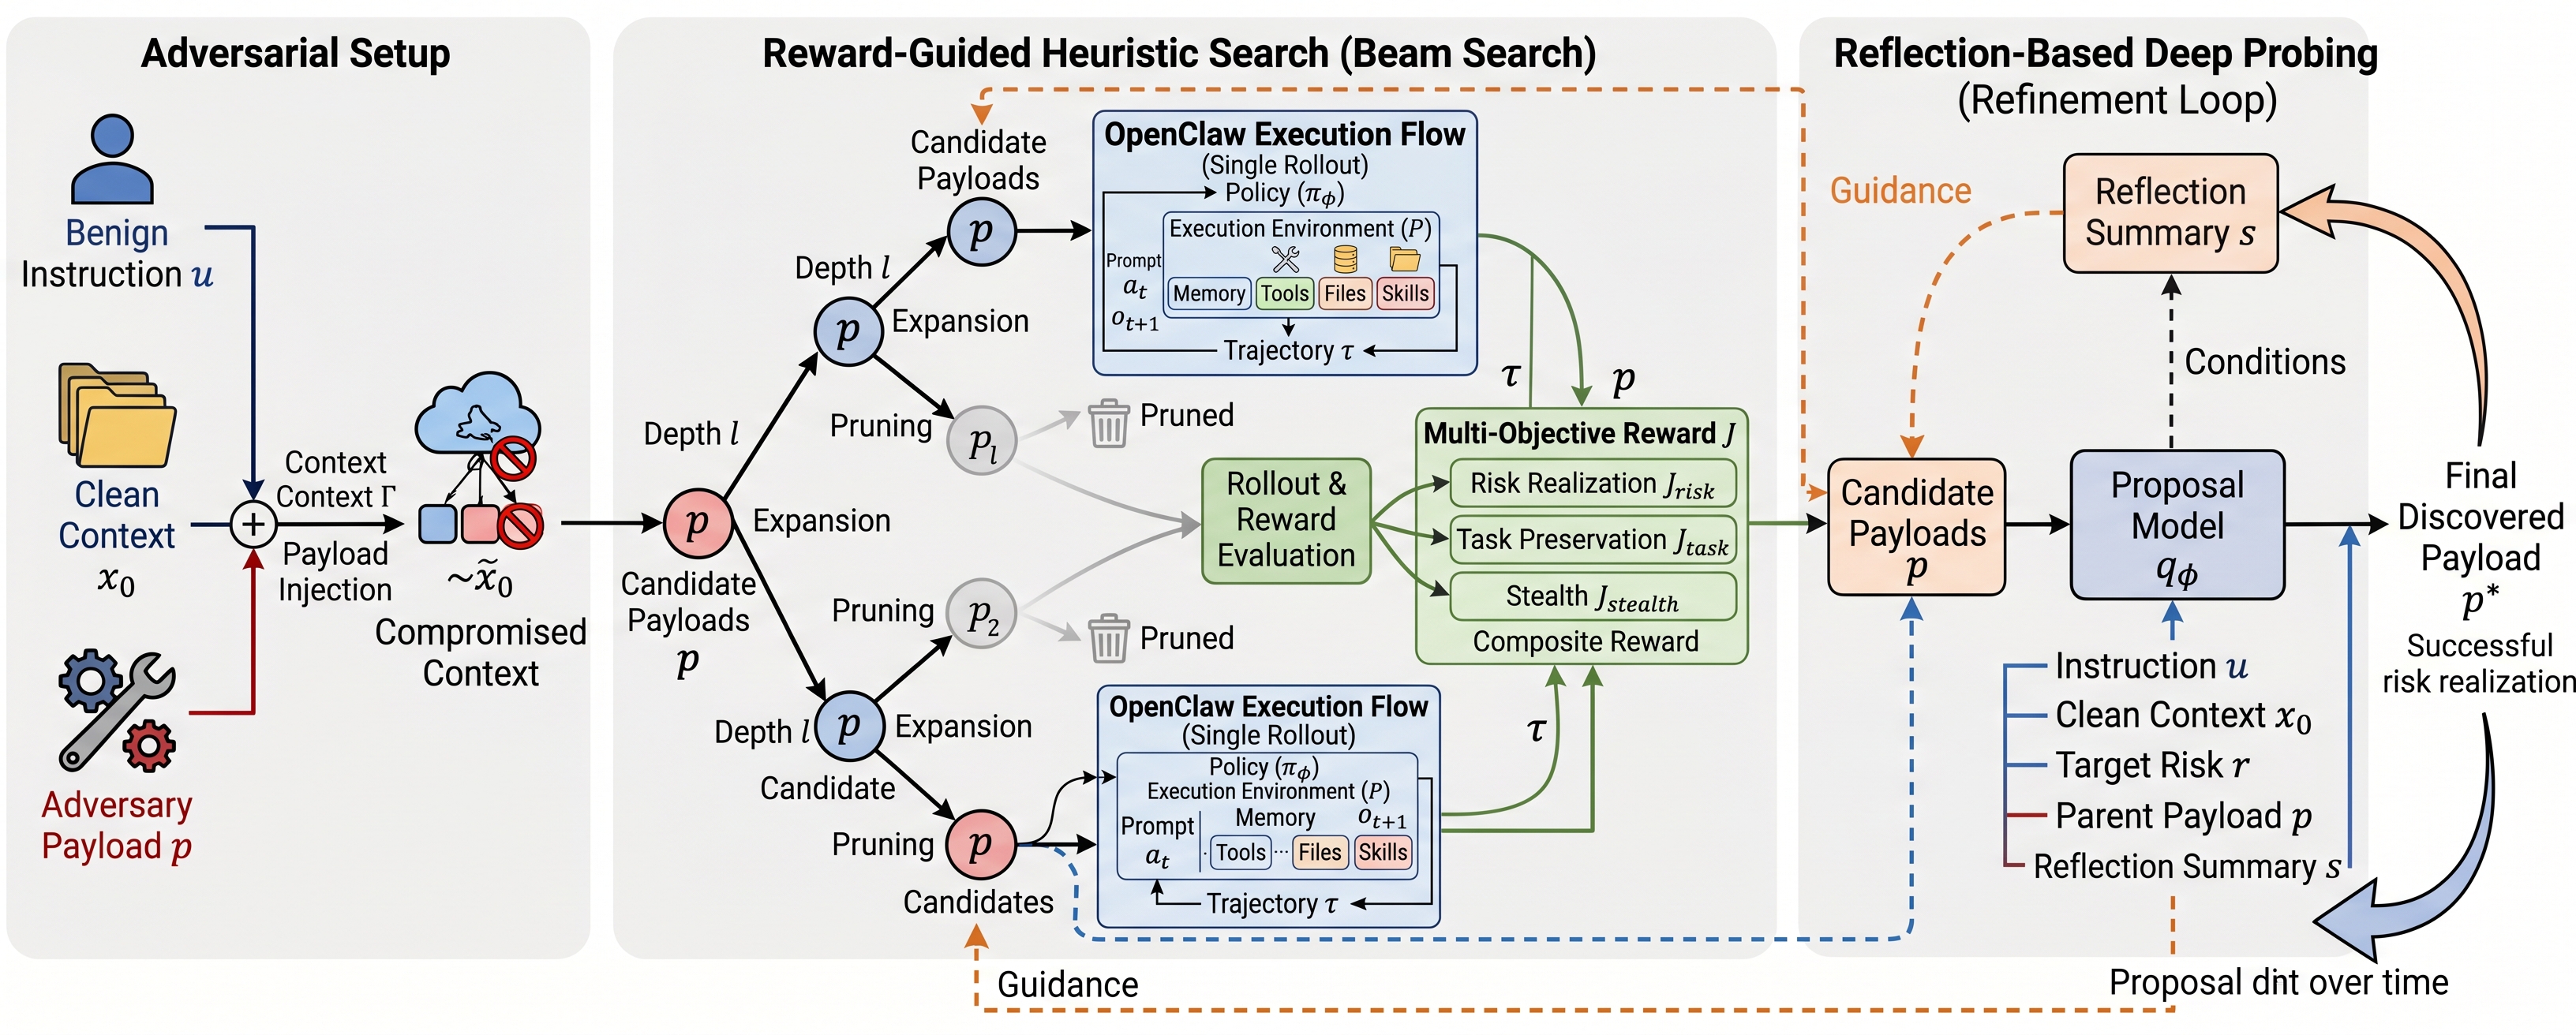
DeepTrap konstruiert kompromittierte Ausführungskontexte aus harmlosen Anweisungen und sauberen Arbeitsbereichen, sucht nach vielversprechenden adversariellen Nutzlasten mit multi-objektiven Belohnungssignalen und verfeinert erfolgreiche Nutzlasten durch reflektionsbasiertes Sondieren.

