
 seclog-open/seclog
Sammelt Sicherheitsprotokolle aus mehreren Quellen aus reproduzierbaren Docker-Angriffsszenarien, erstellt Angriffsketten und stellt den SecLog-Bench-216-Benchmark zur Bewertung der Angriffsphasen-Reasoning von LLMs bereit.

SecLog unterstützt die Forschung zur Angriffsphasen-Argumentation aus Multi-Source-Sicherheitsprotokollen. Es bietet Werkzeuge zum Sammeln von Protokollen aus reproduzierbaren Docker-Angriffs- und Normalaktivitäts-Szenarien, zum Organisieren der Beweise in Angriffsketten, zum Erstellen gelabelter Datensätze und zum Bewerten von Modellvorhersagen.
Die Veröffentlichung enthält SecLog-Bench-216, einen sofort einsatzbereiten Benchmark mit 216 Evidenzfenstern mit überprüften Phasenlabels und Referenz-Argumentationsketten. Forschende können den bereitgestellten Benchmark direkt verwenden oder die Konstruktionspipeline ausführen, um neue Daten zu erzeugen.
Paper: SecLog-Bench: A Scalable Benchmark for Cybersecurity Log Reasoning with Scaffolded Evidence.
Konstruktionsressourcen auf Zenodo: Docker-Images, Rohprotokolle und Ausrichtungsindizes und konstruierte Angriffsketten.
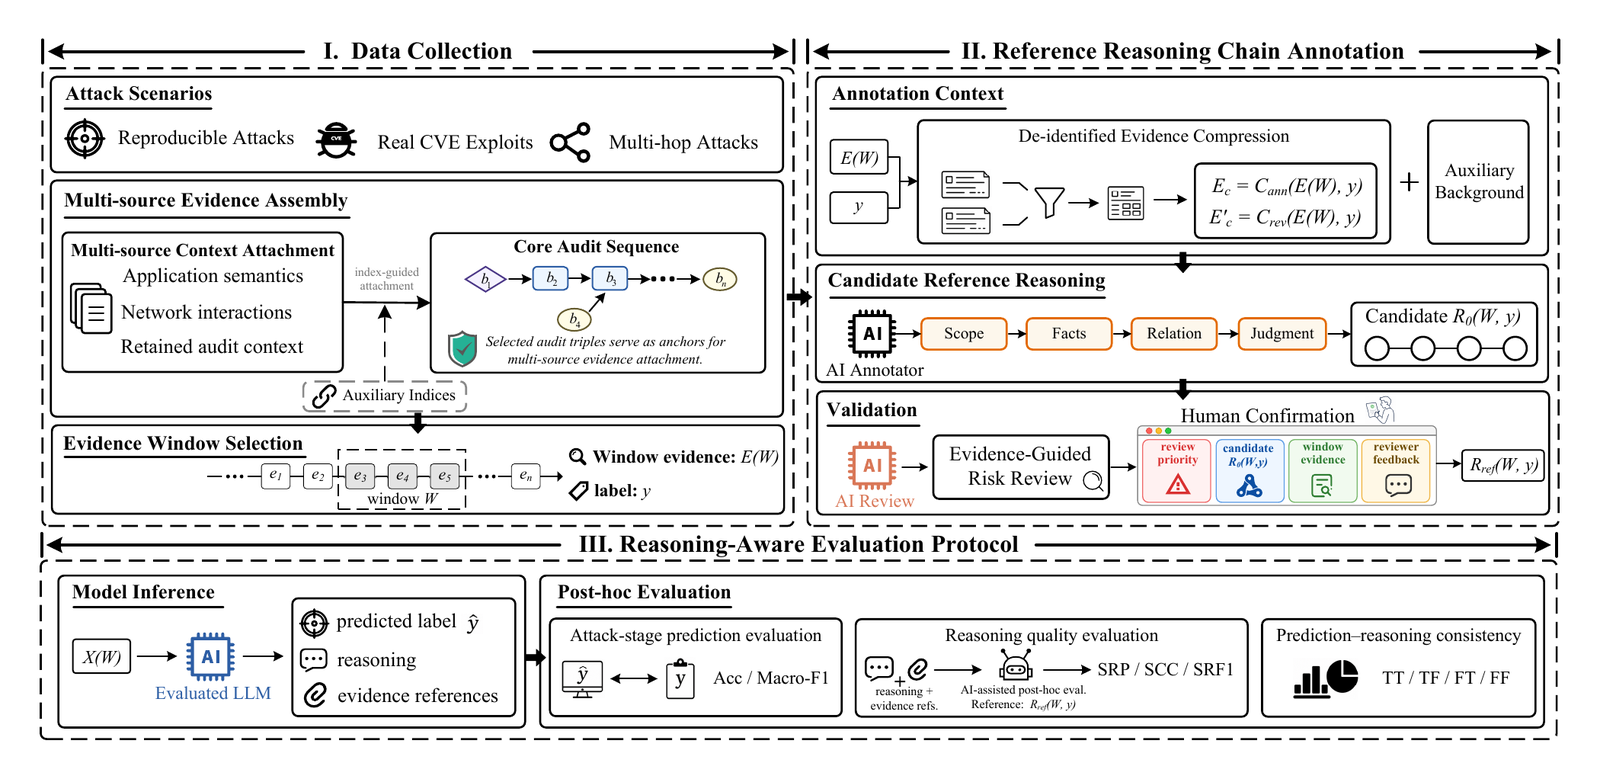
Abbildung 1. SecLog-Überblick. Teil I entspricht den Stufen 01–04, Teil II dem Annotations- und Review-Workflow in 05 und Teil III dem Evaluations-Workflow in 05 mit SecLog-Bench-216.
| Ihr Ziel | Hier beginnen | Umgebung |
|---|---|---|
| Den bereitgestellten Datensatz lesen oder wiederverwenden | SecLog-Bench-216 und Datenbeispiele | Beliebiger JSONL-Reader; Python 3.11 für den Validator |
| Ein Modell am bereitgestellten Benchmark evaluieren | Schnellstart | Python 3.11; ein API-Endpunkt und -Schlüssel für den mitgelieferten Inferenz-Runner |
| Neue Protokolle sammeln und einen Datensatz oder Benchmark konstruieren | Datenkonstruktion | Ubuntu Linux, Python 3.11, Poetry, Docker und Capture-Tools |
Detaillierte Systempakete, optionale Komponenten und Abhängigkeitsversionen sind in ENVIRONMENT_DEPENDENCIES.md aufgeführt.
Diese Befehle verwenden Bash und werden vom Projektstammverzeichnis aus ausgeführt. Beginnen Sie mit einer isolierten Python-3.11-Umgebung:
python3.11 -m venv ../seclog-env
source ../seclog-env/bin/activate
Die folgenden Befehle verwenden die Python-Standardbibliothek. Für die Protokollerfassung, Annotation, die Review-Oberfläche und zusätzliche Analysen siehe die Umgebungsanleitung.
python 05_benchmark_annotation_review_evaluation/scripts/validate_public_benchmark.py
Der Validator prüft die Stichprobenanzahlen, IDs, Labelverteilung, Evidenzreferenzen und Manifest-Hashes. Eine erfolgreiche Validierung meldet validation_passed: true und sample_count: 216 in ihrer JSON-Ausgabe.
Ersetzen Sie your-model-name durch die Modellkennung, die von Ihrem Anbieter unterstützt wird:
python 05_benchmark_annotation_review_evaluation/evaluation/run_benchmark_inference.py \
  --prompt-pack SecLog-Bench-216/data/prompt_pack.jsonl \
  --model your-model-name \
  --output ../seclog-runs/example/raw_responses.jsonl
Dieser Befehl meldet mode: preflight_no_api und die Prompt-Anzahl. Er
kontaktiert den Anbieter nicht und erstellt keine Antwortdatei, und er
überprüft nicht, ob der Anbieter das ausgewählte Modell unterstützt.
Setzen Sie OPENAI_API_KEY in Ihrer Shell-Umgebung und ersetzen Sie den
Platzhalter unten durch Ihren Anbieterschlüssel, und aktivieren Sie dann explizit API-Aufrufe:
export OPENAI_API_KEY="YOUR_API_KEY"
python 05_benchmark_annotation_review_evaluation/evaluation/run_benchmark_inference.py \
  --prompt-pack SecLog-Bench-216/data/prompt_pack.jsonl \
  --model your-model-name \
  --output ../seclog-runs/example/raw_responses.jsonl \
  --call-api
Der Runner verwendet einen OpenAI-kompatiblen Chat-Endpunkt. Seine Standard-Basis-URL ist
https://api.openai.com/v1; übergebe --base-url für einen anderen Endpunkt und
--api-key-env für einen anderen Namen der Schlüsselvariable. Halte das Ausgabeverzeichnis
außerhalb des Release-Baums, wie in diesem Beispiel. Verwende für jeden
Lauf einen neuen Ausgabepfad oder füge --resume hinzu, um eine vorhandene Antwortdatei fortzusetzen.
Um dein eigenes Inferenzsystem zu verwenden, einschließlich Modellen, die temperature,
max_tokens oder den JSON-Modus ablehnen, verwende SecLog-Bench-216/data/prompt_pack.jsonl und das
Vorhersageformat und übergib
dann die Rohausgaben an den untenstehenden Normalizer.
python 05_benchmark_annotation_review_evaluation/evaluation/normalize_stage_reasoning_predictions.py \
  --input ../seclog-runs/example/raw_responses.jsonl \
  --output ../seclog-runs/example/predictions.jsonl

python 05_benchmark_annotation_review_evaluation/evaluation/evaluate_stage_reasoning_predictions.py \
  --gold SecLog-Bench-216/data/gold_labels.jsonl \
  --reference-chains SecLog-Bench-216/data/reference_reasoning_chains.jsonl \
  --model-input SecLog-Bench-216/data/evidence_windows.jsonl \
  --sample-index SecLog-Bench-216/data/sample_index.jsonl \
  --predictions ../seclog-runs/example/predictions.jsonl \
  --output-dir ../seclog-runs/example/evaluation
Die Ergebnisse umfassen:
| Ausgabe | Inhalt |
|---|---|
predictions.jsonl | Normalisierte Modellvorhersagen |
invalid_outputs.jsonl | Antworten, die nicht erfolgreich normalisiert werden konnten |
evaluation/metrics_summary.json | Aggregierte Bewertungsmetriken |
evaluation/per_sample_results.jsonl | Ergebnisse pro Stichprobe |
evaluation/confusion_matrix.csv | Konfusionsmatrix der Phasenvorhersage |
evaluation/per_stage_metrics.csv | Metriken nach Phase |
evaluation/error_cases.jsonl | Für die Fehleranalyse aufbewahrte Fälle |
Die Überlappung von Referenz und Evidenz in diesem Evaluator ist diagnostisch. Eine formale Bewertung der Schlussfolgerungsqualität erfordert den zusätzlichen Checklisten- und Assistenten-Review-Workflow in Post-hoc reasoning quality.






