 praetorian-inc/noseyparker
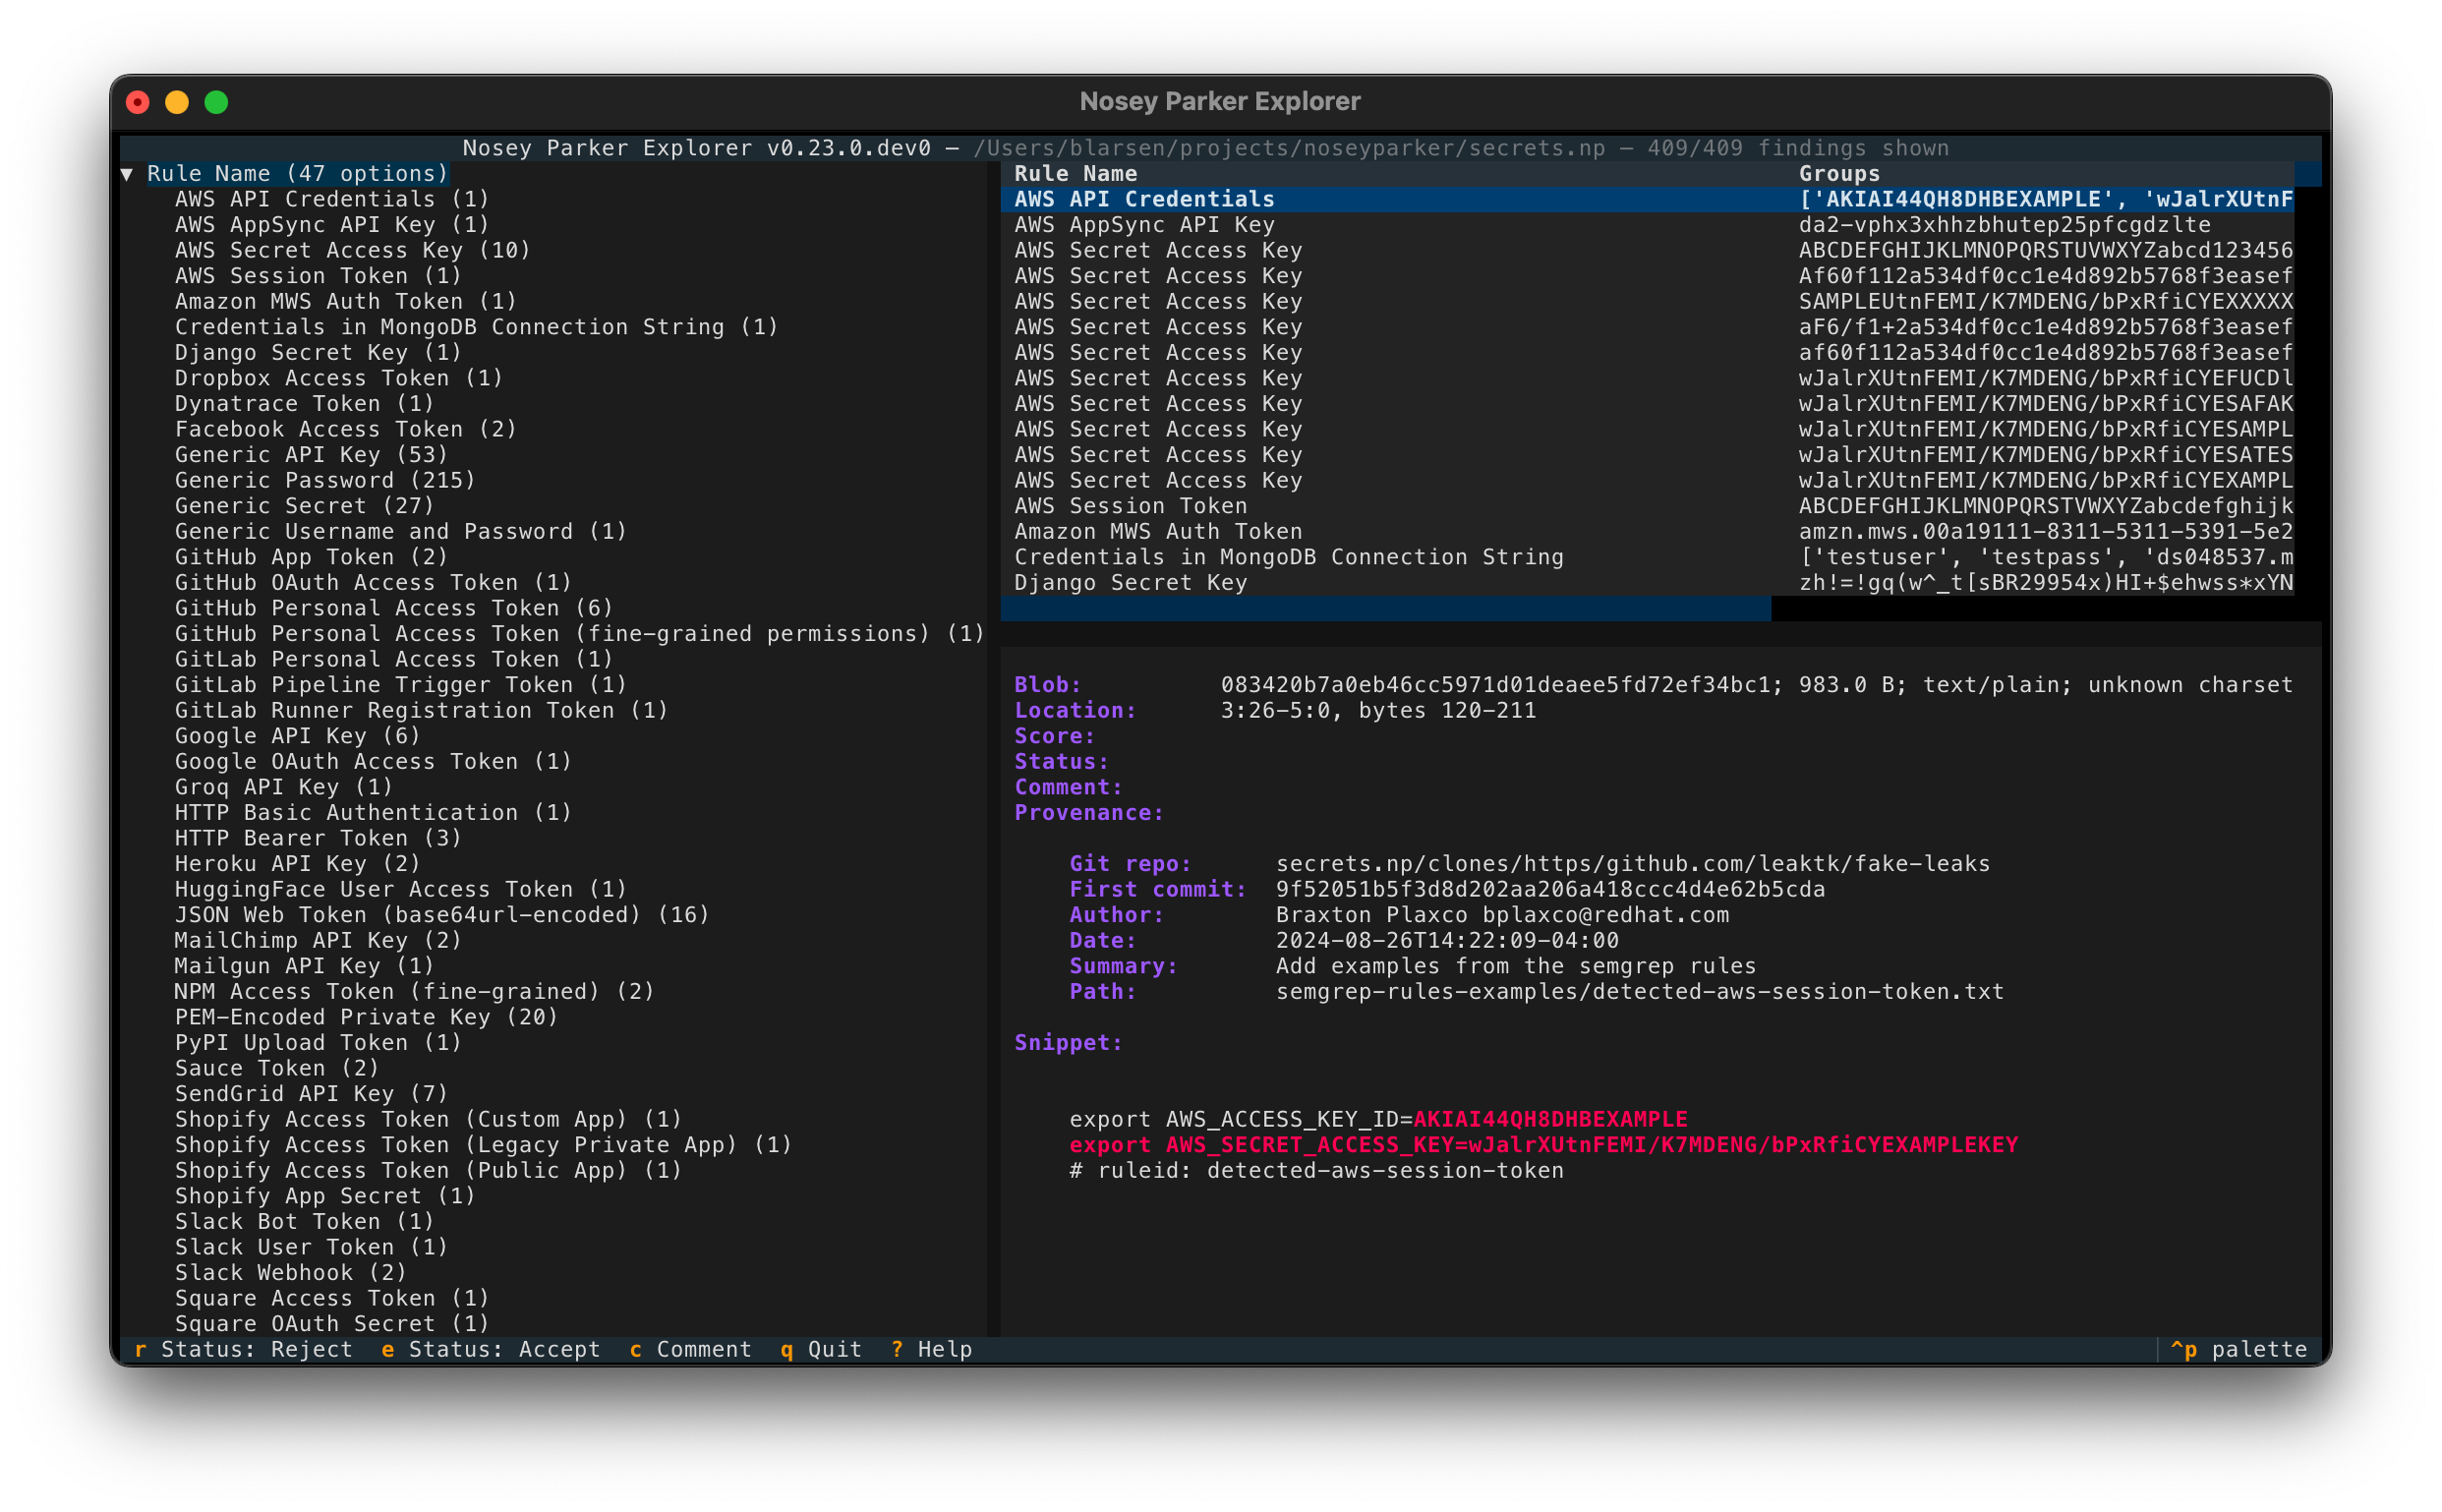
Nosey Parker ist ein Kommandozeilen-Tool, das Geheimnisse und vertrauliche Informationen in Textdaten und Git-Verläufen findet.

Siehe unseren Ankündigungsbeitrag https://www.praetorian.com/blog/titus-open-source-secret-scanner/. Das Titus-Repo finden Sie unter https://github.com/praetorian-inc/titus
Nosey Parker ist ein CLI-Tool, das Geheimnisse und sensible Informationen in Textdaten findet.
Es ist im Wesentlichen ein spezielles, grep-ähnliches Werkzeug zur Erkennung von Geheimnissen.
Es wurde für offensive Sicherheit entwickelt (z. B. zur Ermöglichung lateraler Bewegung in Red Teams), kann aber auch für defensive Sicherheitstests nützlich sein. Es hat in Hunderten von offensiven Sicherheitseinsätzen bei Praetorian Geheimnisse gefunden.
Hauptfunktionen:
Der typische Workflow besteht aus drei Phasen:
scanreportbrew install noseyparker
Die letzte Release-Seite enthält vorgefertigte Binärdateien für x86_64/aarch64 Linux und macOS.
docker pull ghcr.io/praetorian-inc/noseyparker:latest
Der aktuellste Commit ist auch über das main-Tag verfügbar.
docker pull ghcr.io/praetorian-inc/noseyparker-alpine:latest
Der aktuellste Commit ist auch über das main-Tag verfügbar.
https://aur.archlinux.org/packages/noseyparker
Nosey Parker lässt sich nicht nativ unter Windows erstellen (#121). Es ist möglich, es unter Windows mit WSL1 und der nativen Linux-Version auszuführen.
Dies wurde mit mehreren Versionen von Ubuntu Linux und macOS sowohl auf x86_64 als auch aarch64 getestet.
Erforderliche Abhängigkeiten:
cargo: empfohlener Ansatz: Installation von https://rustup.rscmake: wird zum Erstellen der vectorscan-sys-Crate und einiger anderer Abhängigkeiten benötigtboost: wird zum Erstellen der vectorscan-sys-Crate benötigt (unterstützte Version >=1.57)git: wird zum Einbetten von Versionsinformationen in das noseyparker-CLI benötigtpatch: wird zum Erstellen der vectorscan-sys-Crate benötigtpkg-config: wird zum Erstellen der vectorscan-sys-Crate benötigtsha256sum: wird zum Berechnen von Digests benötigt (oft vom coreutils-Paket bereitgestellt)zsh: wird für Build-Skripte benötigtcreate-release.zsh$ rm -rf release && ./scripts/create-release.zsh
Bei Erfolg wird eine Verzeichnisstruktur unter release mit den Release-Artefakten erstellt.
Das Befehlszeilenprogramm befindet sich unter release/bin/noseyparker.
Das Ausführen der noseyparker-Binärdatei ohne Argumente zeigt die Hilfe der obersten Ebene an und beendet sich.
Sie können eine verkürzte Hilfe für einen bestimmten Befehl erhalten, indem Sie noseyparker BEFEHL -h ausführen.
Ausführlichere Hilfe ist mit dem Befehl help oder der Langform --help verfügbar.
Die vorgefertigten Releases enthalten auch Manpages, die die Befehlszeilenhilfe an einem Ort zusammenfassen. Diese in das Markdown-Format konvertierten Manpages sind ebenfalls im Repository hier enthalten.
Wenn Sie eine Frage haben, die in dieser Dokumentation nicht beantwortet wird, starten Sie bitte eine Diskussion.
Der Datenspeicher ist ein spezielles Verzeichnis, das Nosey Parker verwendet, um seine Ergebnisse aufzuzeichnen und seinen internen Zustand zu verwalten.
Ein Datenspeicher wird bei Bedarf automatisch vom Befehl scan erstellt.
Jede gescannte Eingabe wird als Blob bezeichnet. Jeder Blob hat eine eindeutige Blob-ID, einen SHA-1-Digest, der auf die gleiche Weise wie git berechnet wird.
Jeder Blob hat einen oder mehrere zugehörige Provenienz-Einträge. Ein Provenienzeintrag sind Metadaten, die beschreiben, wie die Eingabe entdeckt wurde, z. B. eine Datei im Dateisystem oder eine Datei im Git-Repository-Verlauf.
Nosey Parker ist ein regelbasiertes System, das reguläre Ausdrücke verwendet.
Jede Regel hat ein einzelnes Muster mit mindestens einer Erfassungsgruppe, die den Übereinstimmungsinhalt vom umgebenden Kontext isoliert.
Sie können verfügbare Regeln mit noseyparker rules list auflisten.
Eine Sammlung von Regeln ist in einem Regelsatz organisiert.
Nosey Parkers Standard-Regelsatz enthält Regeln, die Dinge erkennen, die Geheimnisse zu sein scheinen.
Andere Regelsätze sind verfügbar; Sie können sie mit noseyparker rules list. auflisten.
Wenn das Muster einer Regel mit einer Eingabe übereinstimmt, erzeugt es eine Übereinstimmung. Eine Übereinstimmung wird eindeutig durch eine Regel, Blob-ID, Start-Byte-Offset und End-Byte-Offset definiert; diese Felder werden verwendet, um einen eindeutigen Übereinstimmungsbezeichner zu berechnen.
Übereinstimmungen, die sich eine Regel und Erfassungsgruppen teilen, werden zu einem Ergebnis zusammengefasst. Mit anderen Worten, ein Ergebnis ist eine Gruppe von Übereinstimmungen. Dies ist die oberste Berichtseinheit von Nosey Parker.
Wenn Sie das Docker-Image verwenden, ersetzen Sie noseyparker in den folgenden Befehlen durch einen Docker-Aufruf, der ein gemountetes Volume verwendet:
docker run -v "$PWD":/scan ghcr.io/praetorian-inc/noseyparker:latest <ARGS>
Der Docker-Container läuft mit /scan als Arbeitsverzeichnis, sodass das Mounten von $PWD auf /scan im Container die automatische Vervollständigung und relative Pfade in Ihrem Befehlszeilenaufruf funktionieren lässt.
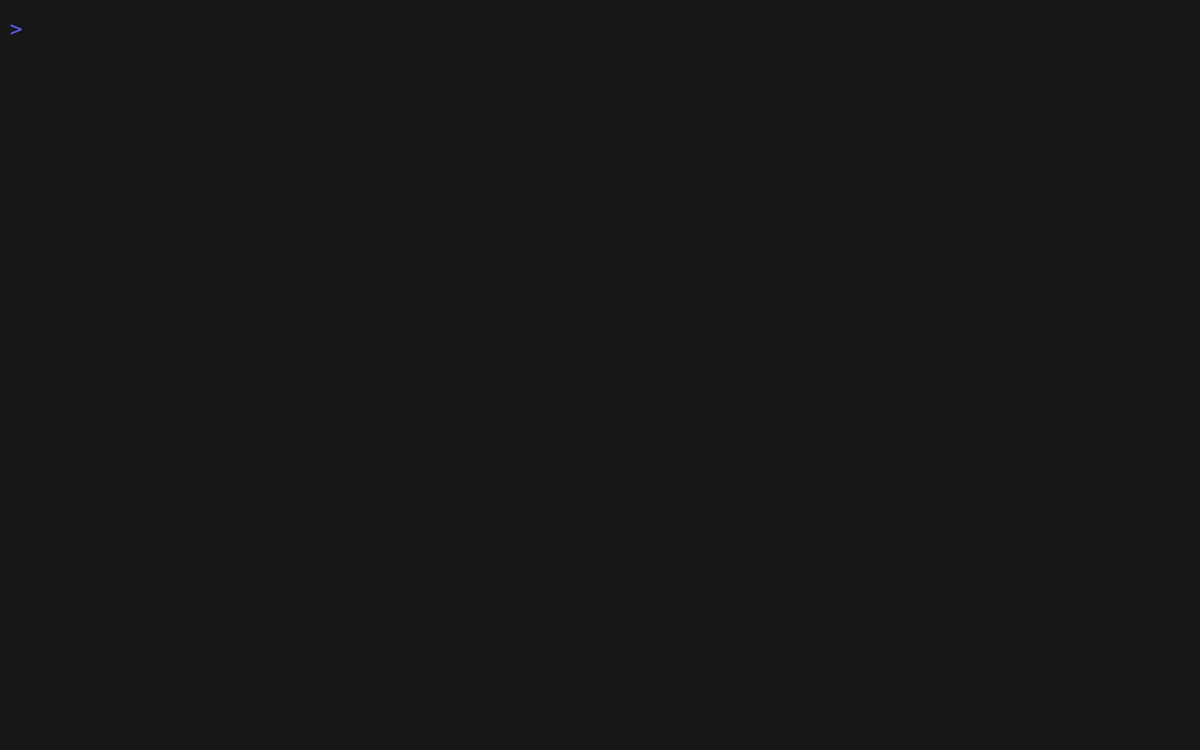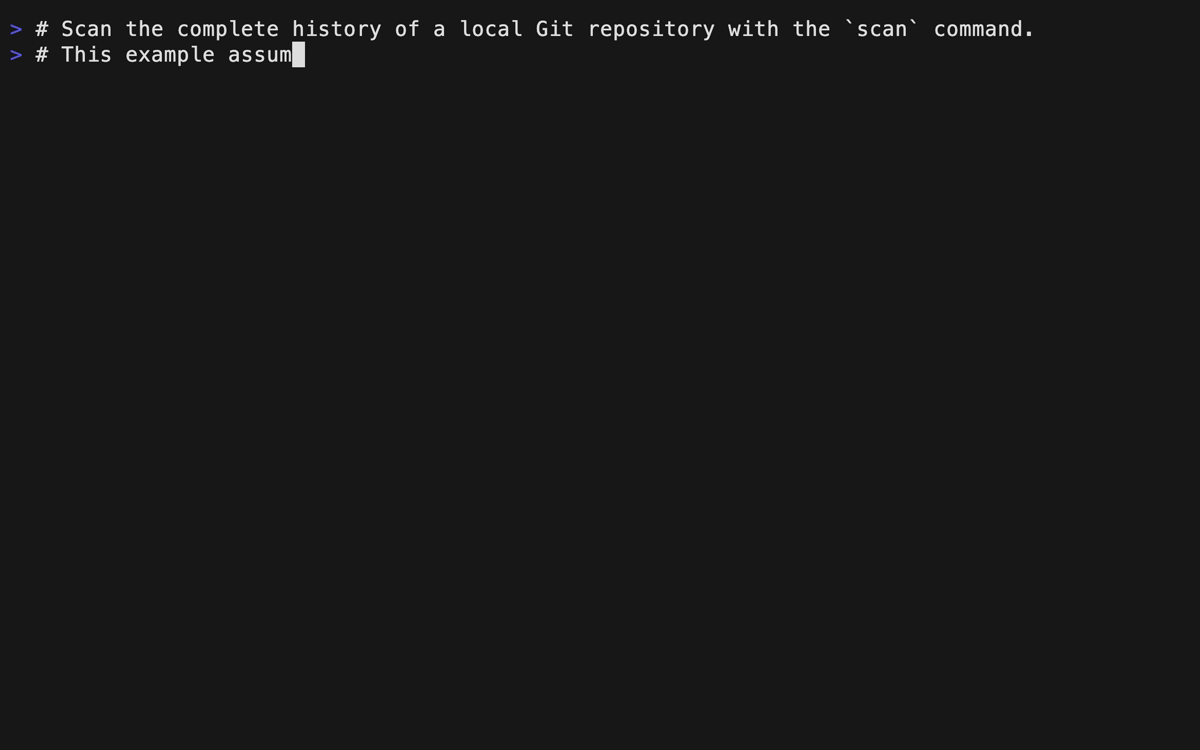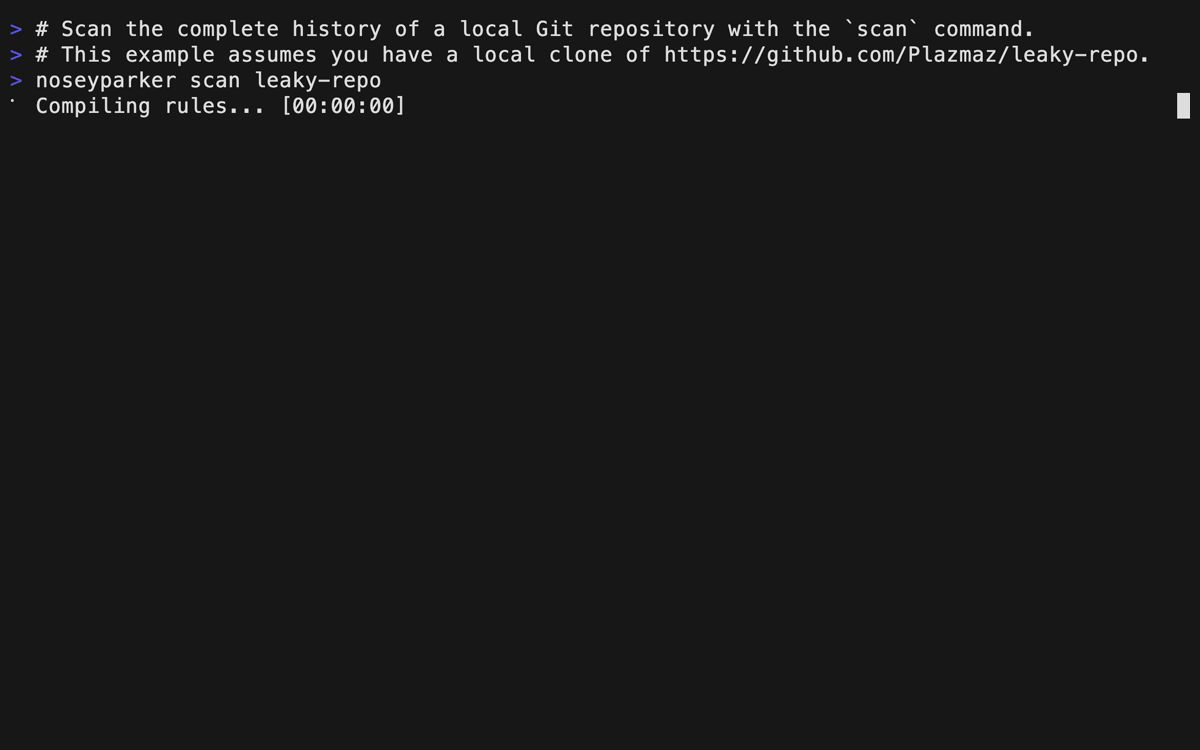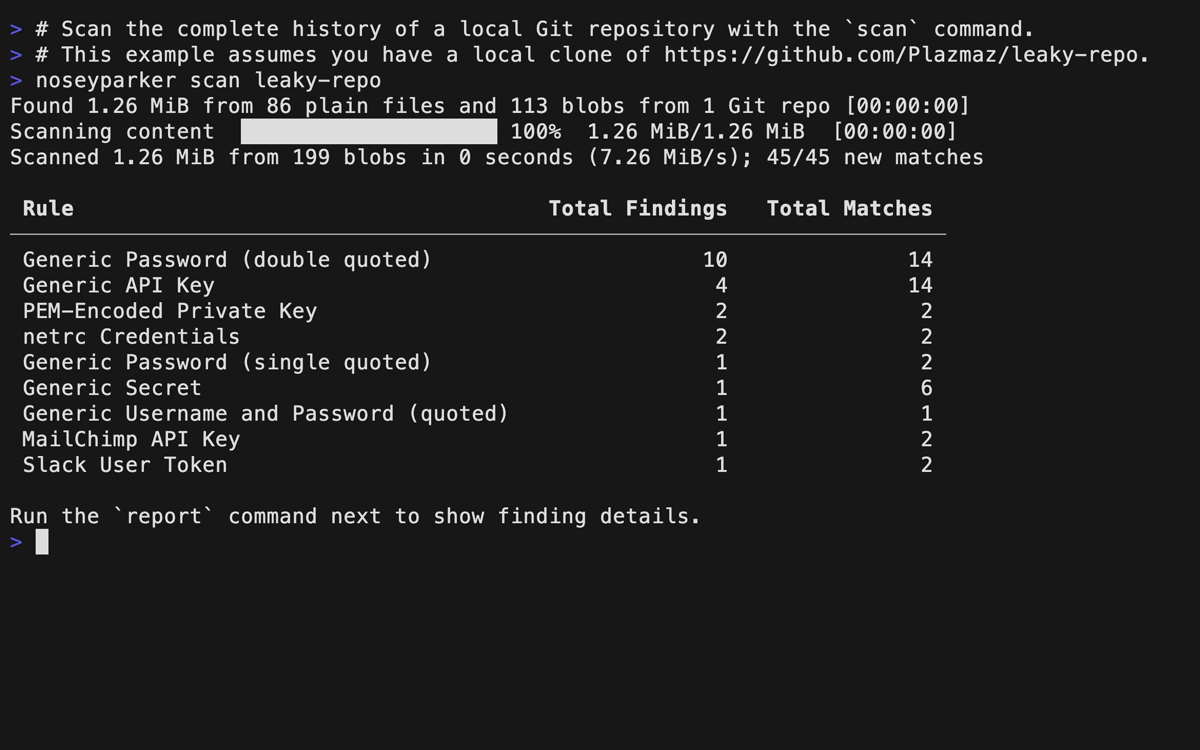
Nosey Parker unterstützt nativ das Scannen von Dateien, Verzeichnissen und des gesamten Verlaufs von Git-Repositories.
