
 #1
Tools für LLM-Sicherheit, Prompt-Injection, Modellextraktion, adversariales KI und KI-Red-Teaming.
Kitploit empfohlen

 foxcornlab/thc-bloodmiami
KI-Chatbox-Pentesting-Tool in C: feuert Sprach-Payloads (SQLi/NoSQL/XSS/SSTI) und Prompt-Injection-Payloads auf Chat-Oberflächen ab und markiert…
 owasp/agentic-evidence
OWASP-Referenzprojekt für Sicherheitsnachweise bei agentischer KI: korreliert Agentenausführung, Identität, Tool-Aufrufe und…
 owasp/agentic-vulnerability-discovery-and-validation-harness
Agentisches Harness, das die Schwachstellenerkennung und -validierung automatisiert und KI-gesteuerte Analyse-Workflows orchestriert, um ausnutzbare…
 owasp/llmsec
OWASP-Projekt mit Fokus auf Sicherheit für Anwendungen großer Sprachmodelle, das LLM-spezifische Risiken, Testleitfäden und Gegenmaßnahmen abdeckt.
 owasp/robotics-security-testing-guide
OWASP guide defining a standardized penetration testing methodology for humanoid, industrial, and autonomous robots, covering ROS/ROS2, DDS, CAN bus,…
 owasp/the-agents-epistemic-baggage
Ein auf Audits ausgerichtetes Risikomodell dafür, wie von Agenten erzeugte Schlussfolgerungen ihren epistemischen Status ändern, operative Autorität…
 cdxgen/cdxgen
Creates CycloneDX Bill of Materials (BOM) for your projects from source and container images. Supports many languages and package managers. Integrate…
 trailofbits/brotli-checker
Claude Code- und Codex-Skill zum Auffinden potenziell anfälliger Brotli-Kopien und zur Anleitung von Aktualisierungen für CVE-2026-111497.
 gmh5225/ollama-hunter
Durchsucht Shodan nach öffentlich exponierten Ollama- und llama.cpp-Servern, zählt Hosts, Standorte und verfügbare Modelle für die…
 asngs/agenttriage-open-source
Cross-Agent-Tracing- und Sicherheitsdiagnosesystem für werkzeugnutzende LLM-Agenten: normalisiert Trace-Ereignisse, erstellt Provenienz-Graphen,…
 suels-group/beyond_asr
Forschungscode zur Messung der Erfolgsraten von Jailbreak-Angriffen (ASR und schrittweise ASR) gegen LLMs, mit Implementierungen von Angriffen wie…
 pedrobarcha/memory-injection
Forschung zu persistenten Prompt-Injections über Speicherfunktionen in Claude, Gemini und ChatGPT, mit Reproduktionsschritten, Datensätzen und…
 xhyumiracle/sudp
Secret-Use Delegation Protocol — Geheimnisnutzung auf Protokollebene für agentische Systeme
 lassnajmuldeen/balcony-jailbreaking
Jailbreak-Schwachstelle über frühe Ausstiegstiefen von LLMs. Veröffentlicht auf der NeurIPS 2026 im FLMSec-Workshop
 owasp/xpsd
Erreichbarkeits-Triage für Schwachstellen-Scans. Speist Scanner-Funde in einen LLM-Agenten ein, der Ihren Quellcode liest und entscheidet, welche…
 ericyoc/ai-security-literacy
Reproduzierbare Colab-Pipeline, die sechs Kompetenzdimensionen der AI Security Literacy in öffentlichen Benchmarks und Umfrage-Mikrodaten verankert…
 tencent-hunyuan/diagsafe
Diagnostic LLM safety benchmark with 3,489 bilingual prompts, an 84-label taxonomy, and prompt-level rubric judging for explainable, fine-grained…
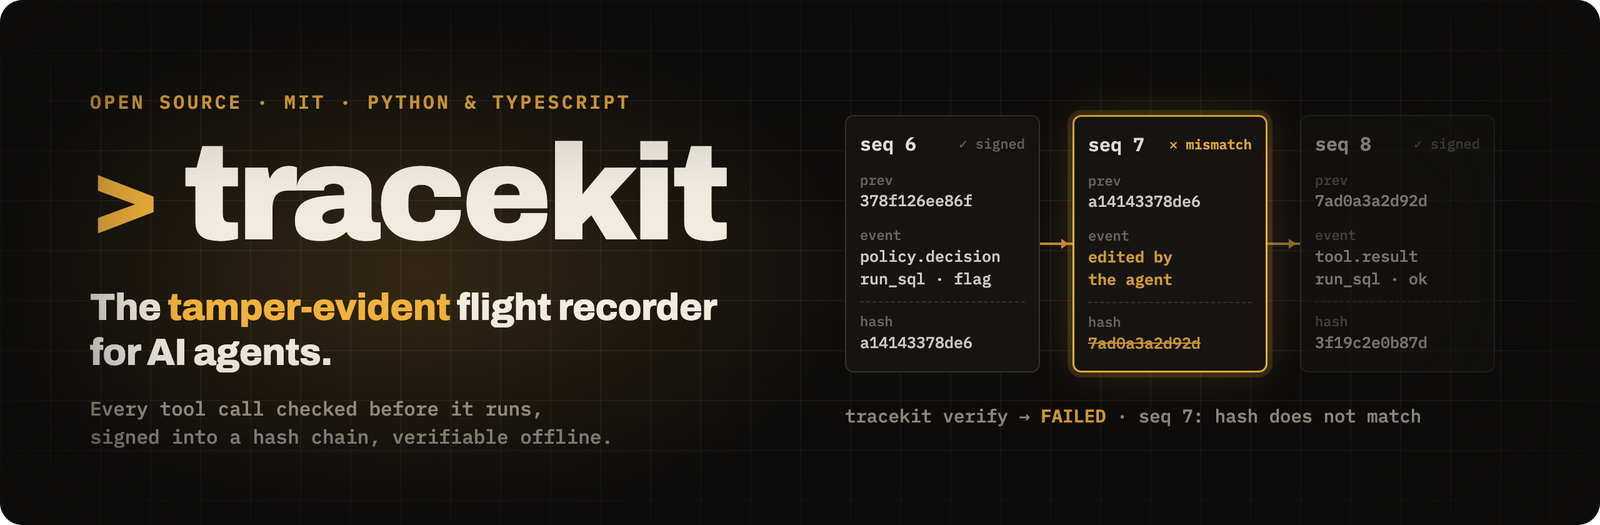 cygnux-labs/tracekit
Tamper-evident tracing, policy gates and cross-checks for AI agents: see what the agent did, and why.








