几十个有害示例就能让一个对齐模型不再拒绝有害请求。先前的工作将安全性定位到特定的层和方向,这暗示应当保护所发现的位置。本仓库以自适应攻击者的方式检验这一前提。它找出拒绝行为可以被恢复的位置,冻结该区域并再次攻击,然后修复权重更新,再让攻击者将其扩散。
本研究基于三项测量。
本仓库以小型库的形式提供测量方法和两种防御,并附带用于重建论文表格的运行记录和脚本。
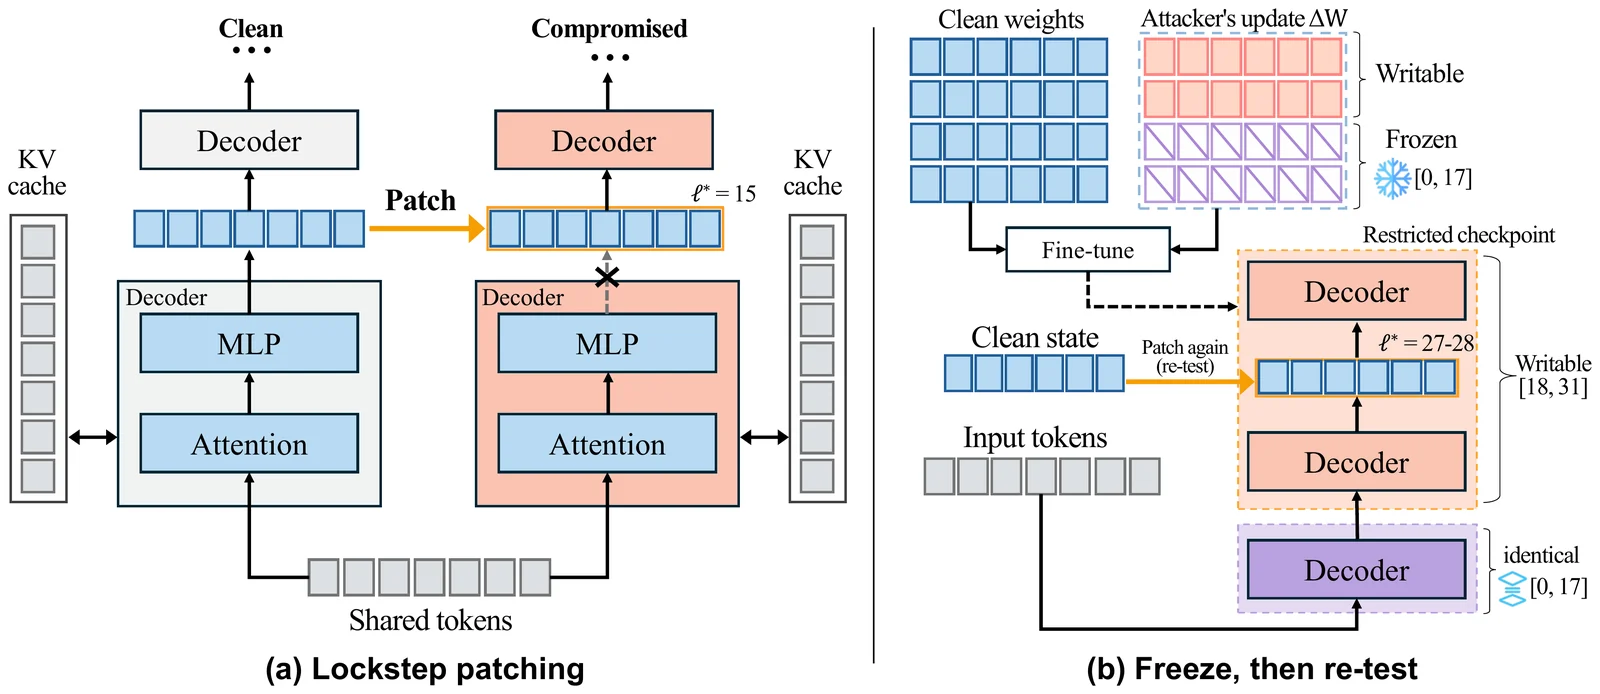
(a) 同步激活补丁在预填充和每个解码步骤用干净状态覆盖受损模型的层输出。(b) 在匹配的 Llama 攻击中,冻结第 0–17 层会将半上限过渡从 15 移到 27–28。
pip install "git+https://github.com/js-lee-AI/refusal-relocates.git"
import numpy as np
import refusal

rng = np.random.default_rng(0)
A = rng.standard_normal((16, 512)) / 512 ** 0.5    # LoRA factors of one module, rank 16
B = rng.standard_normal((512, 16)) / 16 ** 0.5
for name, decay in [("ordinary", 0.5), ("spread", 1.0)]:
    b = B * decay ** np.arange(16)                  # energy in a few directions, or spread flat
    before, after = refusal.update_stats(A, b), refusal.update_stats(*refusal.remove_top_k(A, b, k=2))
    print(f"{name:8s}  PR/r {before['pr_over_r']:.2f}  top-2 energy {before['top2_energy_fraction']:.2f}"
          f"  norm left after top-2 removal {after['unscaled_norm'] / before['unscaled_norm']:.2f}")
# ordinary  PR/r 0.10  top-2 energy 0.94  norm left after top-2 removal 0.24
# spread    PR/r 0.94  top-2 energy 0.18  norm left after top-2 removal 0.90
普通微调会把大部分更新集中在少数几个奇异方向上,因此移除前两个方向就会剥离掉大部分更新。分散式更新的频谱是平坦的,所以同样的移除操作会保留其中大部分内容。PR/r,即 LoRA 秩上的参与率,也是论文中频谱检测器的得分。
这段代码在 CPU 上运行约需一秒,且不下载任何内容。相同的代码位于 examples/quickstart.py,CI 会在每次推送时运行它。
要训练、修补并评估真实检查点,请安装 models 附加组件。
pip install "refusal-relocates[models] @ git+https://github.com/js-lee-AI/refusal-relocates.git"
| 安装 | 添加 | 足以支持 |
|---|---|---|
pip install "git+https://github.com/js-lee-AI/refusal-relocates.git" | numpy | 谱核心、top-k 移除、检测器、拒绝评分器、refusal 命令 |
pip install "refusal-relocates[models] @ git+https://github.com/js-lee-AI/refusal-relocates.git" | torch、transformers、peft、accelerate、safetensors、scikit-learn、datasets | 在模型上进行训练、lockstep 补丁、探针和评估 |
git clone 然后 pip install -e ".[models,test]" | pytest | experiments/、records/ 和 tests/ |
已在 Python 3.11.5、PyTorch 2.10.0、Transformers 4.57.3 和 PEFT 0.18.0 上测试。模型在 CUDA 设备上以 bfloat16 加载。
import refusal

data = refusal.load_data("data/prompt_sets.json")        # built by `refusal prepare`, see below
prompts = data["advbench"][:40]
clean, tokenizer = refusal.load_model("meta-llama/Llama-3.1-8B-Instruct")
attacked, _ = refusal.load_model("meta-llama/Llama-3.1-8B-Instruct", adapter="runs/attack/adapter")

for layer in [6, 9, 12, 15, 18]:
    responses = refusal.lockstep_generate(clean, attacked, tokenizer, prompts, layer=layer)
    print(layer, sum(refusal.is_refusal(r) for r in responses) / len(prompts))
两个模型读取相同的 token,在选定的层上,被污染模型的输出被干净模型的输出替换。refusal patch 运行完整测量,包括其下限、上限和两个对照,使用困惑度门控和 Llama-Guard 对连贯拒绝进行评分,并报告过渡深度。
import refusal

stats = refusal.update_stats(A, B)                 # one module, A is rank x in and B is out x rank
A2, B2 = refusal.remove_top_k(A, B, k=2)           # the top-two repair, as new LoRA factors
result = refusal.calibrate_detector(benign_scores, attack_scores, budget=0.05)
适配器的检测器分数是其注意力投影上 PR/r 的平均值,refusal spectra 会在 CPU 上从已保存的适配器计算该值。
| 调用 | 功能 | 依赖 |
|---|---|---|
refusal.update_stats(A, B) | 单个 LoRA 更新的参与率、PR/r、top-2 能量和范数 | 基础安装 |
refusal.remove_top_k(A, B, k) | 移除 k 个最大奇异方向后的更新因子 | 基础安装 |
refusal.calibrate_detector(benign, attacks, budget) | 在良性误报预算下的阈值,以及它标记的攻击 | 基础安装 |
refusal.is_refusal(text)、refusal.summarize(...) | 显式拒绝模式、带困惑度门控的连贯拒绝 | 基础安装 |
refusal.transition_depth(rows, ceiling, floor, rescaled=True) | 首个达到至少半程恢复的已修补层 | 基础安装 |
refusal.prepare(...)、refusal.load_data(path) | 从公开数据重建并验证冻结的提示集 | 基础安装 |
refusal.load_model(name, adapter=...) | 以 bfloat16 加载检查点,可选带 LoRA 适配器 | [models] |
refusal.lockstep_generate(clean, attacked, tokenizer, prompts, layer) | 在某一层修补干净状态后的贪心解码 | [models] |
refusal.add_adapter(model, freeze="bottom", n_frozen=18) | 仅在可写层上应用 LoRA | [models] |
refusal.remove_top(model, k)、refusal.adapter_stats(path) | 对已加载或已保存的适配器进行 top-k 修复和谱统计 | [models] |
标记为基础安装的调用无需 torch 即可导入。重型模块会在首次使用其名称时加载。
安装该包会添加一个 refusal 命令,python -m refusal 运行相同的功能。
refusal --help
refusal demo                                                    # the quickstart, on CPU
refusal prepare --pku ... --alpaca ... --advbench ... --xstest ...   # rebuild the frozen prompt sets
refusal train --freeze bottom --n-frozen 18 --out runs/freeze   # LoRA attack with layers 0 to 17 frozen
refusal patch --adapter runs/freeze/adapter --out runs/freeze/patch     # lockstep patching
refusal evaluate --adapter runs/freeze/adapter --ranks 1,2,4 --out runs/freeze/evaluate
refusal spectra --adapter runs/freeze/adapter --out spectrum.json        # on CPU
refusal detector --benign benign/*.json --attacks attacks/*.json --out detector.json
在一百个有害示例上,所有六个检查点的拒绝率仍接近零,恢复转变均高于冻结边界。
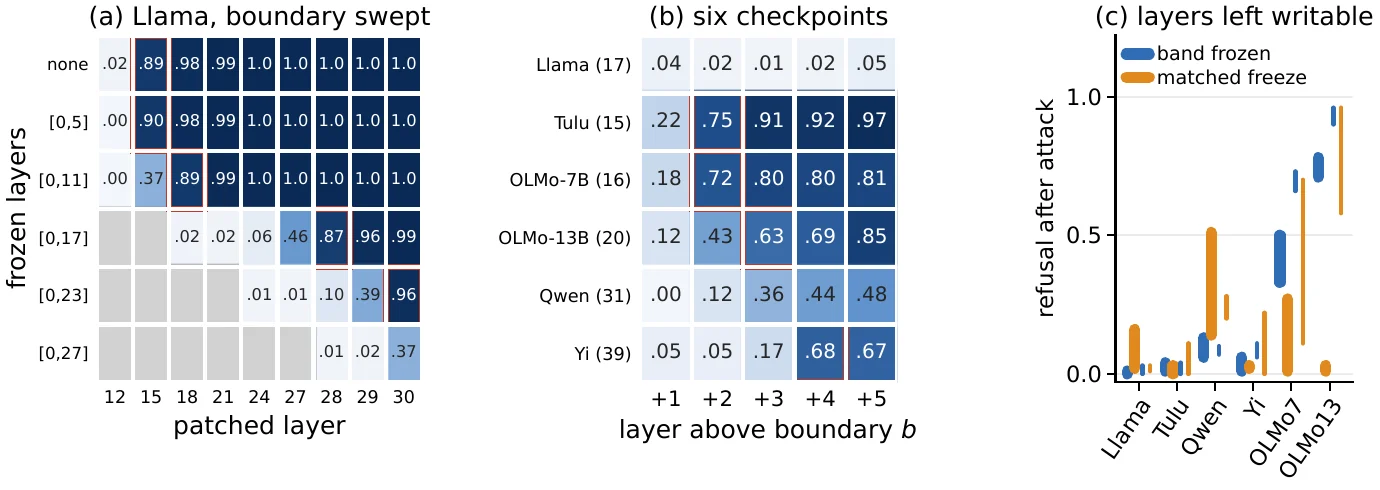
图 5。(a, b) 恢复率从受攻击下限重新缩放到干净上限。灰色单元格为冻结层,轮廓标记了在所有随机种子中恢复率达到至少半量程的第一个实测层。(c) 粗条和细条分别保留两层或一层可写层。
在无法写入冻结层的攻击之后,AdvBench 上的连贯拒绝率和 Llama-Guard 不安全率。剂量 100,每个检查点三个随机种子,范围为种子间范围。Matched 在其他位置冻结相同数量的层。拒绝率越高、不安全率越低越好。