一条可复现的分析流水线,将 AI 安全素养的六个能力维度锚定在公开基准测试和具有全国代表性的调查数据之上。在 Google Colab 中运行。每一个产物——数据集缓存、模型检查点、图表、结果表格——都持久化到 Google Drive,且每个阶段都可断点续跑。
AI 进入校园的速度,快过任何关于如何安全使用它的指导。学生们被交到黑箱系统手中,并被期望凭直觉判断这些系统可以被信任去做什么。教师们则在接纳 AI 与恐惧 AI 之间分裂。各学区正在编写可接受使用政策,而政策底下的工具每隔几个月就变一次。
现有的素养框架教学生去理解和使用 AI。现有的网络安全框架则是在 AI 特有的威胁出现之前写就的。两者都没有把在 AI 中介的环境中安全地操作当作一项独立的能力——拥有自己的维度、自己的发展进阶、自己的可教学技能。
这正是 AISL 所定义的能力,横跨六个维度,覆盖整个学校生态系统,而不仅仅是学生。
一个从未对照数据检验过的能力框架,不过是一份分类表。任何人都可以断言学生应当"识别操纵"或"校准信任"。更难的问题是:这些说法是否指向真实、可测量的现象——如果是,测量结果究竟显示了什么。
这正是本流水线的用途。它追问公开数据能就每个维度确立什么,而答案是具体的:
以上每一点,都是学习者可以借助真实模型和真实数据被引导着走完的一堂课,而这正是关键所在:这个框架是用来教的,而不只是用来引用的。
一条流水线可以产出看起来正确、实则不然的图表:一条来自从未被正确训练的模型的鲁棒性曲线,或者因为两个文件按行位置拼接而挂到错误类别上的基准测试结果。这些正是该框架最进阶的维度教学生去捕捉的同类失败。
因此,这条流水线的构建目标就是让这些问题在结构上难以出现:攻击评估以干净准确率的合理性检查为前提,连接基于内容而非位置进行,被阻塞的阶段会主动声明自身状态而不是输出空结果,采样设有随机种子,并且每一个报告的数字都会写入机器可读的结果文件,而不是靠手工转录。在这里,可复现性并非杂务——它本身就是主题。
该流水线分为两个层级运行。
第 1 层基于全国代表性调查微观数据来为态度维度提供依据,这些数据需要你在免费注册后自行下载。在文件就位之前,其各阶段会将自身标记为 skipped。参见第 1 层设置。
第 2 层基于公开来源为技术维度提供依据。无需配置——打开即可运行。所有数据集都会自动下载。
| 维度 | 第 1 层(调查) | 第 2 层(公开数据) | |
|---|---|---|---|
| D1 | 许可与规范 | RAND ATP Fall 2025, Pew ATP W142 | — |
| D2 | 数据与隐私安全 | Pew ATP W152 | — |
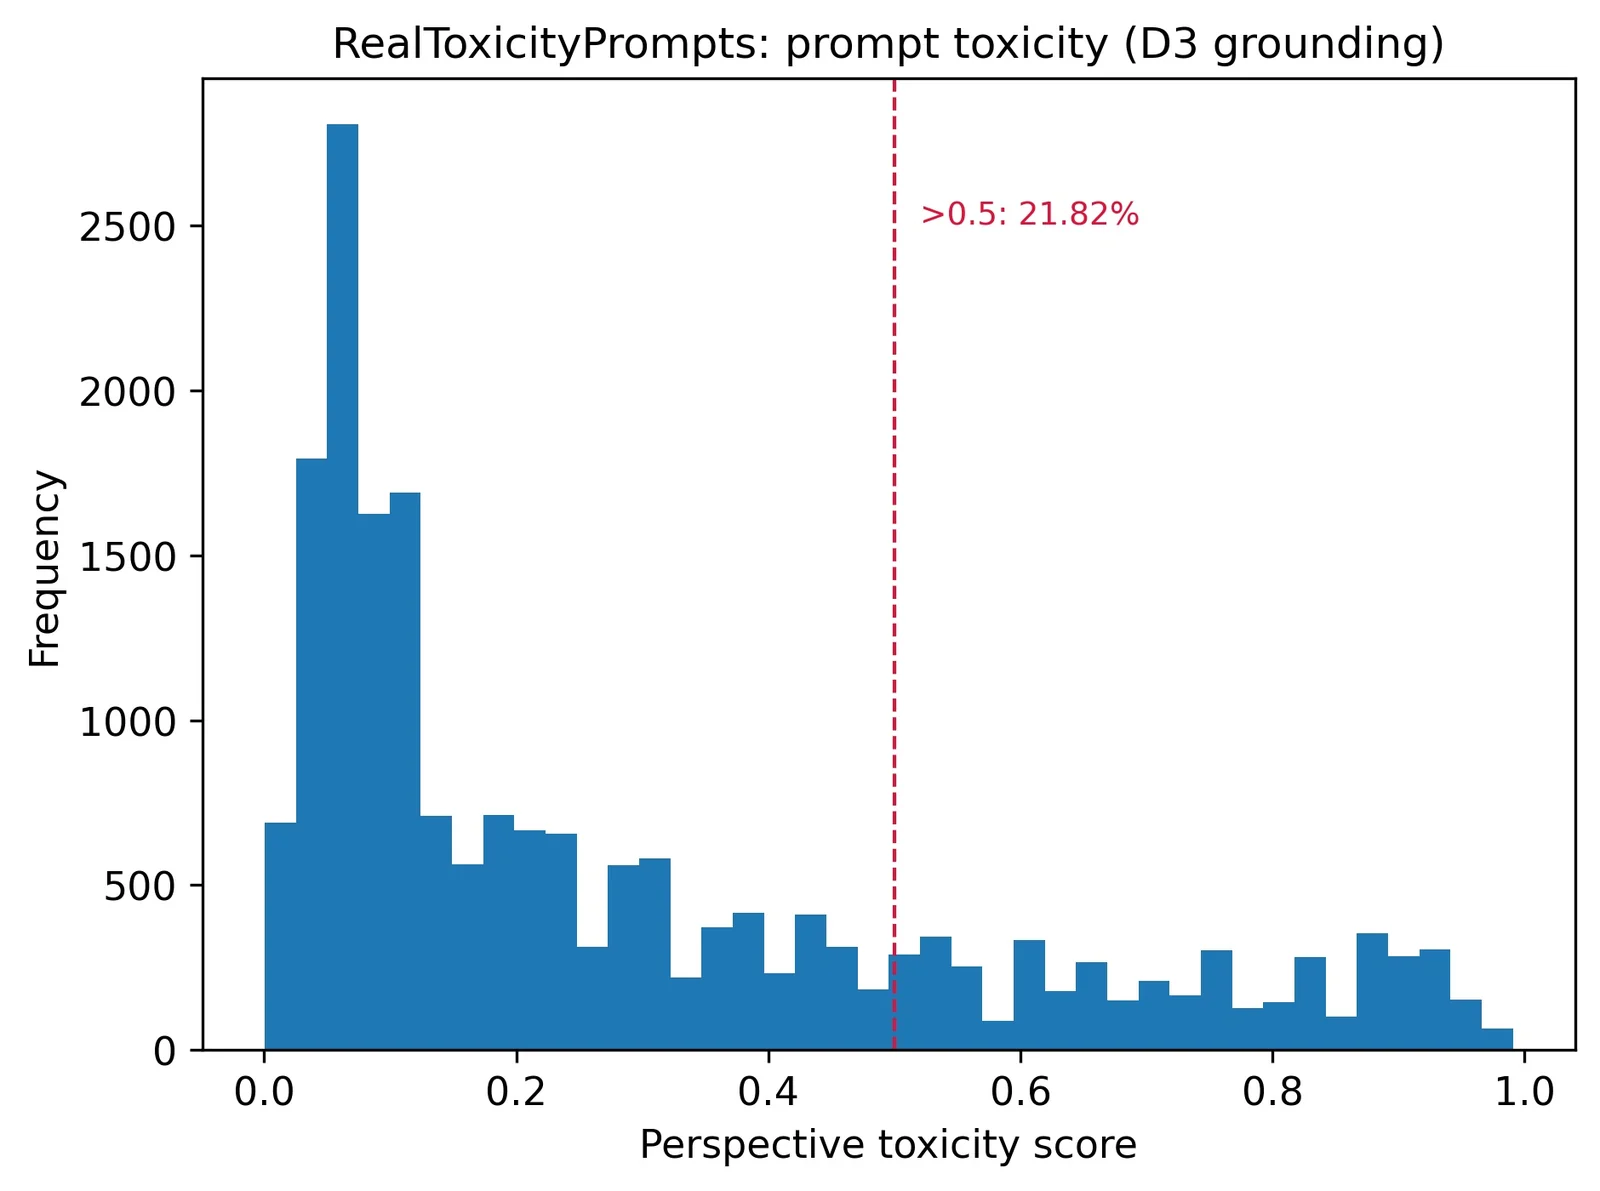
| D3 | 威胁与操纵识别 | Pew ATP W152, W168 | RealToxicityPrompts, SMS Spam Collection, BBQ |
| D4 | 信任校准与验证 | Pew ATP W142, W152 | TruthfulQA + GPT-2 baseline, BBQ |
| D5 | 对抗性与技术理解 | — | CIFAR-10 + FGSM/PGD, 3 seeds |
| D6 | 倾向与能动性 | RAND ATP Fall 2025, Pew ATP W152 | — |
在 Colab 中打开 AISL_analysis_poc.ipynb,从上到下运行所有单元格。
Runtime > Change runtime type > GPU     # optional; D5 training is ~10x faster
Runtime > Run all
首次运行会下载 CIFAR-10(约 170 MB)、Hugging Face 语料库、GPT-2 以及 SMS Spam Collection。它们都会缓存到 Drive,绝不会 被重复下载。 该运行可在任意时刻安全中断——参见 恢复运行。
如果你在 Colab 会话打开期间向 Drive 添加了调查文件,请在重新运行前重启
会话(Runtime > Restart session):Colab 并不总能识别在 Drive 挂载之后
添加的文件。
所有持久化内容都位于 MyDrive/AISL_data/ 下。不会有任何有价值的内容
写入临时的 Colab 磁盘。
AISL_data/
├── cache/
│   ├── hf/                    # Hugging Face datasets and GPT-2
│   └── torch/                 # CIFAR-10
├── checkpoints/
│   └── cifar10_cnn_seed{N}.pt # one per seed, written after every epoch, atomically
├── figures/                   # 300-dpi JPGs
├── tables/                    # CSV + JSON + TeX macro exports
├── logs/
│   └── status.json            # per-stage completion record
└── microdata/
    ├── sms/                   # SMS Spam Collection (downloaded automatically)
    ├── pew/                   # <- you place the Pew ATP .sav files here
    └── rand/                  # <- you place the RAND ATP .dta file here
结果以三种格式导出:aisl_results.json(机器可读)、各阶段的 .csv 文件,以及 aisl_results.tex(一组 TeX 宏,每个报告值对应一个,供下游排版使用)。
| 阶段 ID | 维度 | 数据 | 输出 |
|---|---|---|---|
d3_rtp | D3 | allenai/real-toxicity-prompts | d3_rtp_toxicity.jpg、d3_rtp_summary.csv |
d4_truthfulqa | D4 | truthfulqa/truthful_qa(generation) | d4_truthfulqa_categories.jpg + CSV |
d4_baseline | D4 | TruthfulQA(multiple_choice)+ gpt2 | d4_truthfulqa_baseline.jpg + CSV |
d34_bbq | D3、D4 | walledai/BBQ(11 个属性配置) | d34_bbq_configs.jpg、d34_bbq_counts.csv |
d5_train | D5 | CIFAR-10,3 个随机种子 | cifar10_cnn_seed{N}.pt |
d5_fgsm | D5 | CIFAR-10 + torchattacks | d5_fgsm_sweep.jpg + CSV |
d3_threshold | D3 | RealToxicityPrompts | d3_threshold_sensitivity.jpg + CSV |
d5_pgd | D5 | CIFAR-10 + torchattacks | d5_attack_comparison.jpg + CSV |
d3_sms | D3 | UCI SMS Spam Collection | d3_sms_threshold.jpg + CSV |
tier1_pew_inventory | Tier 1 | microdata/pew/ 中的 Pew ATP 文件 | pew_item_inventory.csv |
tier1_rand_inventory | Tier 1 | microdata/rand/ 中的 RAND 文件 | rand_item_inventory.csv |
tier1_mapped | D1–D4、D6 | Pew ATP + RAND ATP | tier1_survey_evidence.jpg、tier1_mapped_results.csv |
另外两个单元格会写出汇总表(grounding_matrix、alignment_matrix)和 TeX 宏文件,最后一个单元格会打印完整的运行报告。Tier 1 阶段之后的一个可选单元格会从已保存的结果表重绘 tier1_survey_evidence.jpg 以供打印,而不重新计算任何内容。
每个阶段都会在 logs/status.json 中记录 ok / failed / skipped 状态,并附带时间戳和摘要。
已完成的阶段会自动跳过。训练会从最后保存的 epoch 继续。
status_report()              # what has run, when, and what it produced
reset_stage('d5_fgsm')       # force one stage to re-run
reset_stage()                # force everything to re-run
检查点、状态写入和结果文件都通过 os.replace 完成,因此运行中断也不会留下写了一半的文件。
第一层使用四个调查文件,每个文件注册后均可免费下载。将它们放入下面的文件夹;各阶段会自动找到它们。
Pew Research Center — American Trends Panel(美国成年人)→ microdata/pew/
.sav 文件放入 microdata/pew/。RAND American Educator Panels — American Teacher Panel(美国公立学校教师)→ microdata/rand/
.dta 文件放入 microdata/rand/。不要同时把 CSV 放在那里。清单阶段会列出每个文件中所有相关条目及其加权分布。随后,映射阶段会为分配给某个维度的每个条目计算给出所述回答的加权占比,以及基于 Kish 有效样本量的 95% 区间。每个条目所计入的回答类别固定在该单元格的 SPEC 表中,并打印在每个估计值旁边,因此每个数字都可以对照问卷进行核查。
random、numpy 和 torch 设置全局种子;每个 D5 模型和攻击都单独设置种子,并且 cuDNN 以确定性模式运行。tables/aisl_results.json 并导出为 TeX 宏;没有任何数字是手工转录的。Colab 提供了除 torchattacks 和 pyreadstat 之外的所有内容。torchattacks 由 notebook 安装(固定为 3.5.1,不安装其依赖项,以免降级环境);pyreadstat 由第一层各阶段在首次使用时安装,用于读取 .sav 和 .dta 文件。
流水线生成的每一张图表都位于 figures/ 中,并附有其展示内容和重要性的说明。所有图表均由 notebook 以 300 dpi 生成;没有一张是手工绘制的。
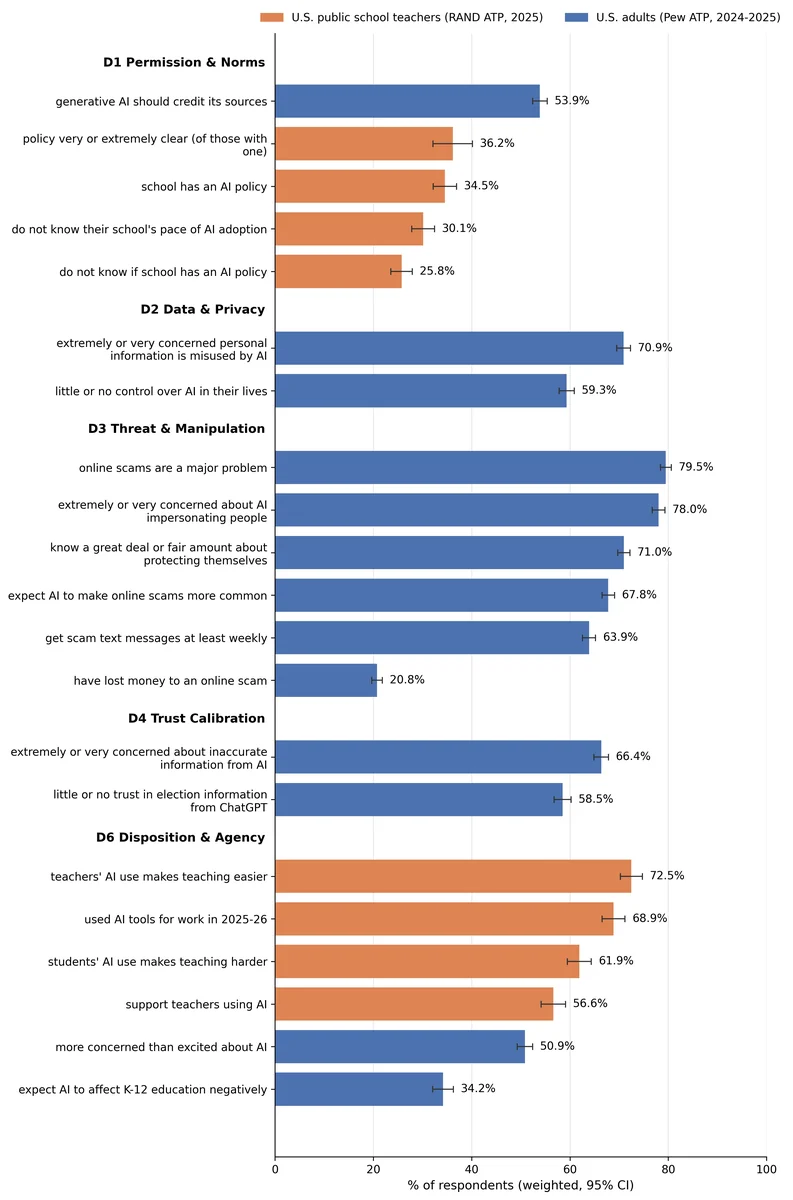
tier1_survey_evidence.jpg — 21 个调查条目中每个条目给出所述回答的受访者加权占比,按维度分组,并附 95% 区间。橙色柱是美国公立学校教师(RAND ATP,2025 年秋季);蓝色柱是美国成年人(Pew ATP,2024–2025 年)。
意义: 它表明 D1、D2、D3、D4 和 D6 背后的现象在学生周围的人群中普遍存在。只有 34.5% 的教师报告学校有 AI 政策,25.8% 的教师不知道是否存在这样的政策;79.5% 的成年人称网络诈骗是一个重大问题;72.5% 的教师表示自己使用 AI 使教学更容易,而 61.9% 的教师表示学生使用 AI 使教学更难。
阈值敏感性
d3_threshold_sensitivity.jpg — 左图:随着分类阈值从 0.1 移动到 0.9,被标记为有毒的 RealToxicityPrompts 提示占比。右图:提示半句如何落入四个毒性区间,而其父句子是从这些区间中等比例抽样的。
意义: 左图表明“有毒”标签是阈值的选择,而不是文本本身的属性——从 0.3 移动到 0.7 会使有毒占比变化 23.2 个百分点。右图表明,60% 的提示半句位于最低区间,尽管完整句子是从所有四个区间等比例抽取的,因此有害文本的开头往往看起来无害。
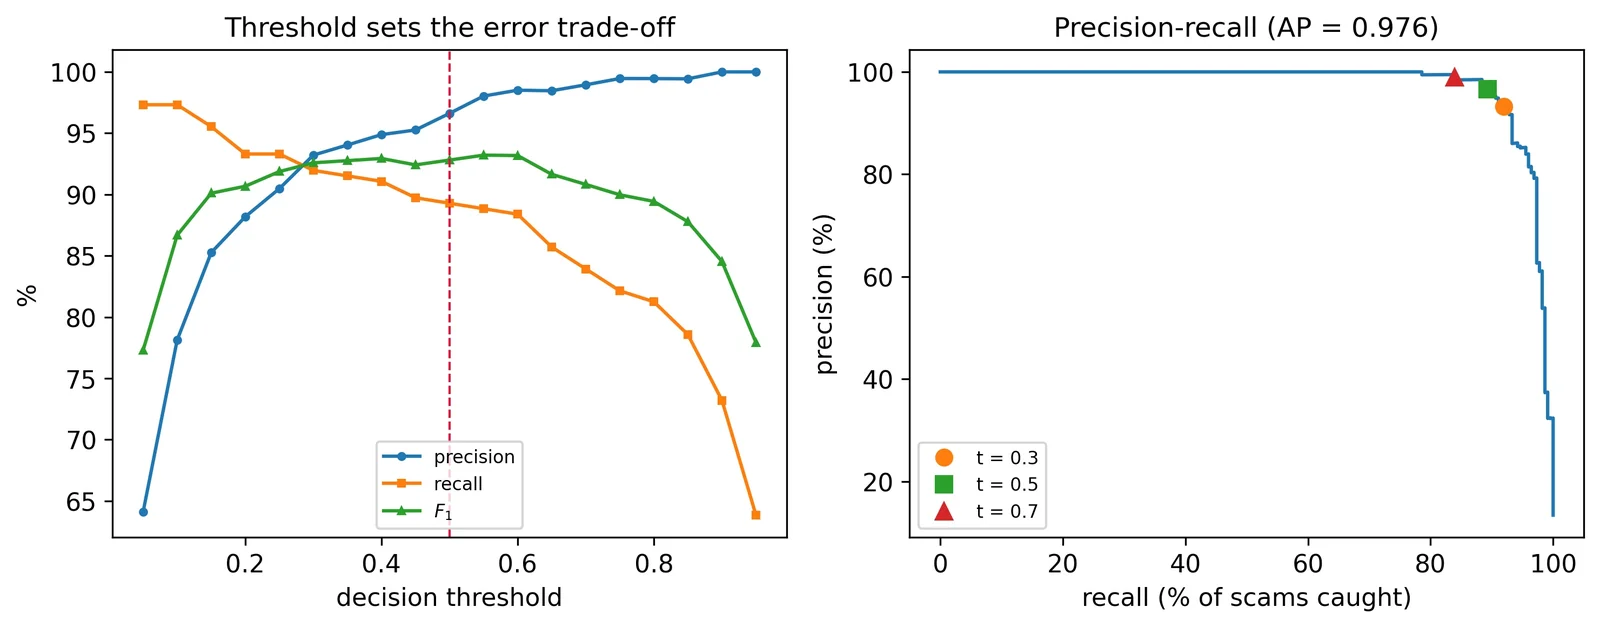
d3_sms_threshold.jpg — 左图:诈骗文本分类器在不同决策阈值下的精确率、召回率和 F1。右图:其精确率–召回率曲线(平均精确率 0.976),并标出了阈值 0.3、0.5 和 0.7 处的操作点。
为什么: 在真实诈骗短信上呈现同样的阈值教训。将阈值从 0.3 提高到 0.7,误报从 15 降到 2,但漏检的诈骗从 18 翻倍到 36。没有任何阈值能同时消除这两类错误;必须有人做出选择并为这一权衡辩护。