基于AgentField的AI原生代码安全审计器,通过判定、追踪和可操作证据证明可利用性。
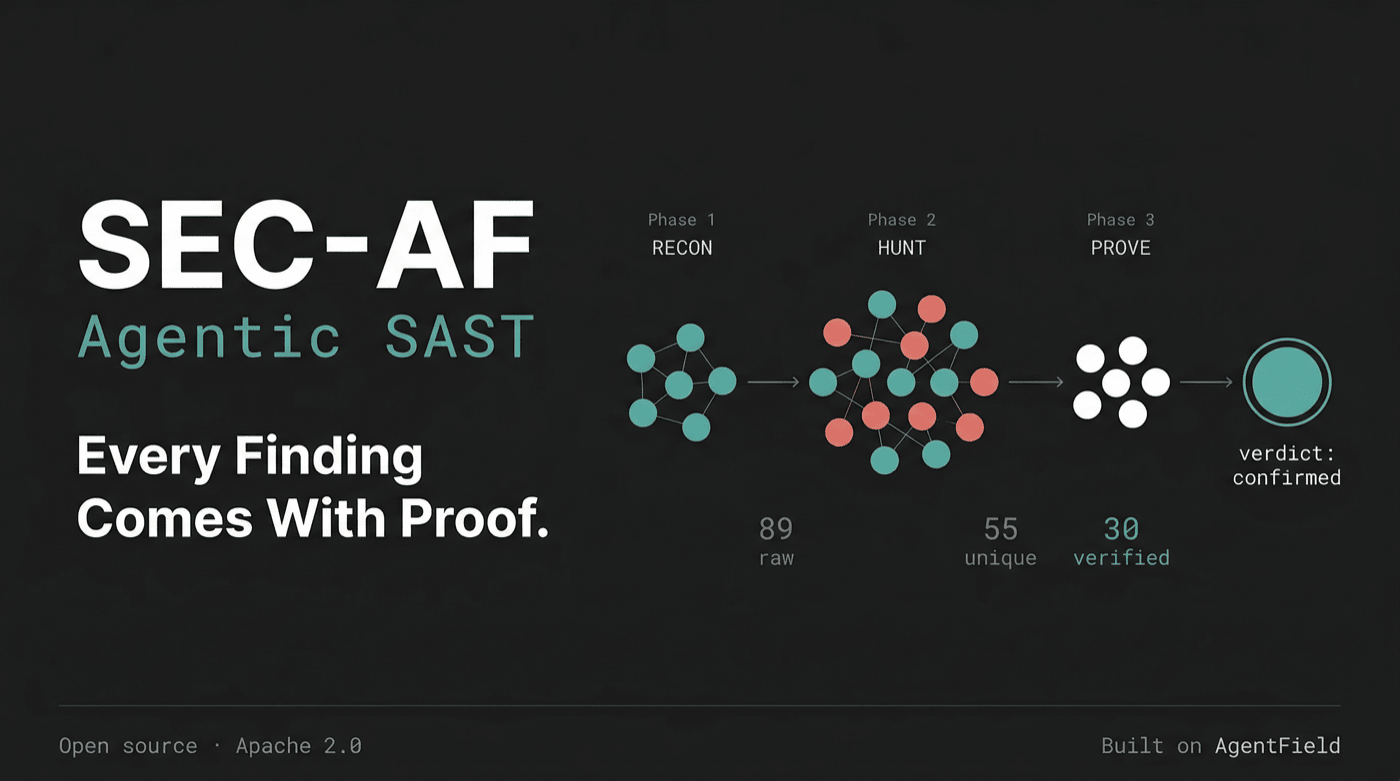
其他工具只标记模式。SEC-AF 证明可利用性:每一项发现都附带结论、数据流追踪以及可供你采取行动的证据。免费、开源、一次 API 调用即可。一次包含 30 项已验证发现的完整审计,LLM 调用成本约为 $1.40。
通过 af CLI 触发(需要 af ≥ 0.1.87)——它会实时流式输出进度并打印结果:
af call sec-af.audit --in '{"repo_url": "https://github.com/dolevf/Damn-Vulnerable-GraphQL-Application"}'
更喜欢直接使用原始 HTTP?用 curl 直接调用 API:
curl -X POST http://localhost:8080/api/v1/execute/async/sec-af.audit \
  -H "Content-Type: application/json" \
  -d '{"input": {"repo_url": "https://github.com/dolevf/Damn-Vulnerable-GraphQL-Application"}}'
这是 SEC-AF 审计 DVGA(一个故意存在漏洞的 GraphQL 应用)时得到的一个真实发现:
{
  "title": "OS Command Injection in run_cmd Helper Function",
  "severity": "critical",
  "verdict": "confirmed",           // not "maybe" — confirmed exploitable
  "evidence_level": 5,
  "cwe_id": "CWE-78",

  "rationale": "Tracer confirms complete data flow from GraphQL parameters
    (host, port, path, scheme, cmd, arg) to os.popen(cmd).read() sink.
    Sanitization functions are bypassable in Easy mode...",

  "proof": {
    "verification_method": "composite_subagent_chain:sast",
    "data_flow_trace": [
      { "description": "core/views.py:203 — GraphQL args defined (host, port, path, scheme)", "tainted": true },
      { "description": "core/views.py:210 — URL constructed from user input", "tainted": true },
      { "description": "core/views.py:211 — helpers.run_cmd(f'curl {url}') called", "tainted": true },
      { "description": "core/helpers.py:9 — os.popen(cmd).read() executes input", "tainted": true }
    ]
  },

  "location": {
    "file_path": "core/helpers.py",
    "start_line": 9,
    "code_snippet": "def run_cmd(cmd):\n  return os.popen(cmd).read()"
  }
}
每个发现都包含一个判定(confirmed / likely / inconclusive / not_exploitable)、一个带有完整污点追踪的证明对象,以及确切的代码位置。而不是“这可能是个问题”。SEC-AF 从源到汇追踪数据,并证明它是否真的可利用。
完整基准输出(30 个发现):
exampl/dvga-benchmark-result.json| 性能分析:exampl/benchmark-analysis.json
我们针对 Damn Vulnerable GraphQL Application 运行 SEC-AF,这是一个故意存在漏洞的应用,包含 21 个已记录的安全场景。
| 指标 | 值 |
|---|---|
| 发现的原始发现数 | 106 |
| AI 去重后 | 61 |
| 对抗性验证后 | 28 个已确认 |
| 不确定(需要人工审查) | 1 |
| 不可利用(被正确拒绝) | 1 |
| 噪声减少 | 94% |
| DAG 边(推理器调用) | 82 |
| 代理调用 | ~166–255 |
| 运行的策略 | 11 |
| 实际耗时 | ~78 分钟 |
| 预估成本(Kimi K2.5) | ~$0.18–$0.90 |
| 类别 | 数量 | 示例 |
|---|---|---|
| 缺失身份验证 | 8 | ImportPaste、delete_all_pastes、system_debug、CreateUser、文件上传 |
| 命令注入 | 4 | 通过 ImportPaste、system_debug、system_diagnostics 的 os.popen(cmd) |
| SQL 注入 | 3 | resolve_pastes 中未净化的 filter、LIKE 模式注入、登录 |
| 身份验证绕过 | 3 | JWT 签名禁用、JWT 授权绕过、损坏的密码认证 |
| 明文凭据 | 3 | 明文密码存储、明文比较、诊断中的密码 |
| SSRF | 2 | ImportPaste mutation 在服务端跟随用户提供的 URL |
| 业务逻辑 / URL 净化 | 2 | URL 净化不充分、未认证的大规模删除 |
| DoS / 资源耗尽 | 3 | 用户/审计查询缺少分页、未受控的 simulate_load |
| 配置 / 机密 | 2 | 硬编码的 JWT/Flask 机密、生产环境启用调试模式 |
SEC-AF 应用了若干架构模式,这些模式通过组合许多专注的 AI 代理而不是运行单一的整体扫描而独特地实现。这些模式解决了 AI 驱动安全分析中的根本挑战。
1. 对抗性代理张力(HUNT 与 PROVE)
大多数 AI 安全工具询问单个模型“这是否存在漏洞?”并接受答案。SEC-AF 在结构上将_发现_代理与_反驳_代理分开。猎手被激励去发现漏洞;证明者被激励去反驳它们。每个发现都经过一个 4 代理验证链——追踪器重建数据流,净化分析器寻找猎手可能遗漏的缓解措施,利用假设器构建具体的攻击场景,判定代理权衡所有相互矛盾的证据。代理之间的这种对抗性张力正是推动 94% 噪声减少的原因——架构本身编码了怀疑精神。
2. 具有渐进式收窄的信号级联
管道不是将所有发现倾倒在用户身上,而是在每个阶段压缩信号:106 个原始发现 → AI 去重后 61 个 → 对抗性验证后 30 个。每个阶段都是一个过滤器。这反映了人类安全团队的分诊方式——先广泛发现,然后逐步更严格的审查。关键洞察是每个过滤器都是_不同种类_的 AI 推理:用于去重的语义相似性、用于验证的污点分析、用于确认的利用构建。
3. 通过上下文修剪实现信息经济
LLM 在获得无关上下文时更容易产生幻觉。SEC-AF 只向每个 agent 路由其所需的信息:注入漏洞猎手收到的是裁剪为数据流图和输入入口点的侦察上下文,而加密漏洞猎手收到的是依赖树和密钥管理模式。验证器收到的是投影后的发现视图,其中仅包含其特定验证方法所需的字段。这种按策略进行的上下文裁剪既减少了幻觉,也降低了成本——agent 不会因为看到自己本不该看到的信息而混淆。
4. 流式阶段重叠
传统流水线按顺序运行:完成侦察,然后开始狩猎,再开始证明。SEC-AF 通过 asyncio.Queue 让各阶段重叠——猎手在侦察输出到达时即开始消费,去重模块在每个猎手完成时即处理其发现。证明器在后续猎手仍在运行时就开始验证首批去重后的发现。这种流式架构在不牺牲信号级联的前提下缩短了实际耗时——每个发现仍然要经过每一道过滤器,只是更早而已。
5. 通过 AI 门控实现动态路由
流水线在运行时根据其发现进行自适应。AI 门控会检查侦察输出并选择要激活哪些狩猎策略——一个带 JWT 认证的 Flask 应用会触发与一个使用 gRPC 的 Go 微服务不同的猎手。一个独立的 CWE 扩展门控会根据检测到的技术栈动态扩展漏洞目标列表。可达性门控会在将验证资源浪费在不可达代码上之前,评估依赖漏洞是否具有可利用的调用路径。
6. 面向编码 agent 的引导式自主
SEC-AF 通过 AgentField harness 运行在编码 agent(AForge、Claude Code、OpenCode、Codex)之上。每个推理器不是给 agent 一个巨大的提示词,而是提供阶段感知的引导式自主:agent 收到一个狭窄的任务定义、一个扁平输出 schema(2-4 个字段)以及策略特定的上下文。agent 在这些边界内拥有完全自主权——它可以读取文件、追踪代码并自由推理——但 harness 约束其输出的_形状_。这避免了自主 agent 偏离任务或产生非结构化结果的常见失败模式。
7. 具备完整可观测性的可组合推理器 DAG
每次 agent 调用都流经 AgentField 控制平面,从而创建出审计的完整有向无环图。你可以看到哪个猎手发现了哪个发现、每次验证耗时多久、证明器生成了什么证据,以及流水线把时间花在了哪里。添加一个新的漏洞类别只需一个文件——一个新的猎手。编排器会发现它、将上下文路由给它,并将其发现集成到现有的去重 → 证明 → 修复流水线中。DAG 即架构。
9 个遗漏的场景主要是 GraphQL 协议层攻击:批量查询、深度递归、别名滥用、字段重复、内省暴露。这些需要运行时/DAST 分析。SEC-AF 目前以 SAST 为重点。协议层检测已在路线图中。
SEC-AF 建立在 Composite Intelligence 理念之上:它不依赖单一的庞大 LLM 调用,而是将许多聚焦的、引导式的 LLM 调用组合成一个推理器 DAG,由架构本身来编码智能(关于此模式的深入探讨,参见 The Atomic Unit of Intelligence)。每次 LLM 调用处理一个小的、定义明确的任务,并使用扁平的 Pydantic schema(2-4 个属性)。编排器管理上下文流、并行性和动态路由。
每个阶段都是一个 @reasoner,通过 AgentField 控制平面调用子推理器,对于给定查询,总计约有 200-300 个 agent 同步工作:
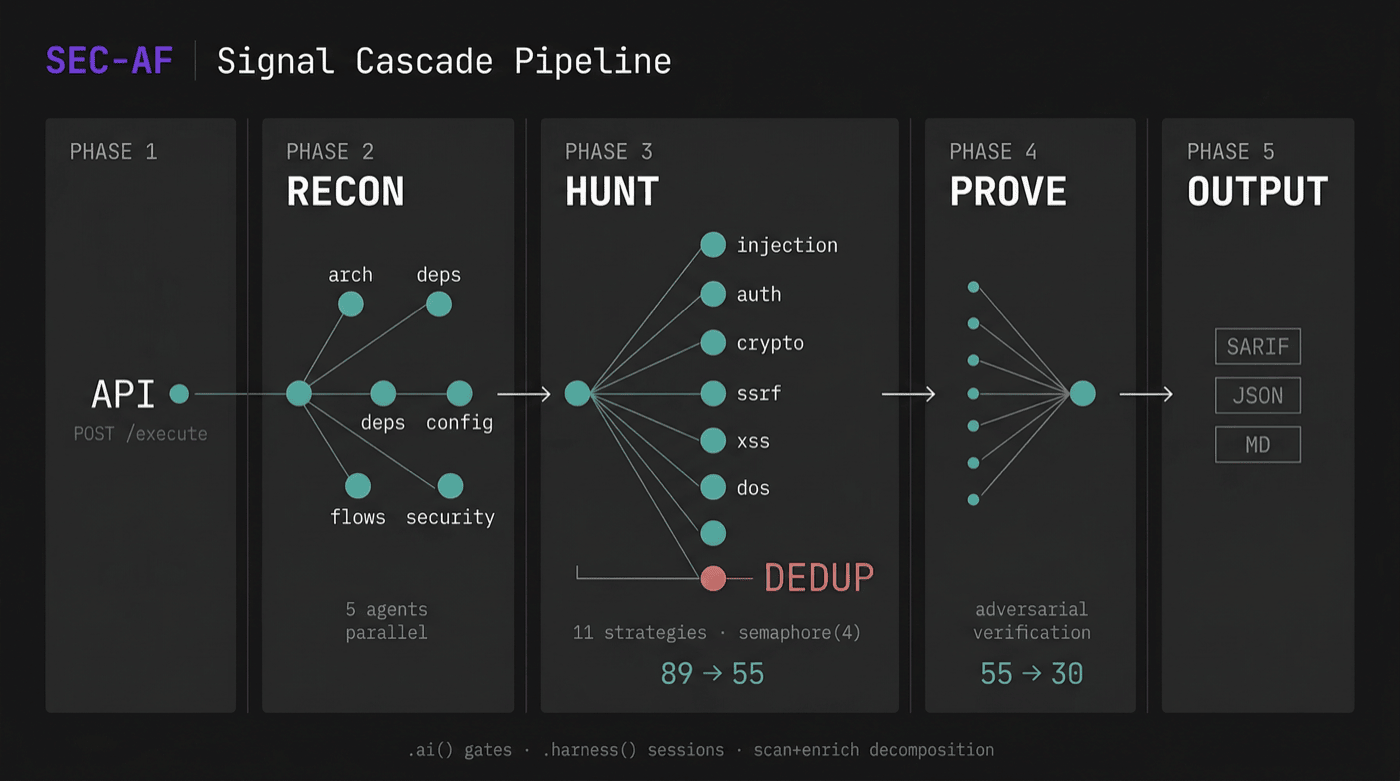
每个阶段都会收窄信号。原始发现会经过逐步严格的关卡过滤:
| 阶段 | 用途 | 并行度 |
|---|---|---|
| RECON | 梳理架构、依赖、数据流、安全上下文 | 3 路并行(架构 + 依赖 + 配置),然后 2 路并行(数据流 + 安全) |
| HUNT | 运行 10+ 个专用策略猎手 | 信号量限定的并行(默认 4 并发),并带增量去重 |
| PROVE | 对抗性验证:尝试证伪每个发现 | 信号量限定的并行(默认 3 并发) |
| REMEDIATION | 为已确认/可能的发现生成修复建议 | 信号量限定的并行(默认 3 并发) |
大多数 AI 安全工具运行一个大提示词,然后指望 LLM 能正确处理。SEC-AF 将问题分解为约 258 次聚焦的智能体调用,每次调用都使用扁平 schema(2-4 个字段)和狭窄的任务。该架构编码的是推理策略,而不是提示词(关于为何这很重要,请参阅 The Atomic Unit of Intelligence)。