fnprint 根据函数做什么来匹配二进制文件中的函数,而不是根据它们的字节或控制流图长什么样。它在一个小型模拟器中用虚构的输入运行每个函数,记录它产生的副作用,并将该行为哈希成一个指纹。行为相同的两个函数会得到相似的指纹,即使它们是由不同的编译器、在不同的优化级别、或为不同的 CPU 构建的。
这样做的意义在于:字节签名(FLIRT、FunctionID)在代码重新编译的那一刻就会失效,而 CFG 匹配器(BinDiff、Diaphora)在 -O0 与 -O3 之间会变得不稳定,跨架构时更是直接放弃。行为在所有这些情况下都能更好地存活下来。无需训练数据,无需模型,一个静态二进制文件。
它做了三件其他工具做不到的事:
-O0 对比 aarch64 -O0:97.7% 的函数命名正确。triage 给你的是裁决,而不是差异。 两个语料库(已知漏洞、已修补)、一个余量,以及一个倾向于漏洞的函数审查队列。这就是把 n-day 工作流变成一条命令。支持 x86-64 和 aarch64 ELF。在信任它之前,请先看局限。
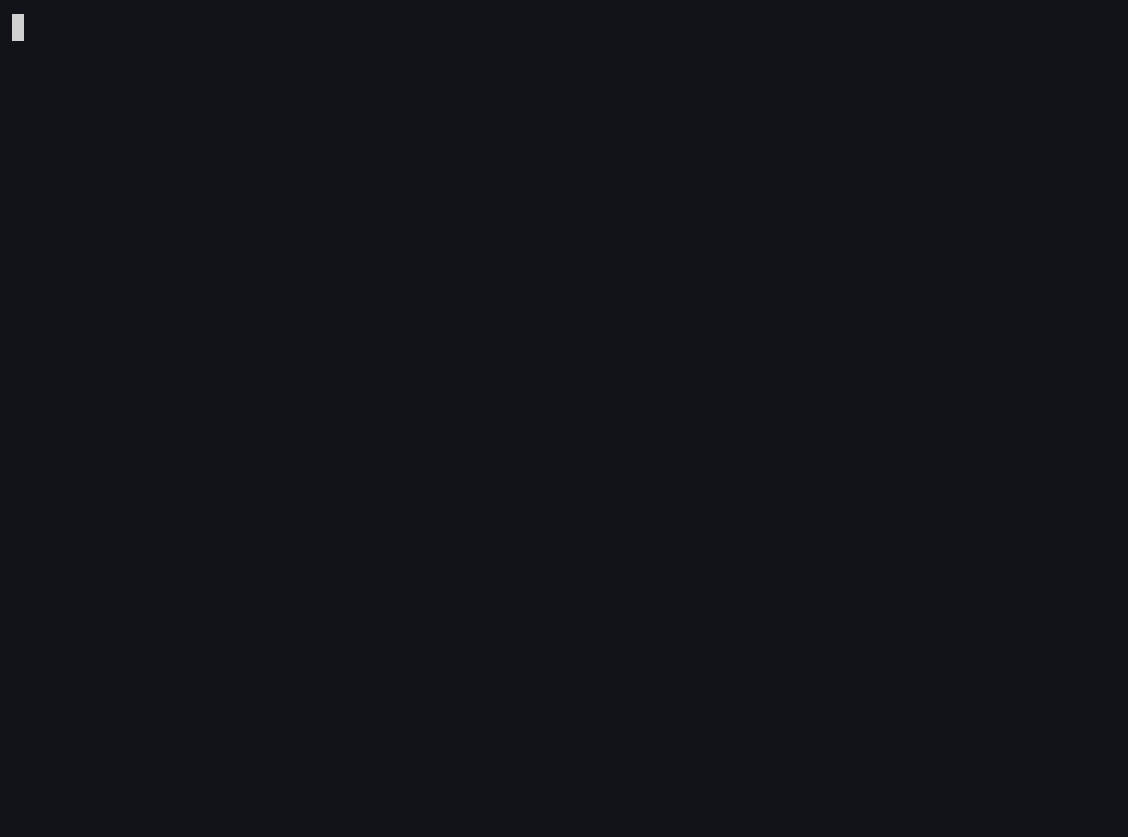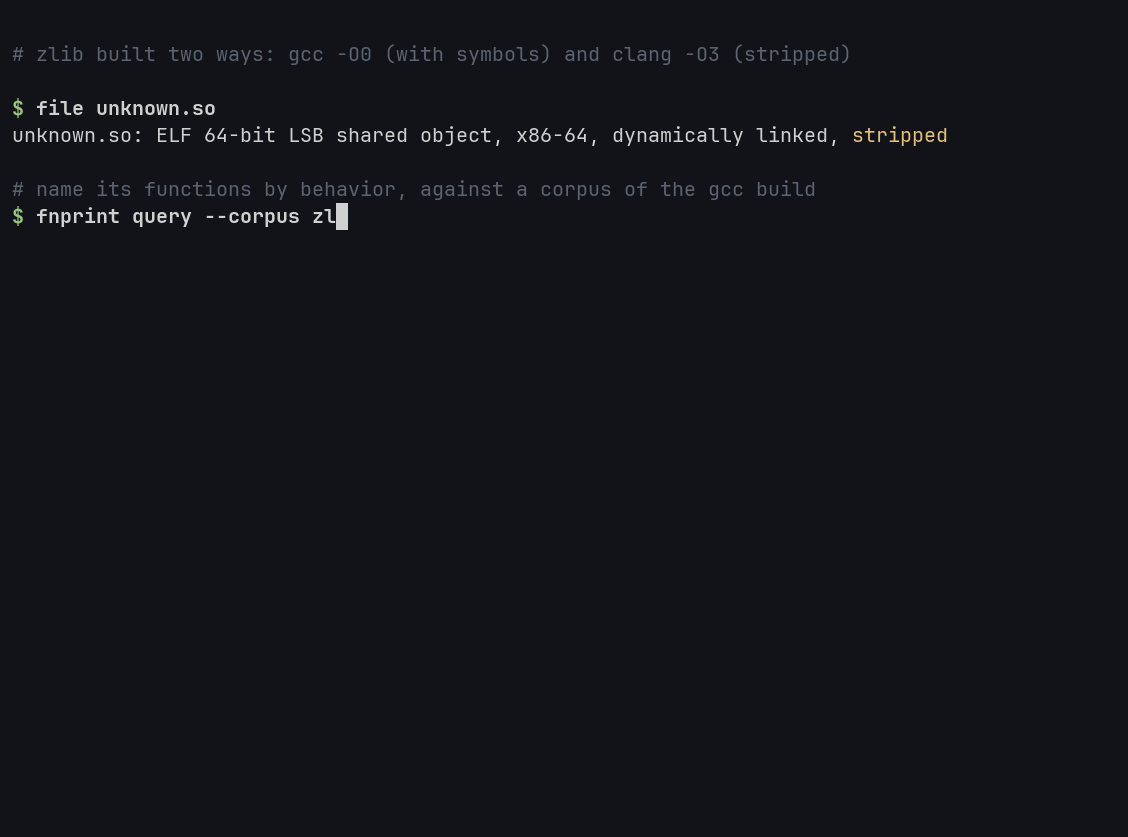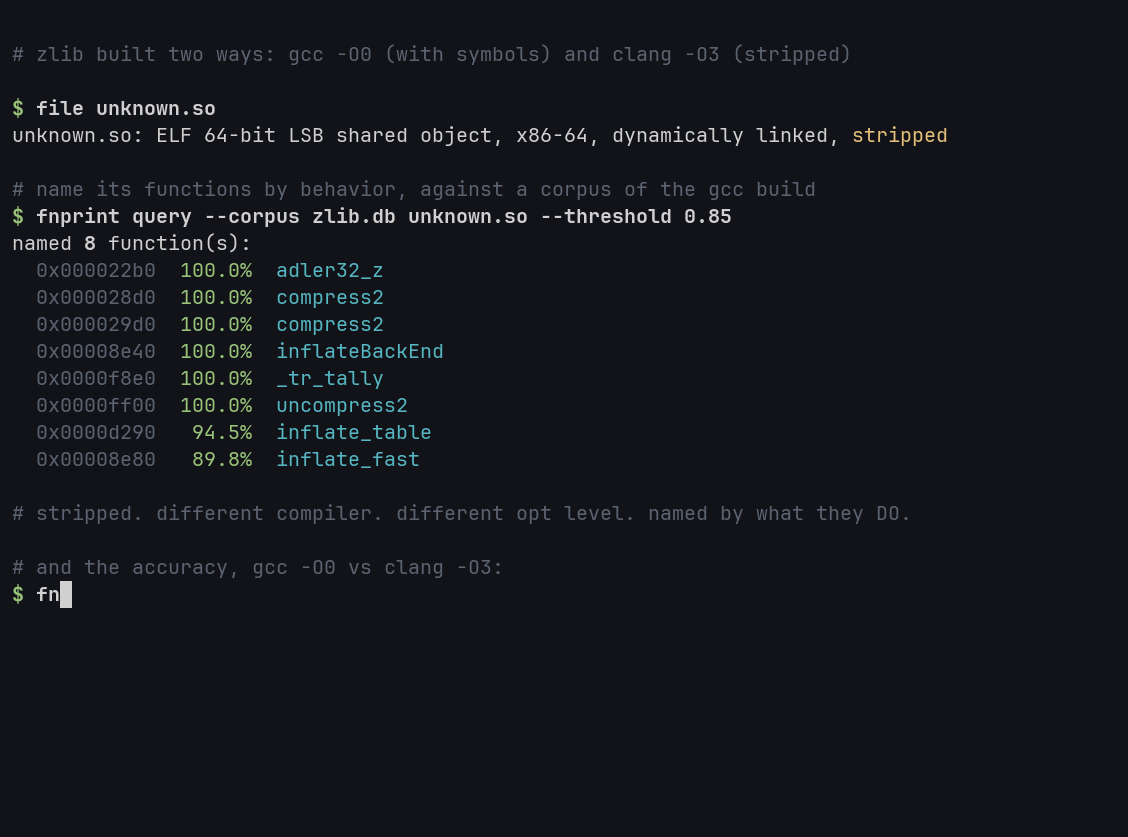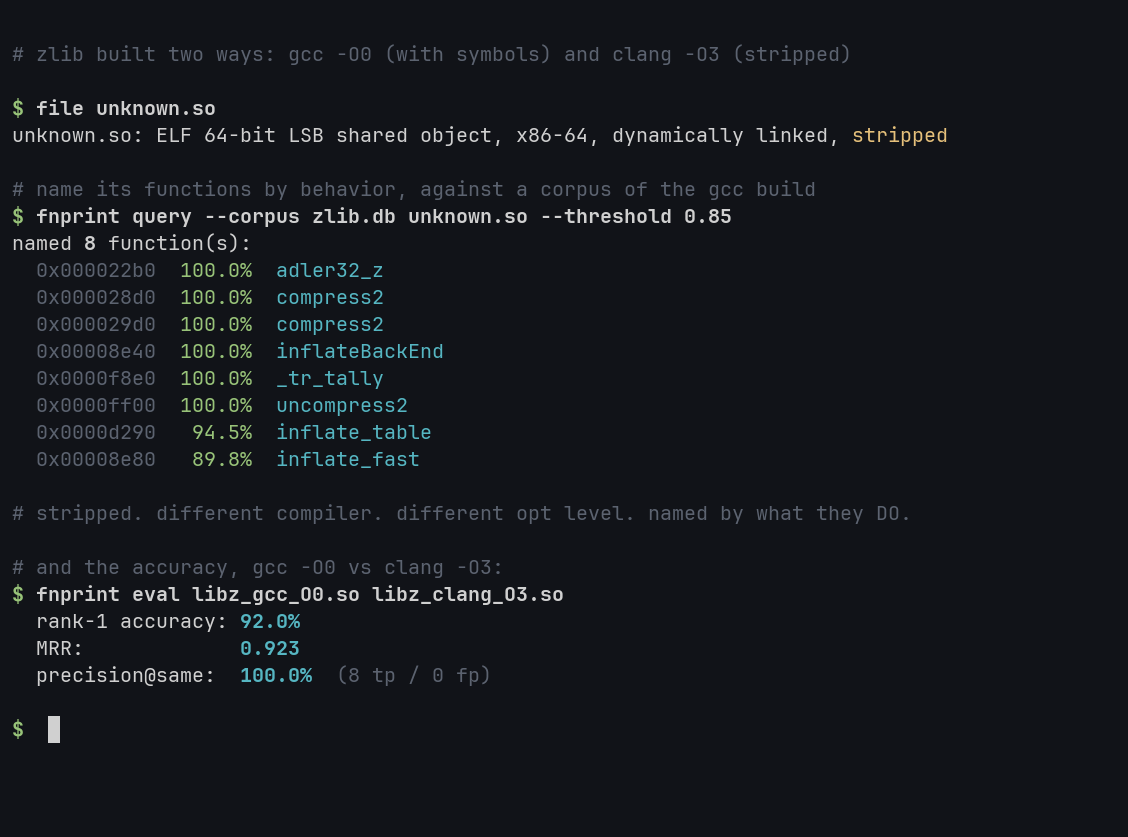
把它指向一个剥离符号的二进制文件和一个你已经知道名字的语料库:
$ strip --strip-all mystery.so
$ nm mystery.so
nm: mystery.so: no symbols

$ fnprint index libz.so -o corpus.db          # a build you have symbols for
$ fnprint query mystery.so --corpus corpus.db --threshold 0.6
named 27 function(s):
  addr        sim    graph  name
  0x000022f9  100.0%     0%  adler32_z  (libz.so)
  0x00002a8d  100.0%     0%  compress2  (libz.so)
  0x00004500  100.0%     0%  deflateStateCheck  (libz.so)
  0x0000ad5d  100.0%     0%  inflateBackEnd  (libz.so)
  0x0000b69c  100.0%     0%  inflateStateCheck  (libz.so)
  0x00012f8c  100.0%     0%  _tr_tally  (libz.so)
  ...
那次运行是一个完全剥离符号的 -O0 构建,从一个 -O2 语料库命名而来。不同的优化级别,零符号残留,27 个名字返回,且 27 个全部正确。它对有把握的进行命名,对其余的保持沉默。(上面的 gif 来自 0.5,它找到了 9 个;0.6 还能恢复被剥离的 .so 隐藏在导出符号背后的静态函数。)
跨 CPU 也是同样的事。语料库来自 x86-64 构建,目标是同一源码的 aarch64 构建,符号已消失:
$ fnprint index libz_x86_64.so -o corpus.db
$ fnprint query libz_arm64_stripped.so --corpus corpus.db
named 42 function(s):
  addr        sim    graph  name
  0x00001af4  100.0%     0%  adler32_z  (libz_x86_64.so)
  0x0000263c  100.0%     0%  compress2  (libz_x86_64.so)
  0x00002958  100.0%   100%  x2nmodp  (libz_x86_64.so)
  0x00002a98  100.0%     0%  crc32_z  (libz_x86_64.so)
  0x000034c4  100.0%   100%  crc32_combine64  (libz_x86_64.so)
  ...
42 个命名,42 个正确,来自一个为不同 CPU 构建的语料库。
它做的另一件事是 diff 两个构建并告诉你哪些函数改变了行为,这在厂商发布新固件而你想知道实际变动了什么时很方便。它有无符号名都能工作:有符号名时按名字对齐,没有符号名时按行为加调用图对齐两个构建,因此两个完全剥离符号的固件镜像仍然可以 diff:
$ fnprint match old.so new.so
aligned 38 function pairs by behavior + call graph (no symbol names needed)
  unchanged:  31
  changed:    7
  low-signal: 57 (too small to judge)

changed behavior (lowest similarity first):
   30.5%  compress_block
   43.0%  deflate_rle -> deflate_huff
   68.8%  deflate_slow
对于实际的 n-day 工作,有 triage。从一个函数的已知漏洞版本构建一个语料库,从已修补版本构建另一个,然后根据两者对一个未知构建进行排名。一个接近漏洞侧且与已修补侧明显分离的函数,才是你想放到人类面前的,而不仅仅是一个你必须去解读的单一匹配分数:
$ fnprint index vuln.so    -o vuln.db
$ fnprint index patched.so -o patched.db
$ fnprint triage mystery.so --vuln vuln.db --patched patched.db
43 functions triaged: 1 look vulnerable, 0 patched, 42 inconclusive

review queue (vuln-leaning, strongest first):
   addr         vuln%  patched%  margin  matches
   0x000022f9  100.0     27.3   +72.7  adler32_z vs crc32_z
在两个版本中完全相同的 42 个函数会故意返回 inconclusive,它们无法被归到任何一侧,也不应被标记。--margin 和 --min-sim 控制两侧必须分离到什么程度它才会下结论。
对每个函数:
strip 后幸存下来的部分。内部调用在打印中是匿名的,转而成为调用图边,来自对函数体的静态扫描。-O2 函数全部认领它的方法。无需训练数据,无需模型。同样的想法在文献中以 Blanket Execution(Egele 等人,USENIX Security 2014)出现;fnprint 是它的一个实用、持续维护的版本,带有一个你真正能用的 CLI。效果模型在构造上就是架构中立的,这就是为什么同一源码的 x86-64 和 aarch64 打印无需任何学习就能对齐。
需要 rust 工具链、cmake 和一个 C 工具链。unicorn(无 JIT 分支)和 capstone 由 cargo 从源码构建,无需 apt 安装任何东西。
cargo install --path cli
# or just
cargo build --release   # binary at target/release/fnprint
fnprint index <binary> [-o out.db]      fingerprint every function, optionally to a db
fnprint match <a> <b>                   diff two binaries (or .db files) by behavior
fnprint query <target> --corpus <db>    name unknown functions from a corpus
fnprint triage <t> --vuln <db> --patched <db>   rank a build against vuln vs patched corpora
fnprint eval <a> <b>                     accuracy metrics using symbol names as truth
fnprint dump <binary> <func>            print the recorded effect trace (debugging)
fnprint completions <shell>             print a shell completion script to stdout
match 和 query 接受 ELF 或你用 index 构建的 .db,因此你可以对一个语料库只做一次指纹并重复使用。index -o 是追加的,所以一个语料库可以容纳多个二进制文件。
match --align 对一个有符号的配对强制使用无名字对齐,以查看仅行为视图的说法。--graph-weight(全局,默认 1.0)设置在对齐时一致的调用图邻域对配对的提升程度;0 表示仅根据每个函数自身的行为评分。
match、query 和 triage 接受 --limit N 来限制人类可读表格打印多少行(0 = 全部)。json 和 r2 输出从不设限,因此脚本能拿到全部内容。
completions 为 bash、zsh、fish、powershell 或 elvish 写一个脚本,例如
fnprint completions bash > ~/.local/share/bash-completion/completions/fnprint。
将任何输出管道到提前停止读取的东西(| head)会安静地退出,因此表格可以安全地浏览而无需 --limit。
每个命令都接受一个全局 --format:
fnprint query mystery.so --corpus corpus.db --format json > names.json
fnprint query mystery.so --corpus corpus.db --format r2   > fnprint.r2
json 是供脚本(以及 contrib/ 中的 Ghidra 导入桩)使用的稳定 schema,r2 输出你在 rizin/radare2 中用 . fnprint.r2 运行的 afn 重命名命令。来自目标的符号名在进入两者之前都会被净化,因此精心构造的名字无法注入 r2 命令。schema 和设置见 docs/integrations.md。
索引默认是单进程的。FNPRINT_SHARDS=N fnprint index ... 将大型索引分散到 N 个受牢笼限制的 worker 上;无论 N 是多少,语料库都是字节相同的。它只对大型、函数丰富的二进制文件有帮助,所以除非你要求,否则它是关闭的。
每对两个数字。rank-1 是打印本身:对于构建 A 中的一个函数,按相似度对 B 中的每个函数排名,最高命中是否正确。aligned 是 query 和 match 实际做的:带调用图的 1:1 分配,伙伴正确的频率,以及它在“相同”阈值下所确认配对的精确率/召回率。zlib 1.3.1(84 个函数)和 lua 5.4.6(约 600 个有信号的函数),可用 bench/run.sh 复现:
| pair | rank-1 | aligned acc | aligned prec |
|---|---|---|---|
| gcc O0 -> O1 | 97.1% | 97.1% | 100.0% |
| gcc O0 -> O2 | 93.1% | 93.1% | 100.0% |
| gcc O0 -> O3 | 91.3% | 87.0% | 100.0% |
| gcc O2 -> O3 | 56.5% | 63.0% | 74.2% |
| gcc/clang O0 | 95.3% | 100.0% | 100.0% |
| gcc/clang O3 | 44.4% | 92.6% | 100.0% |
| lua gcc O0 -> O2 | 58.6% | 57.3% | 95.1% |
| lua gcc O2 -> O3 | 82.6% | 86.6% | 98.7% |
| zlib x86-64 -> aarch64, O0 | 97.7% | 97.7% | 100.0% |
| zlib x86-64 -> aarch64, O2 | 71.1% | 97.8% | 100.0% |
| lua x86-64 -> aarch64, O0 | 89.8% | 92.6% | 99.9% |
| lua x86-64 -> aarch64, O2 | 80.4% | 78.6% | 99.6% |
完整表格见 bench/NUMBERS.md。
诚实的解读:当至少一侧具有一些行为丰富度时,它落在 90 多。两侧在同一架构上都经过重度优化是仅靠打印的困难情况(gcc O2 对比 O3 在 rank-1 上就是抛硬币),而这正是 1:1 分配和调用图发挥作用的地方:gcc/clang O3 从 44% 提升到 93% aligned,精确率 100%。跨架构比跨优化更容易,指令集变了但行为没变。它对自己不确定的东西弃权(拒绝给出有把握的“相同”判断),这就是为什么精确率保持很高,而在相同阈值下召回率较低。



