#1

 madrylab/robustness
训练、评估和探索神经网络,内置对抗鲁棒性工具,包括PGD攻击、对抗训练以及适用于视觉研究的鲁棒预训练模型。
 ccob/threadlessinject
使用远程函数挂钩实现无线程进程注入。
 mgeeky/shellcodefluctuation
一种高级内存规避技术,在 RW/NoAccess 与 RX 之间波动切换 shellcode 的内存保护,并对其内容进行加密/解密。
 robustbench/robustbench
标准化的对抗鲁棒性基准测试,配有公开排行榜和可下载的模型库,用于评估机器学习模型在 Lp 攻击和常见扰动下的表现。
 jiep/offensive-ai-compilation
涵盖进攻性 AI(Offensive AI)的精选实用资源列表。
 datadog/stratus-red-team
:cloud: :zap: 针对云端的细粒度、可操作对手模拟
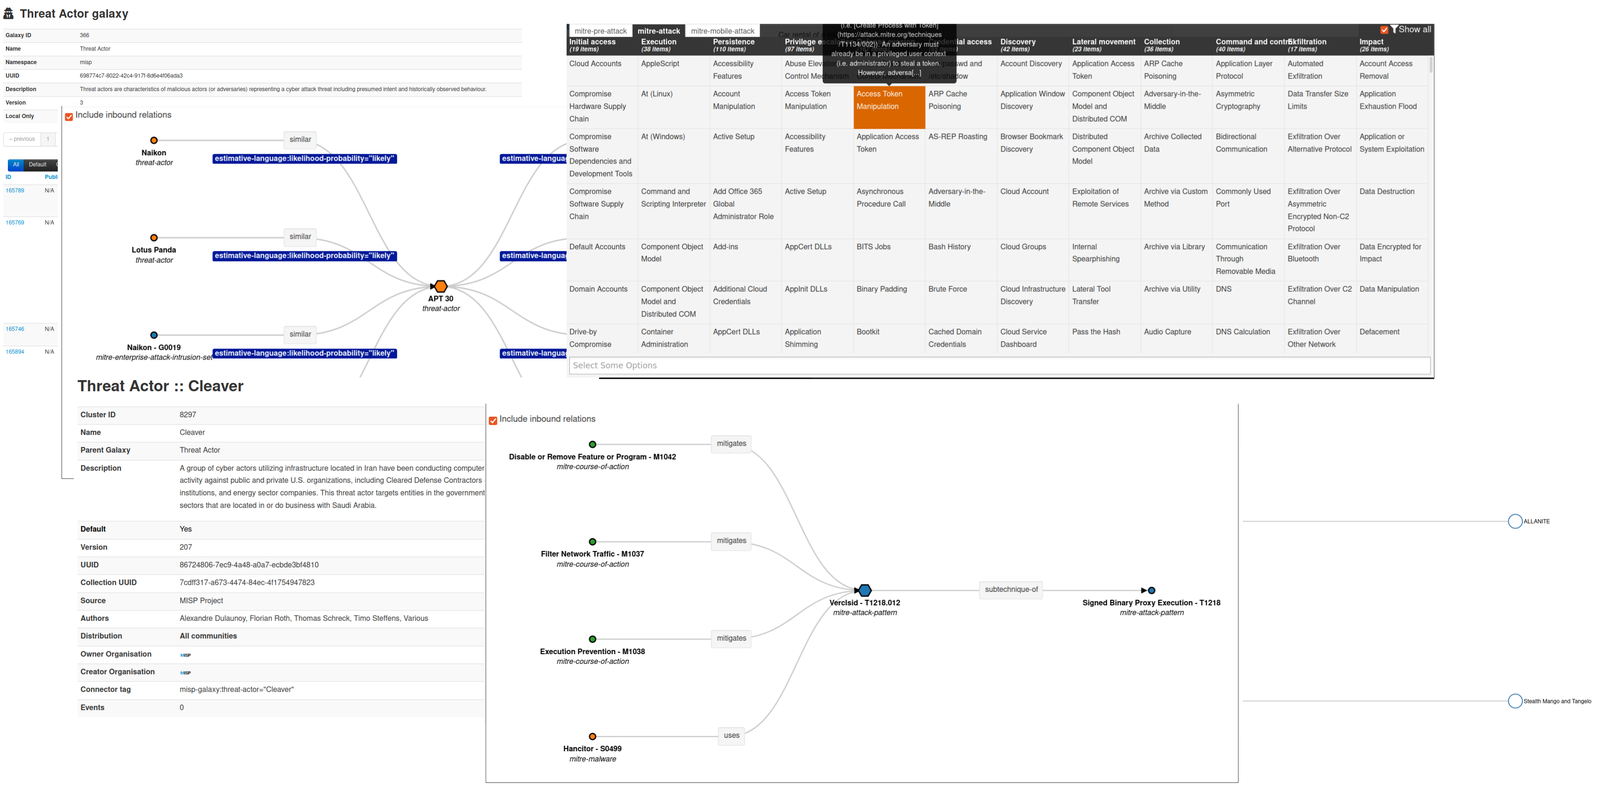 misp/misp-galaxy
用于附加到 MISP 事件或属性(如威胁行为者)的集群和元素
 microsoft/pyrit
用于对生成式AI系统进行红队测试的开源框架:自动化攻击提示、对模型响应进行评分,并审计行为以识别安全与安全性风险。
 promptfoo/modelaudit
用于 AI/ML 模型文件的安全扫描器。在部署前检测恶意代码、后门和漏洞。
 giskard-ai/giskard-oss
🐢 用于 LLM 智能体的开源评估与测试库
 whispergate/lldp
适用于 Mythic 的 C2 配置文件,通过 IEEE 802.1AB LLDP 组织特定 TLV 隧道封装加密的点对点代理流量,以实现隐蔽的二层命令与控制。
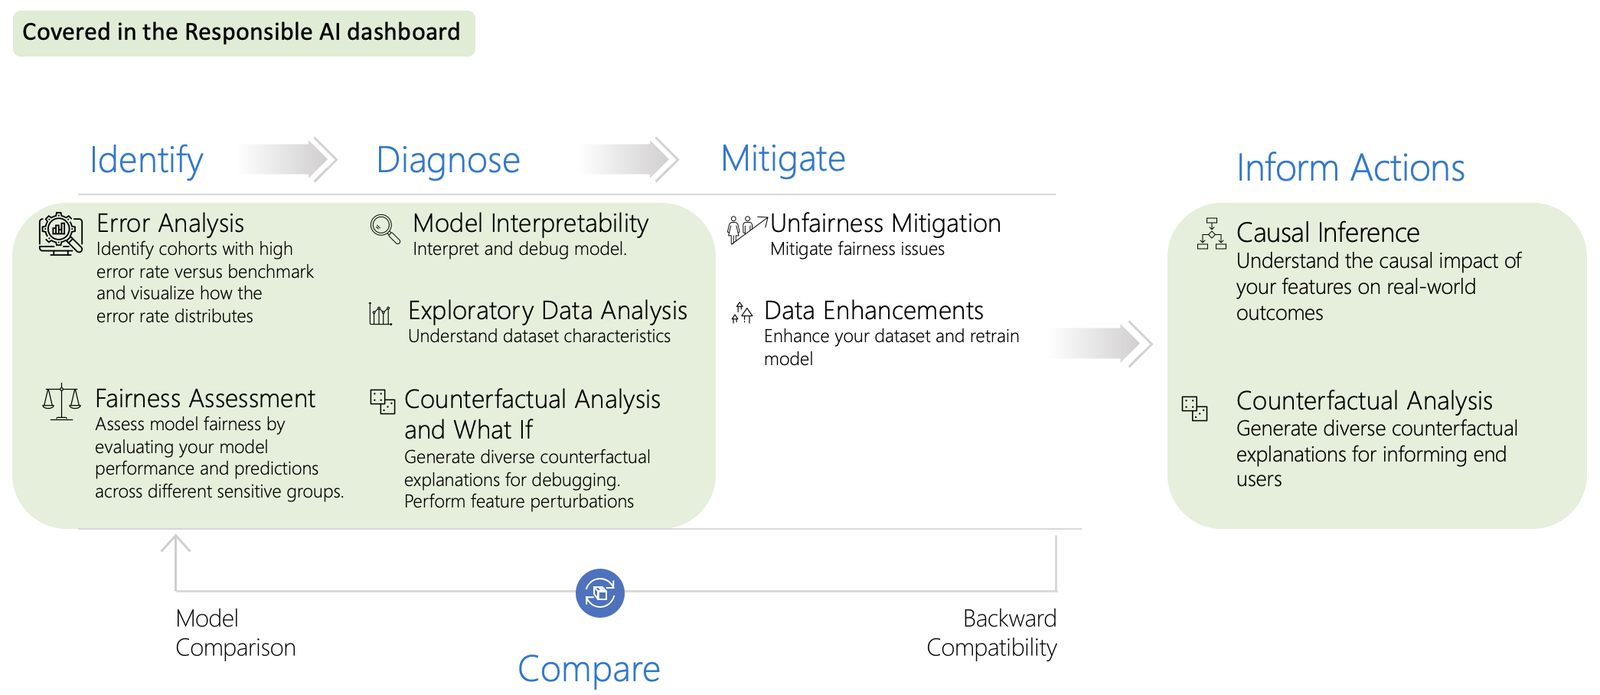 microsoft/responsible-ai-toolbox
用于负责任AI模型调试的交互式仪表盘和库,涵盖错误分析、公平性、可解释性、反事实分析、因果分析和数据平衡。
 meta-llama/purplellama
用于评估和改进LLM安全性的一组工具。
 yzhao062/pyod
一个用于跨表格、时间序列、图、文本、图像和音频数据进行异常检测的 Python 库。提供 60+ 检测器、基准测试支撑的 ADEngine 编排,以及面向 AI 代理的智能体工作流。
 trusted-ai/aif360
一套全面的数据集和机器学习模型公平性度量指标、这些指标的说明,以及用于缓解数据集和模型中偏差的算法。