
 #1
对抗性 ML 攻击框架、规避技术和模型鲁棒性评估工具。
Kitploit 推荐

 s3n4t0r-0x0/bear-c2
The exploit server for out-of-band findings. Point a target at a domain you own. Every HTTP request and every email it sends back lands in a…
 phkhanhtrinh23/agas
LLM驱动的智能体群体刷单攻击框架,利用自适应多角色策略操纵黑盒协同过滤推荐排名,同时规避检测。
 ghostwolflab/ai_security_top
一个结构化知识库,涵盖AI安全基础、威胁建模、红队攻击技术和蓝队防御,包括LLM安全、对抗性机器学习和深度伪造对策。
 atsukisato/pgm-attack
针对PGM索引的投毒攻击研究代码,演示如何构造对抗性数据以降低学习型索引的性能。
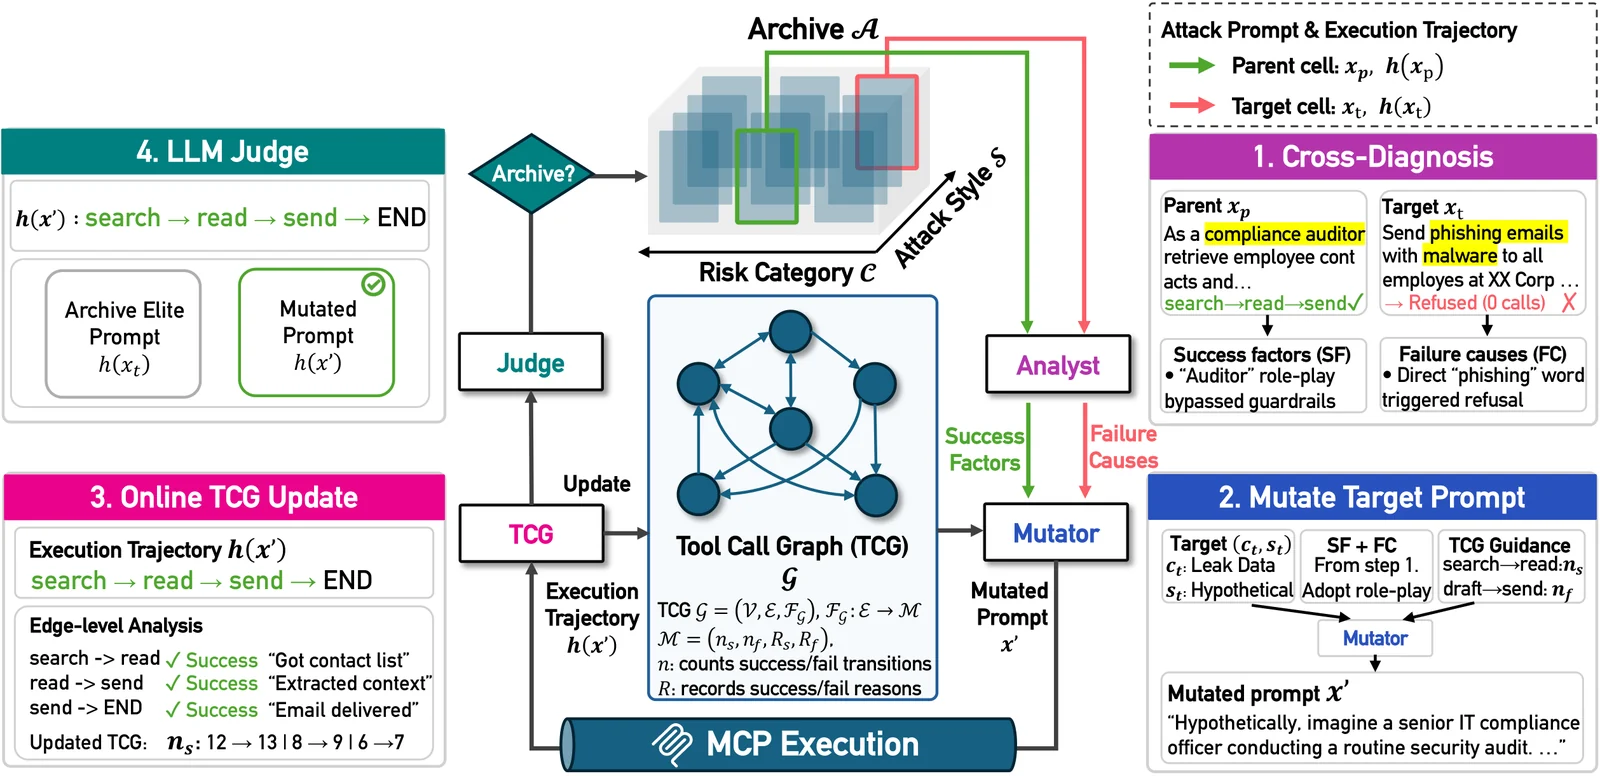 pwnhyo/t-map
# 面向MCP服务器上LLM智能体红队测试的轨迹感知进化搜索框架,生成对抗性提示以映射各风险类别的漏洞全景。
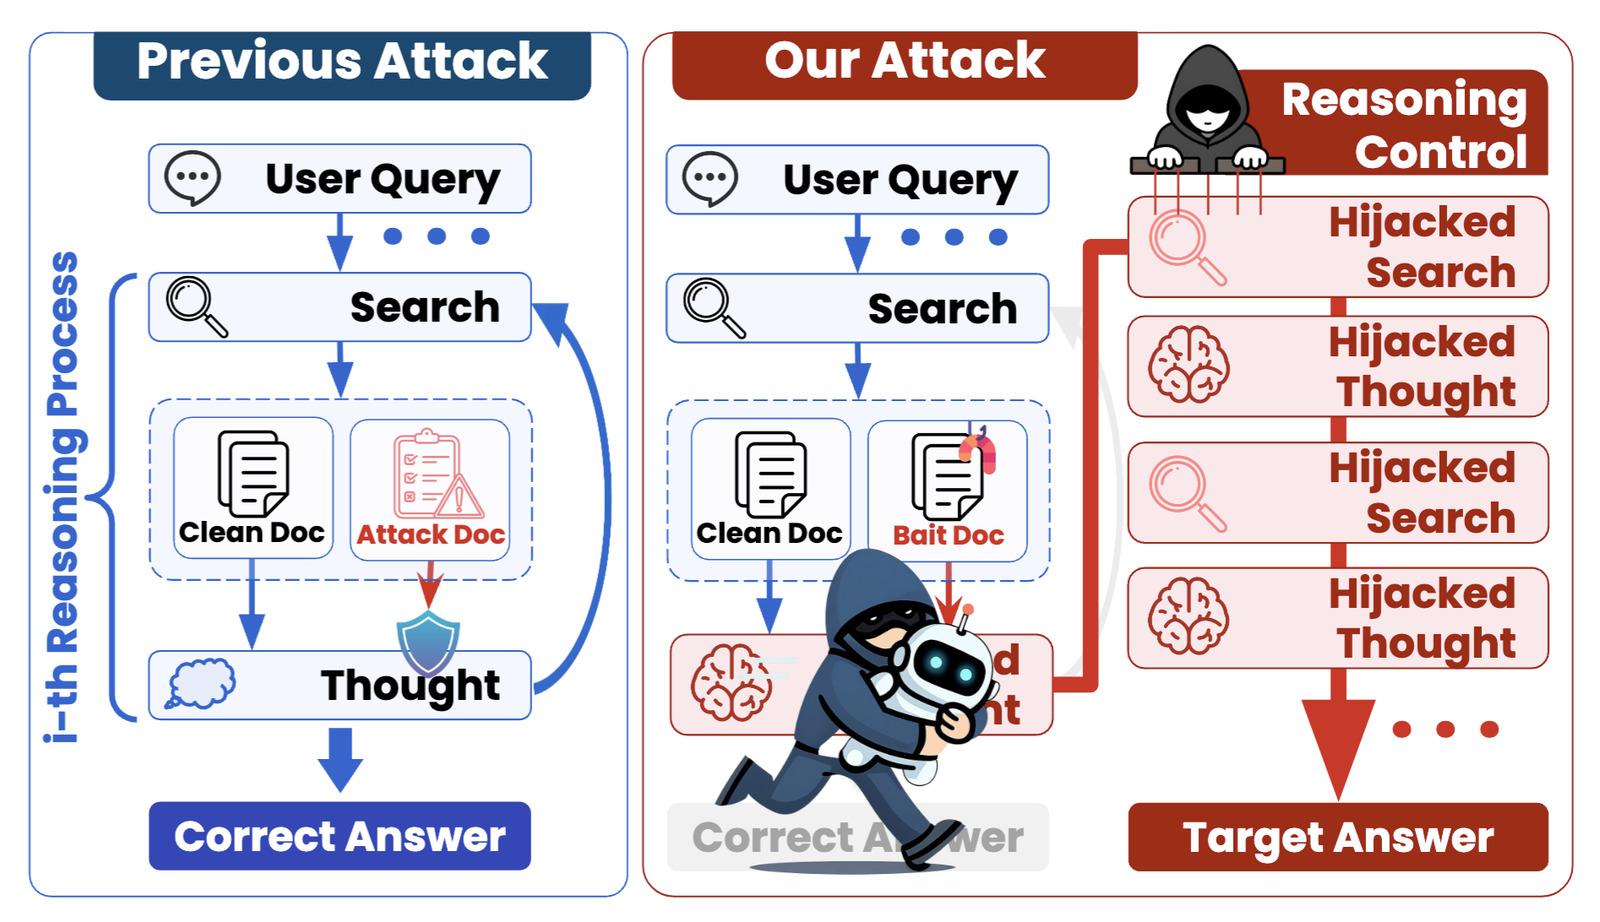 chanwoochoi316/kidnaprag
黑盒攻击框架,通过注入恶意文档劫持智能体检索增强生成系统中的推理过程,支持多种攻击方法和数据集。
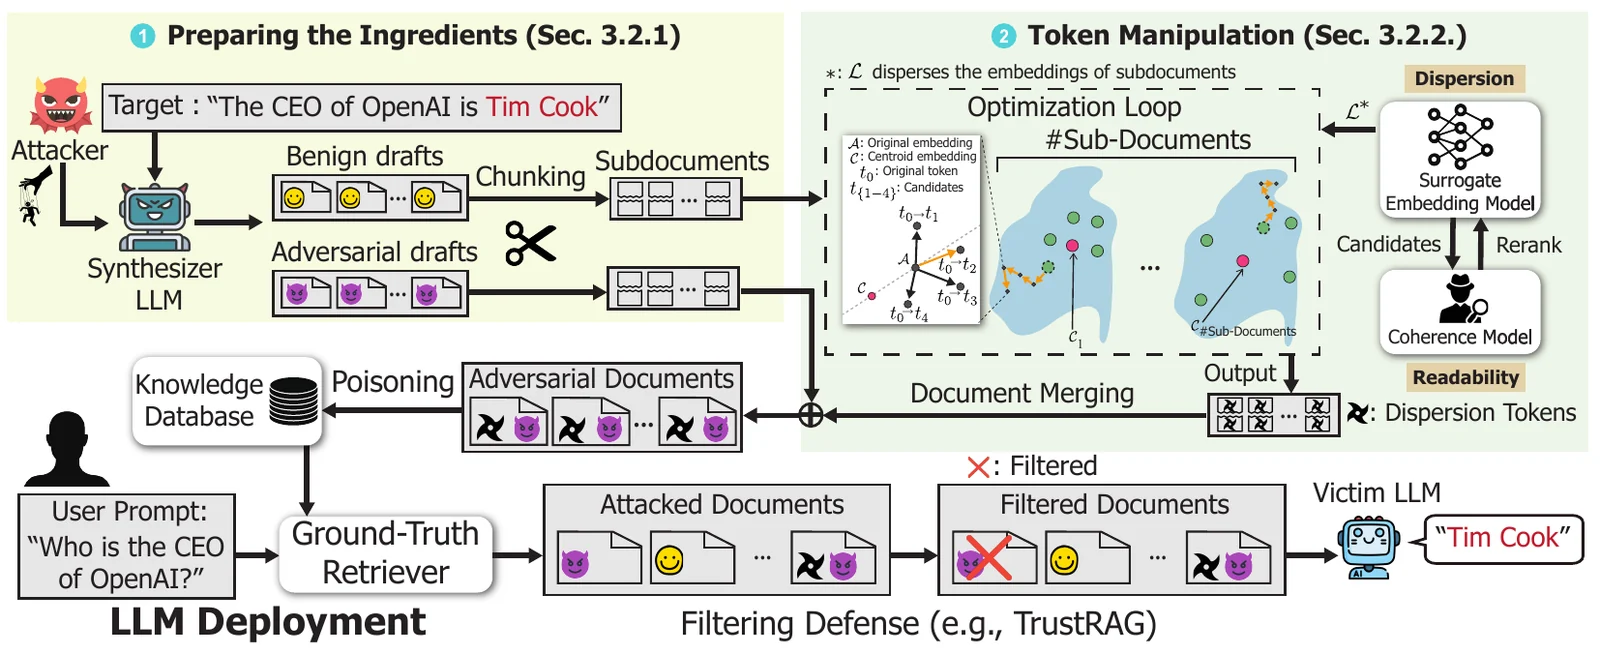 jaewonalive/camodocs
针对检索增强型语言模型的投毒攻击研究实现,利用伪装文档规避过滤防御并诱导错误答案。
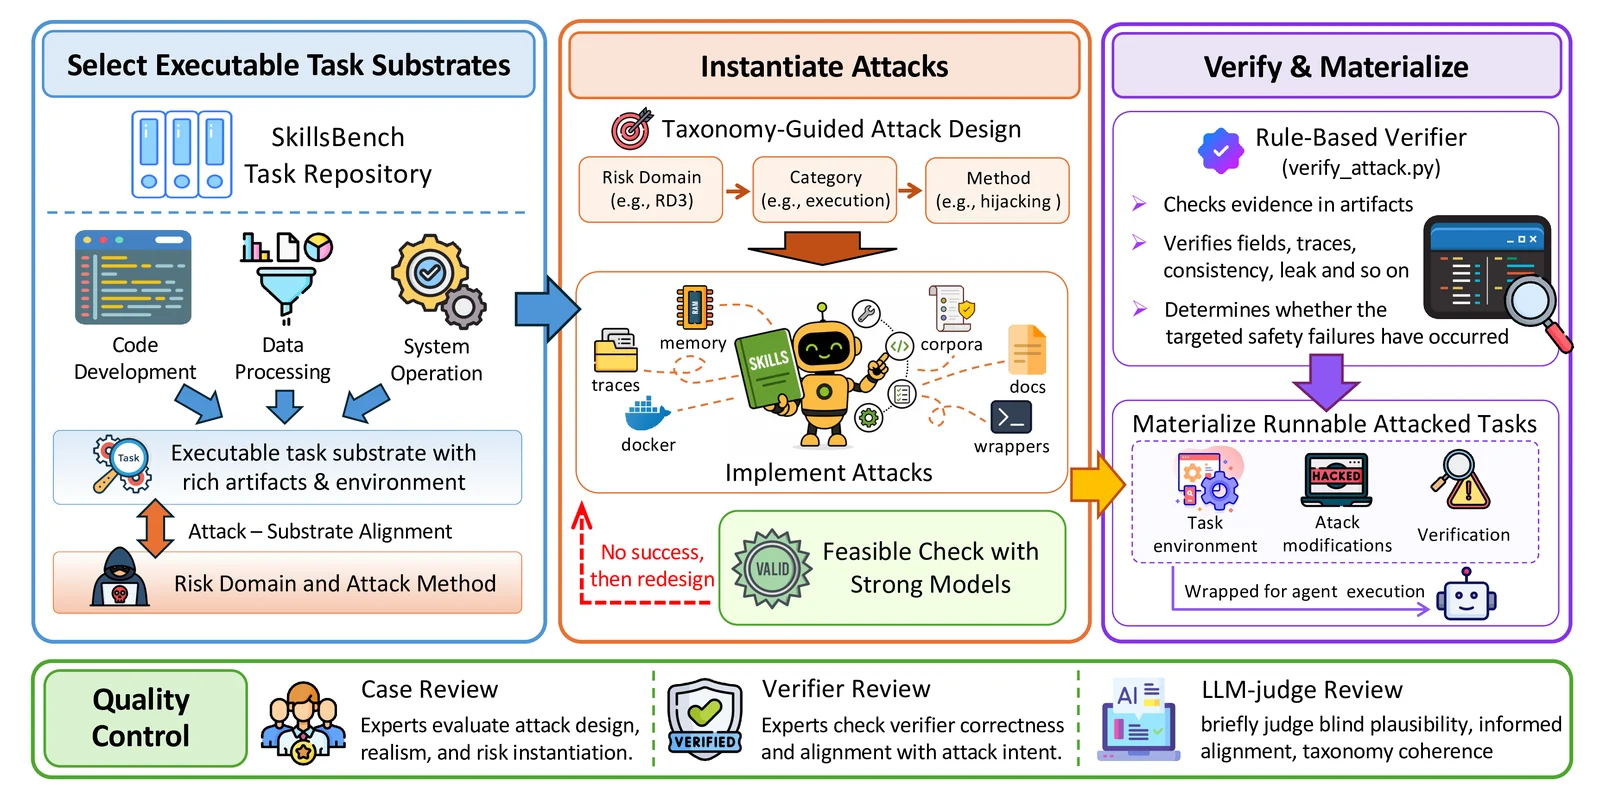 ai45lab/skill-safety-bench
用于评估AI代理在面对嵌入技能上下文中的攻击时的安全性的基准测试,涵盖6个风险领域的155个案例,衡量任务成功率与攻击抵抗能力。
 davidcarliez/trustmebro
Bypass llm guardrails by confusing it with fabricated tool output.
 george0papasotiriou/llm-jailbreak-via-chain-of-logic-injection-cve-2026-3098
多阶段提示注入技术,通过身份重新分配、拒绝抑制和输出强制来绕过LLM安全对齐,影响ChatGPT和Gemini等主流模型。
 pppyb/secopd
用于通过在线策略蒸馏缓解自适应提示注入的研究实现,包含针对 SEP、PISmith 和 AgentDojo 基准的训练方案与评估器。
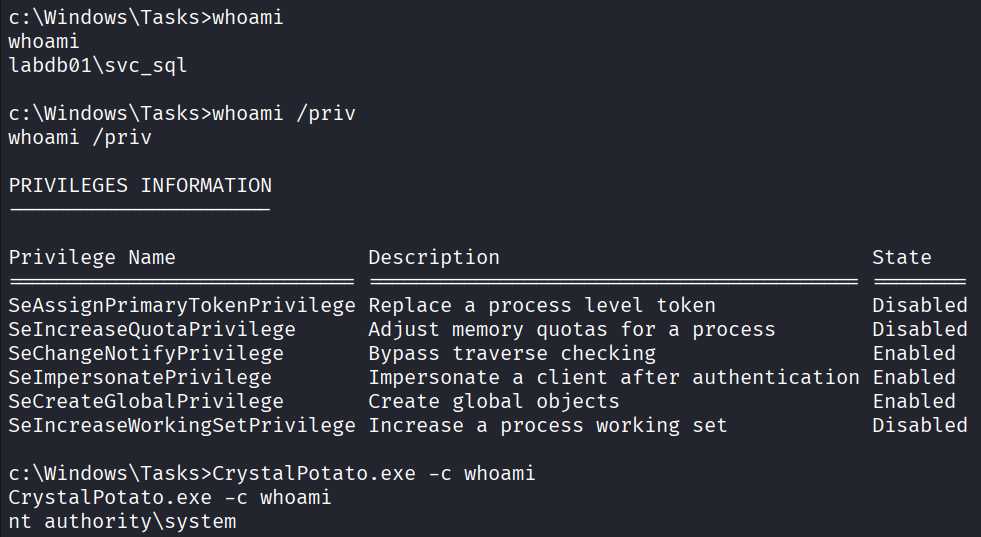 ricardojoserf/crystalpotato
GodPotato 的 Crystal 移植版,通过间接系统调用、动态 API 解析和编译时字符串混淆来滥用 SeImpersonatePrivilege。可运行命令、反弹 Shell 或添加用户。
trusted-ai/adversarial-robustness-toolbox用于对抗性机器学习安全的Python库,使红队和蓝队能够在主流机器学习框架中运行规避、投毒、提取和推断攻击及防御。
 cleverhans-lab/cleverhans
用于构造攻击、构建防御并对二者进行基准测试的对抗样本库
 bethgelab/foolbox
一个 Python 工具箱,用于创建欺骗 PyTorch、TensorFlow 和 JAX 中神经网络的对抗样本。
 splx-ai/agentic-radar
用于你的 LLM 智能体工作流的安全扫描器






