
 seclog-open/seclog
Coleta logs de segurança de múltiplas fontes a partir de cenários de ataque reproduzíveis em Docker, constrói cadeias de ataque e fornece o benchmark SecLog-Bench-216 para avaliar o raciocínio de LLMs sobre estágios de ataque.

O SecLog apoia a pesquisa sobre raciocínio de estágios de ataque a partir de logs de segurança de múltiplas fontes. Ele fornece ferramentas para coletar logs de cenários reproduzíveis de ataque e de atividade normal em Docker, organizar as evidências em cadeias de ataque, construir conjuntos de dados rotulados e avaliar as previsões dos modelos.
A versão inclui o SecLog-Bench-216, um benchmark pronto para uso com 216 janelas de evidências com rótulos de estágio revisados e cadeias de raciocínio de referência. Os pesquisadores podem usar o benchmark fornecido diretamente ou executar o pipeline de construção para produzir novos dados.
Artigo: SecLog-Bench: A Scalable Benchmark for Cybersecurity Log Reasoning with Scaffolded Evidence.
Recursos de construção no Zenodo: imagens Docker, logs brutos e índices de alinhamento e cadeias de ataque construídas.
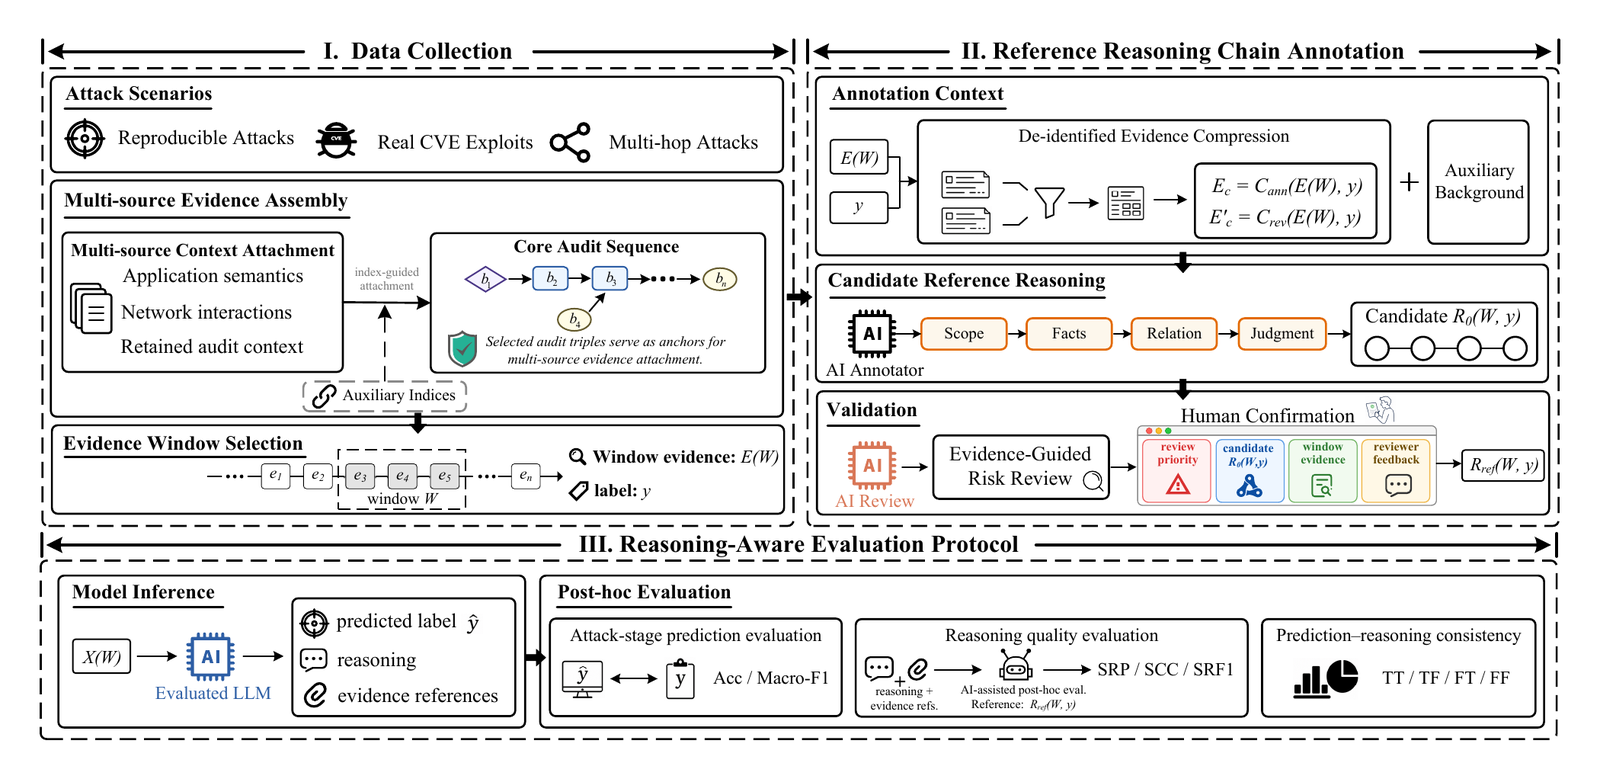
Figura 1. Visão geral do SecLog. A Parte I corresponde aos estágios 01–04, a Parte II ao fluxo de trabalho de anotação e revisão em 05, e a Parte III ao fluxo de trabalho de avaliação em 05 com o SecLog-Bench-216.
| Seu objetivo | Comece aqui | Ambiente |
|---|---|---|
| Ler ou reutilizar o conjunto de dados fornecido | SecLog-Bench-216 e exemplos de dados | Qualquer leitor de JSONL; Python 3.11 para o validador |
| Avaliar um modelo no benchmark fornecido | Início rápido | Python 3.11; um endpoint de API e uma chave para o executor de inferência incluído |
| Coletar novos logs e construir um conjunto de dados ou benchmark | Construção de dados | Ubuntu Linux, Python 3.11, Poetry, Docker e ferramentas de captura |
Os pacotes de sistema detalhados, os componentes opcionais e as versões das dependências estão listados em ENVIRONMENT_DEPENDENCIES.md.
Estes comandos usam Bash e são executados a partir da raiz do projeto. Comece com um ambiente Python 3.11 isolado:
python3.11 -m venv ../seclog-env
source ../seclog-env/bin/activate
Os comandos abaixo usam a biblioteca padrão do Python. Para coleta de logs, anotação, a interface de revisão e análises adicionais, consulte o guia de ambiente.
python 05_benchmark_annotation_review_evaluation/scripts/validate_public_benchmark.py
O validador verifica as contagens de amostras, os IDs, a distribuição de rótulos, as referências de evidências e os hashes do manifesto. Uma validação bem-sucedida reporta validation_passed: true e sample_count: 216 na sua saída JSON.
Substitua your-model-name pelo identificador de modelo suportado pelo seu provedor:
python 05_benchmark_annotation_review_evaluation/evaluation/run_benchmark_inference.py \
  --prompt-pack SecLog-Bench-216/data/prompt_pack.jsonl \
  --model your-model-name \
  --output ../seclog-runs/example/raw_responses.jsonl
Este comando reporta mode: preflight_no_api e a contagem de prompts. Ele
não contata o provedor nem cria um arquivo de resposta, e não
verifica se o provedor suporta o modelo selecionado.
Defina OPENAI_API_KEY no ambiente do seu shell, substituindo o placeholder
abaixo pela chave do seu provedor, e então habilite explicitamente as chamadas de API:
export OPENAI_API_KEY="YOUR_API_KEY"
python 05_benchmark_annotation_review_evaluation/evaluation/run_benchmark_inference.py \
  --prompt-pack SecLog-Bench-216/data/prompt_pack.jsonl \
  --model your-model-name \
  --output ../seclog-runs/example/raw_responses.jsonl \
  --call-api
O runner usa um endpoint de chat compatível com OpenAI. Sua URL base padrão é
https://api.openai.com/v1; passe --base-url para outro endpoint e
--api-key-env para outro nome de variável de chave. Mantenha o diretório de saída
fora da árvore de release, como neste exemplo. Use um novo caminho de saída para cada
execução, ou adicione --resume para continuar um arquivo de resposta existente.
Para usar seu próprio sistema de inferência, incluindo modelos que rejeitam temperature,
max_tokens ou modo JSON, use SecLog-Bench-216/data/prompt_pack.jsonl e o
formato de predição, depois passe
as saídas brutas para o normalizador abaixo.
python 05_benchmark_annotation_review_evaluation/evaluation/normalize_stage_reasoning_predictions.py \
  --input ../seclog-runs/example/raw_responses.jsonl \
  --output ../seclog-runs/example/predictions.jsonl

python 05_benchmark_annotation_review_evaluation/evaluation/evaluate_stage_reasoning_predictions.py \
  --gold SecLog-Bench-216/data/gold_labels.jsonl \
  --reference-chains SecLog-Bench-216/data/reference_reasoning_chains.jsonl \
  --model-input SecLog-Bench-216/data/evidence_windows.jsonl \
  --sample-index SecLog-Bench-216/data/sample_index.jsonl \
  --predictions ../seclog-runs/example/predictions.jsonl \
  --output-dir ../seclog-runs/example/evaluation
Os resultados incluem:
| Saída | Conteúdo |
|---|---|
predictions.jsonl | Previsões normalizadas do modelo |
invalid_outputs.jsonl | Respostas que não puderam ser normalizadas com sucesso |
evaluation/metrics_summary.json | Métricas de avaliação agregadas |
evaluation/per_sample_results.jsonl | Resultados por amostra |
evaluation/confusion_matrix.csv | Matriz de confusão de previsão de estágio |
evaluation/per_stage_metrics.csv | Métricas por estágio |
evaluation/error_cases.jsonl | Casos retidos para análise de erros |
A sobreposição entre referência e evidência neste avaliador é diagnóstica. A pontuação formal da qualidade do raciocínio requer o checklist adicional e o fluxo de revisão do assistente em Post-hoc reasoning quality.






