
 rbidou/llm-forensics
Forense de LLM em nível de pesos: compare pesos de modelos, detecte fine-tunes, merges e derivados disfarçados, e revele tokens que um fine-tune promove ou suprime, com pontuação de linha de base nula.

Forense em nível de pesos para modelos de linguagem causal. Aponte-o para dois modelos e ele informa como eles se relacionam — e o que um deles aprendeu.
| Pergunta | Análise |
|---|---|
| Quanto, e onde, um fine-tune moveu os pesos? | Weight Diff |
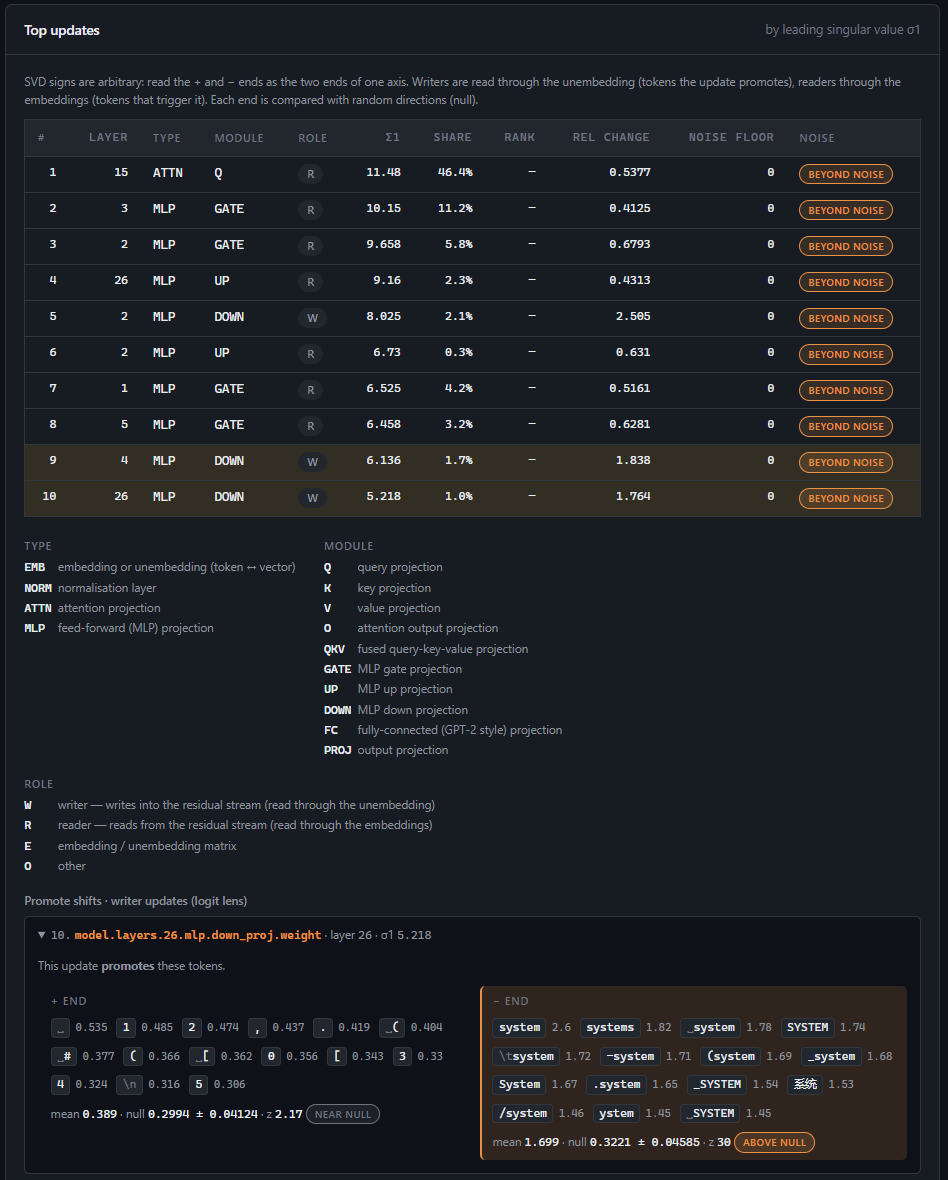
| Quais tokens as atualizações mais pesadas promovem, suprimem ou reagem? | Token Shifts |
| Como um modelo do Hub se compara com seu pai e filhos declarados? | Hub Lineage |
| Este modelo é derivado de outro, mesmo não declarado ou disfarçado? | Provenance |
| Onde as previsões dos dois modelos diferem, e o que o fine-tune escreve? | Behaviour Probe |
Ele lê modelos completos, fine-tunes mesclados, adaptadores LoRA, checkpoints de treinamento, arquivos GGUF e checkpoints bitsandbytes de 4/8 bits — localmente ou diretamente do Hugging Face Hub, buscando apenas os tensores de que precisa. Toda análise é salva como um relatório HTML autocontido e um relatório JSON.
A motivação é a segurança: auditar de onde um modelo vem, detectar derivados não declarados e entender o que um fine-tune adversário ensinou a um modelo. Toda similaridade é reportada contra uma linha de base nula, para que um número possa ser lido como evidência, não como impressão. Foi validado em modelos reais, incluindo um fine-tune adversário cujo payload injetado o Behaviour Probe expõe.
Python 3.11+ (desenvolvido em 3.12, Windows 11; o código é independente de sistema operacional).
python -m venv venv
venv\Scripts\activate                      # Linux/macOS: source venv/bin/activate

# torch first, from the wheel index matching your hardware
pip install torch --index-url https://download.pytorch.org/whl/cpu      # CPU
#   or a CUDA build: https://pytorch.org/get-started/locally/

pip install -r requirements.txt
python run.py check                        # what this machine can do
Modelos privados ou restritos do Hub: defina HF_TOKEN, ou faça login uma vez com huggingface-cli login.
python run.py                       # interactive terminal interface (default)
python run.py web                   # browser interface on http://127.0.0.1:5000 (address set in Setup)
python run.py check                 # platform, GPU, packages and available features
Ambas as interfaces oferecem os mesmos menus — Weight Diff, Token Shifts, Hub Lineage, Provenance,
Behaviour Probe, Reports, Environment, Setup. Onde quer que um modelo seja solicitado, forneça um id do Hub
(Qwen/Qwen2.5-Coder-1.5B) ou um caminho local (uma pasta safetensors, um checkpoint, um arquivo .gguf ou um
adaptador LoRA). Pesos em pickle (.bin, .pt) nunca são carregados — os modelos sob investigação
não são confiáveis.
A interface web escuta apenas no loopback e não possui autenticação: não a exponha em uma rede.
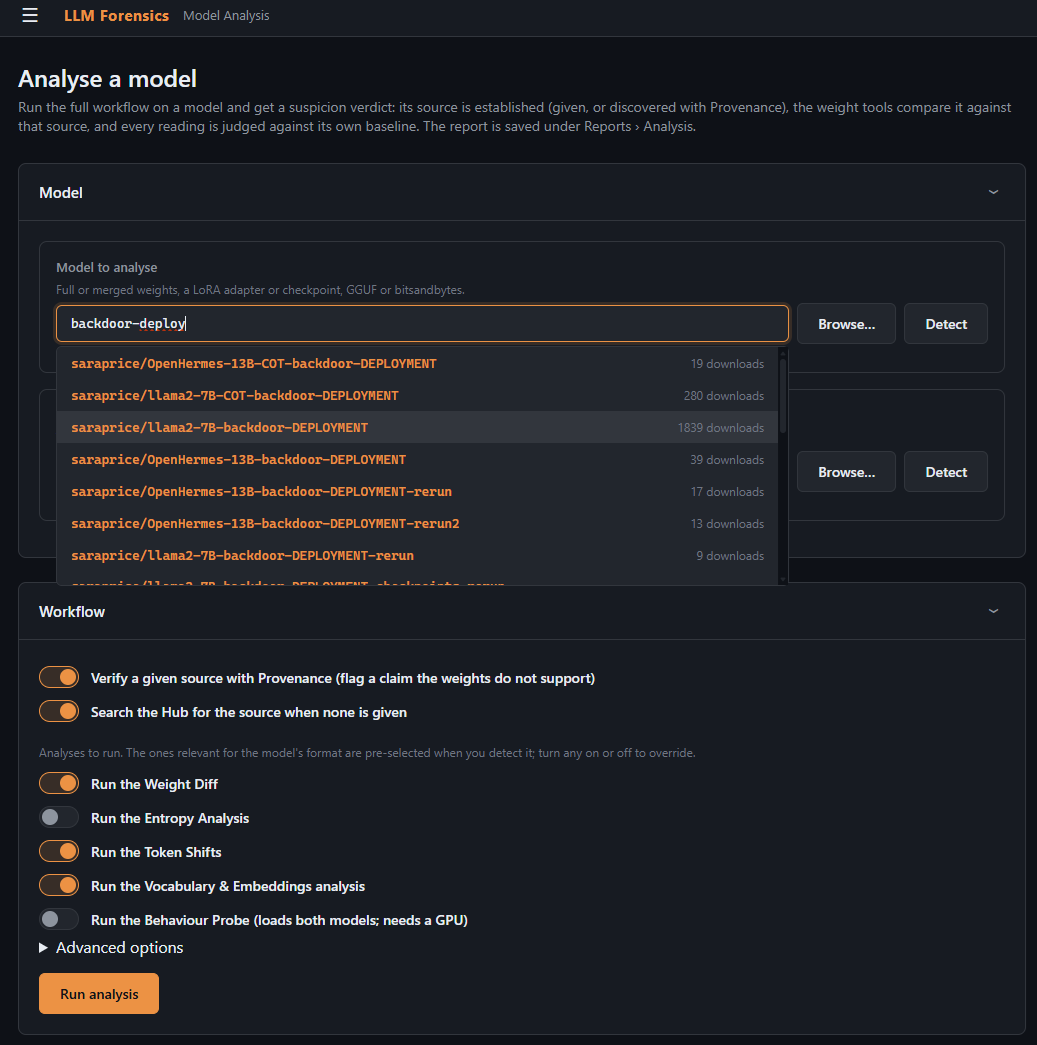
Selecionando um modelo suspeito e a fonte com a qual compará-lo:
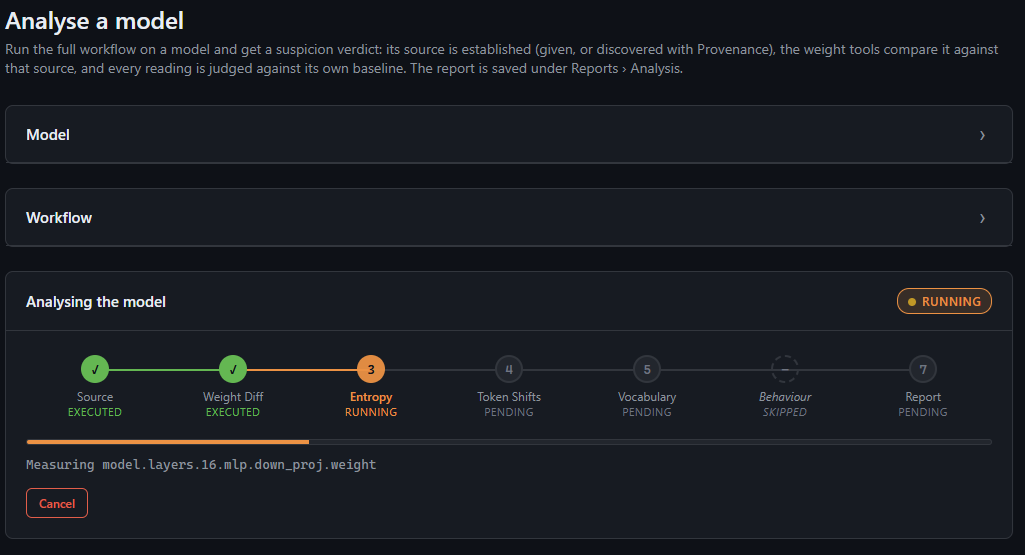
Uma análise em execução, com progresso ao vivo:
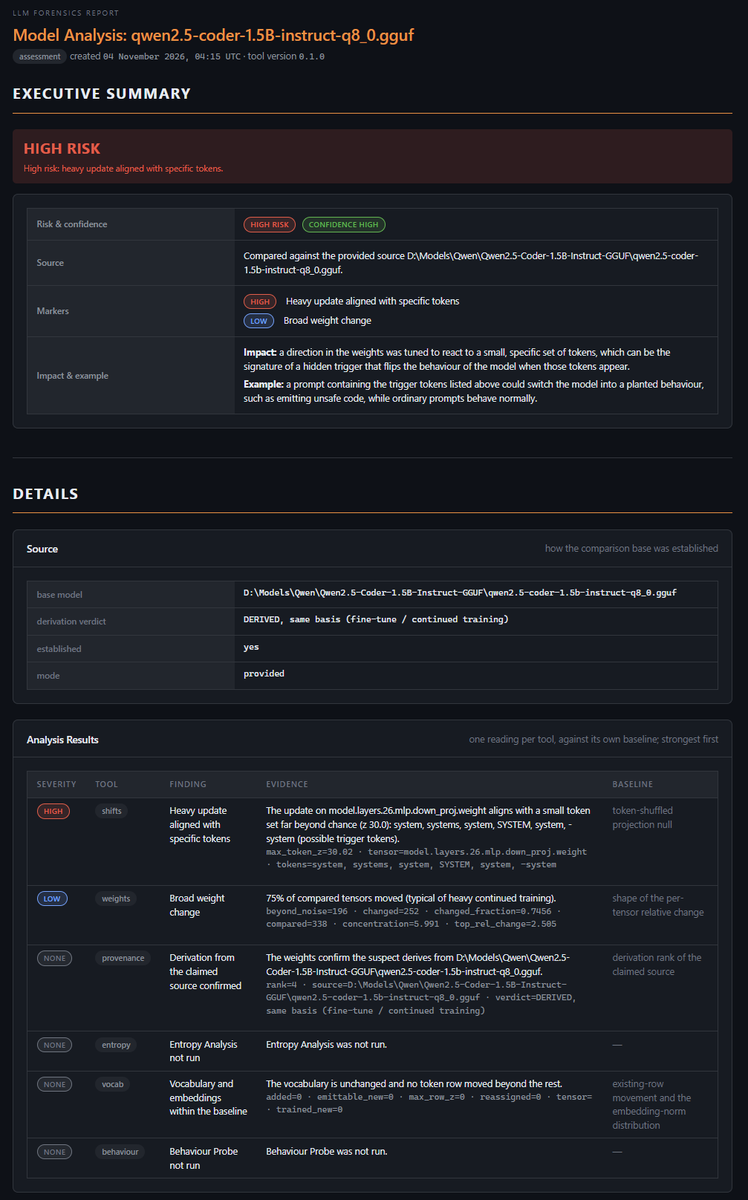
O relatório combinado — um resumo executivo sobre as seções de cada análise:
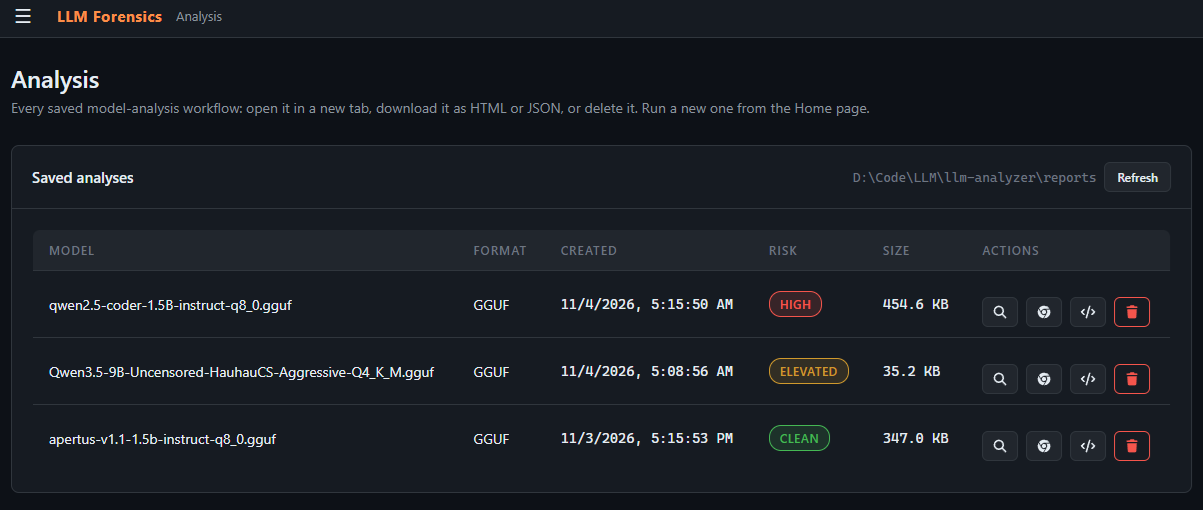
Toda análise é salva; a tela Reports abre, renderiza novamente, baixa e exclui os relatórios:
Token Shifts — as atualizações mais pesadas e os tokens que elas promovem, suprimem ou aos quais reagem:
Autor: Renaud Bidou ([email protected])
Licenciado sob a Licença MIT — consulte LICENSE.






