

 amd2g2zz/kunglao-agent
O agente especialista em engenharia reversa: planeja seu próprio caminho de análise, deriva cada fato a partir de evidências brutas e converge sob portões de verificação mecânica — firmware, protocolos, web/JS, controle de risco, binários.
Um agente autônomo de engenharia reversa que funciona durante horas sem supervisão, verifica cada conclusão de forma independente e converge apenas quando cada resposta sobrevive a um veredito de oráculo mecânico.


🧠 planeja sua própria rota · 🔬 cada afirmação verificada por máquina · ⚖️ verificação cega em tudo · 📈 o loop mede a si mesmo
🚀 Início Rápido · ✨ Tecnologia Central · 🧠 kunglao × Claude Code · 🎛️ Como o RL Funciona · 🖥️ Demonstração · 📖 Estudos de Caso · 🧪 Avaliação · 🏗️ Arquitetura · 🗓️ Roadmap
English · 简体中文
[!WARNING] v0.1.6 é a última linha de lançamento nativa do Claude Code. O próximo marco (v0.2) migra o runtime integralmente para a base do PI Agent — mesmo loop, mesmos ledgers, novo substrato de engine. Consulte o roadmap.
Você aponta o kunglao-agent para um alvo e declara as perguntas; ele planeja a rota, despacha workers especialistas, verifica cada conclusão de forma independente e só para quando cada resposta é resolvida por uma verificação mecânica em vez da palavra de um modelo.
O espectro de alvos é completo — binários nativos Windows/Linux, APKs Android
(incluindo camadas nativas .so), web/JS, recuperação de protocolo, firmware —
static-first por design, acionando qualquer canal de execução que seu ambiente
já possua (VMware, ssh, docker, adb, ou nenhum para trabalho apenas estático).
Ele roda dentro do Claude Code como um plugin: o Claude Code é a superfície de conversação; o produto é o loop e a base de fatos que ele produz.
[!NOTE] Cada número que o loop reporta — taxas de vitória, posteriores, orçamentos — remonta a uma linha em um ledger somente-anexação. Nada é autodeclarado.
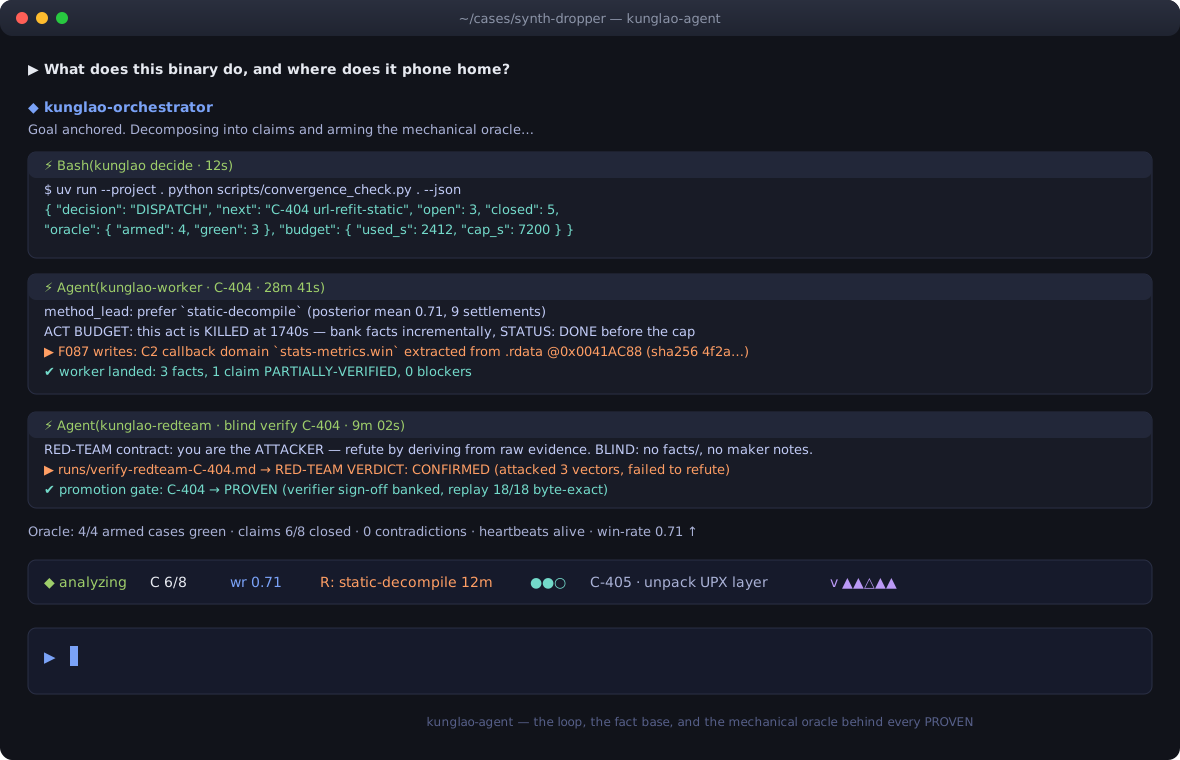
O orquestrador em ação — uma decisão de convergência, um despacho de worker
com orçamento com fatos chegando ao vivo, e um veredito cego de red-team promovendo uma
afirmação para PROVEN; o HUD da statusline mantém todo o engajamento legível em
um relance:
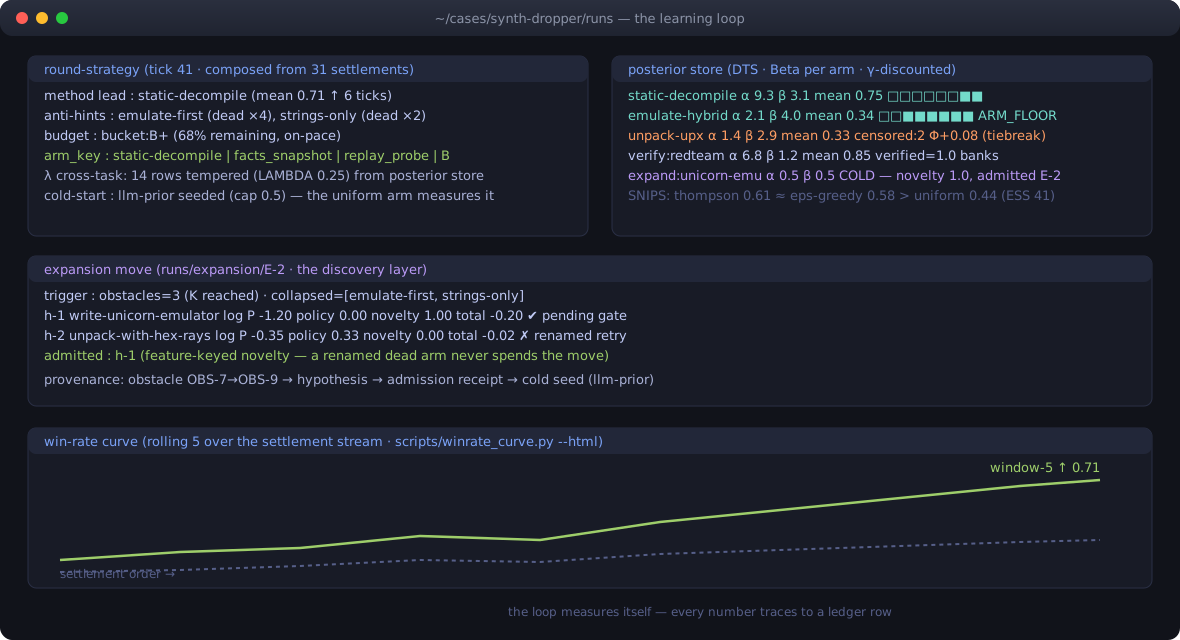
O loop medindo a si mesmo — a estratégia de rodada composta a partir de settlements, o armazenamento posterior de Thompson descontado com desempate de resultados censurados, a camada de descoberta admitindo um braço genuinamente novo (e recusando uma tentativa renomeada), e a curva de taxa de vitória:
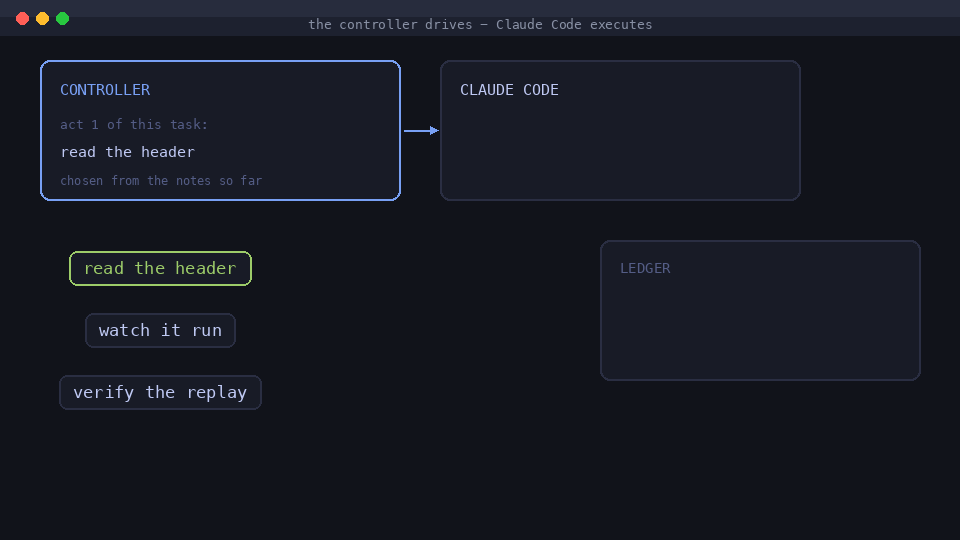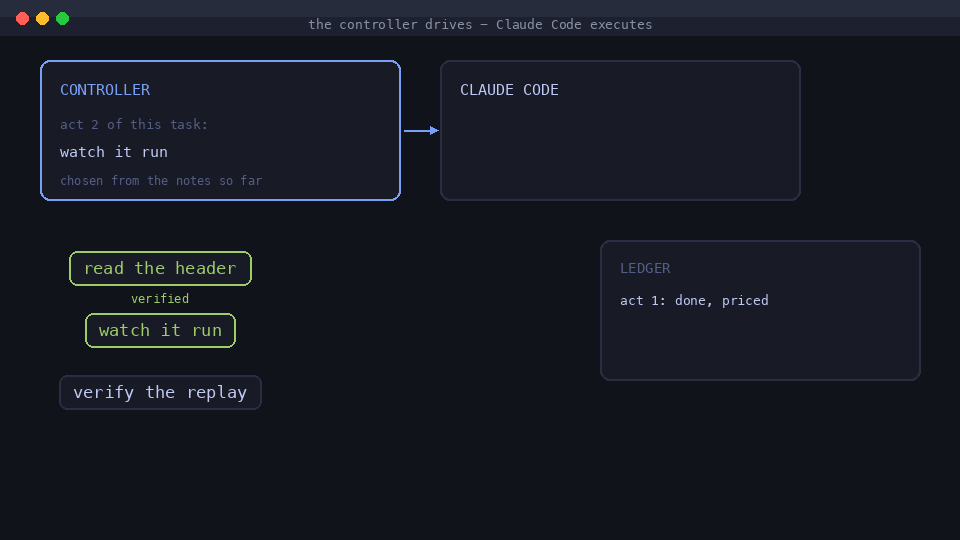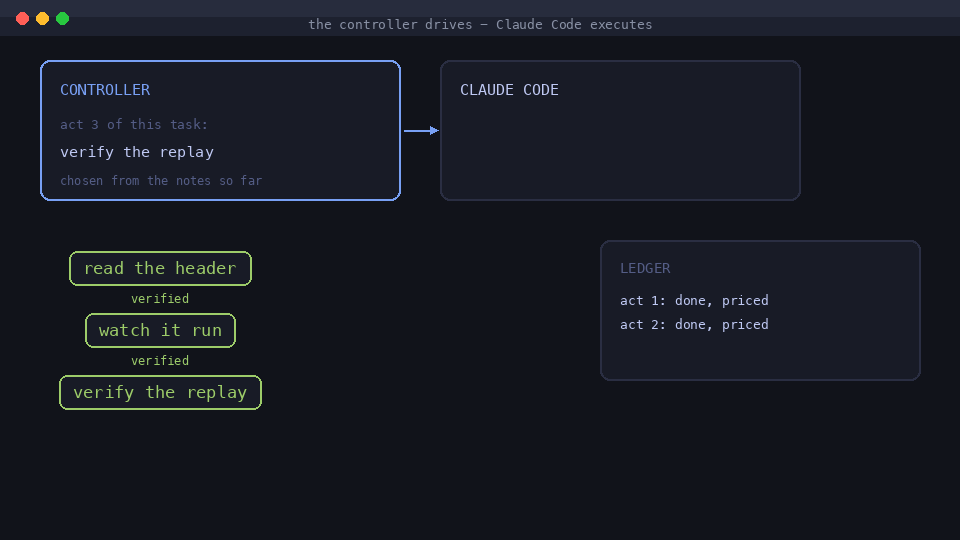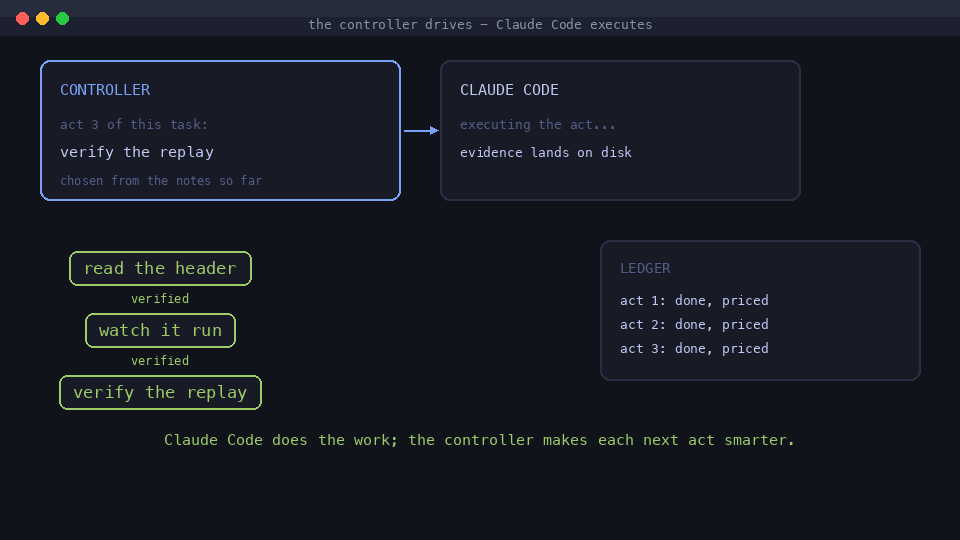
kunglao-agent é um controlador de RL em nível de ato em torno do Claude Code: o Claude
Code raciocina dentro de cada ato; o kunglao decide o próximo ato, verifica-o,
precifica-o, aprende com ele. Design aprofundado: docs/design/.
STAMP, nunca PROVEN. Fatos citam artefatos (sha256) e carregam
comandos reproduce:.O Claude Code é o motor; o kunglao é a caixa de câmbio, o painel e o computador de voo — próximo ato, verificação, orçamento e para onde vai a experiência.
| Claude Code puro | + kunglao | |
|---|---|---|
| Próximo passo | improvisado na sessão | política em nível de ato aprendida, posteriores persistem entre tarefas |
| Verificação | autorrelato | oráculo mecânico + red-team cego |
| Duração | uma sessão, humano observando | horas sem supervisão, retoma do disco |
| Experiência | evapora ao fim da sessão | ledger → posteriores → aposta de abertura mais afiada |
Fronteira honesta: para uma tarefa simples de sessão única, o Claude Code puro vence — a tabela de avaliação diz isso. O kunglao compensa em horizontes longos, disciplina de verificação e composição entre tarefas.
A primeira tarefa de um novo tipo paga o preço total: o loop tenta um método, observa-o falhar, tenta outro. Mas cada tentativa é registrada — e a próxima tarefa do mesmo tipo abre a partir dessas notas, não do zero.
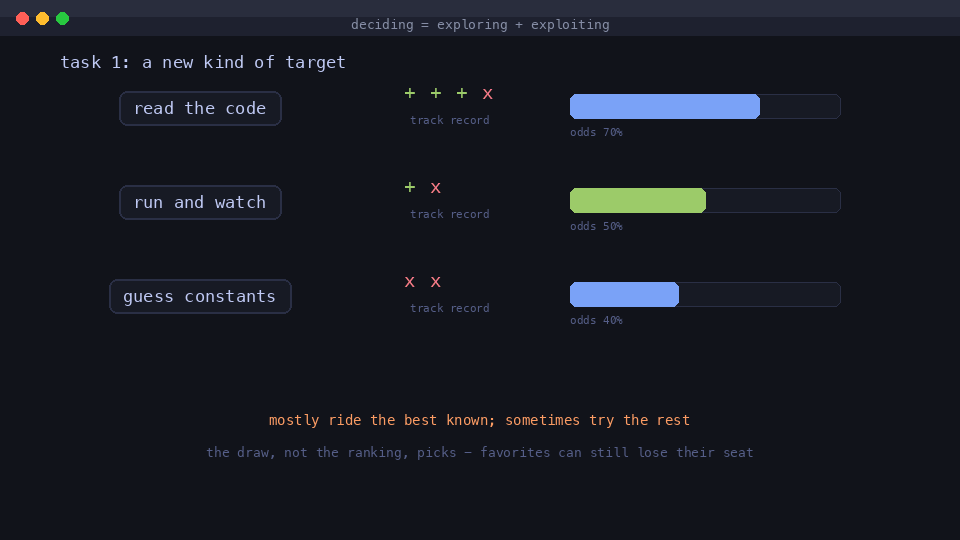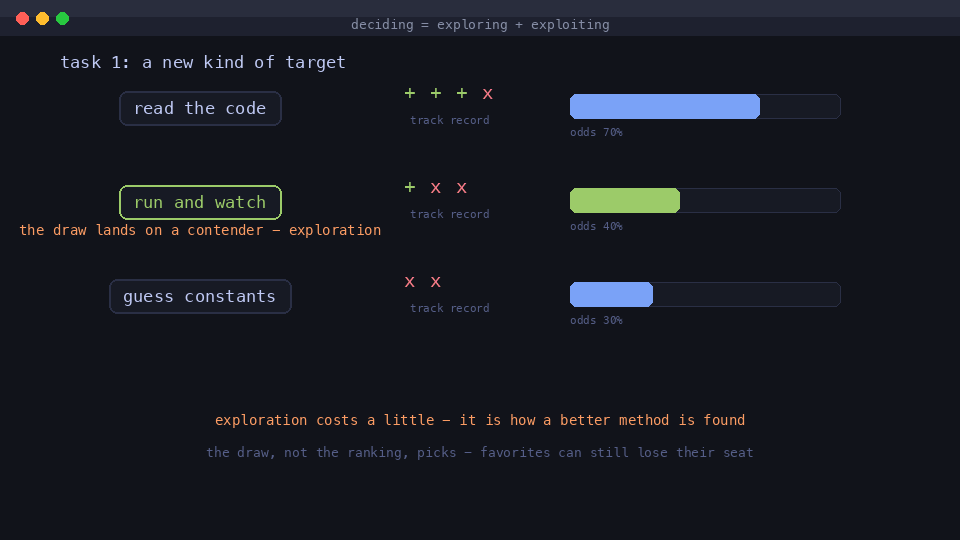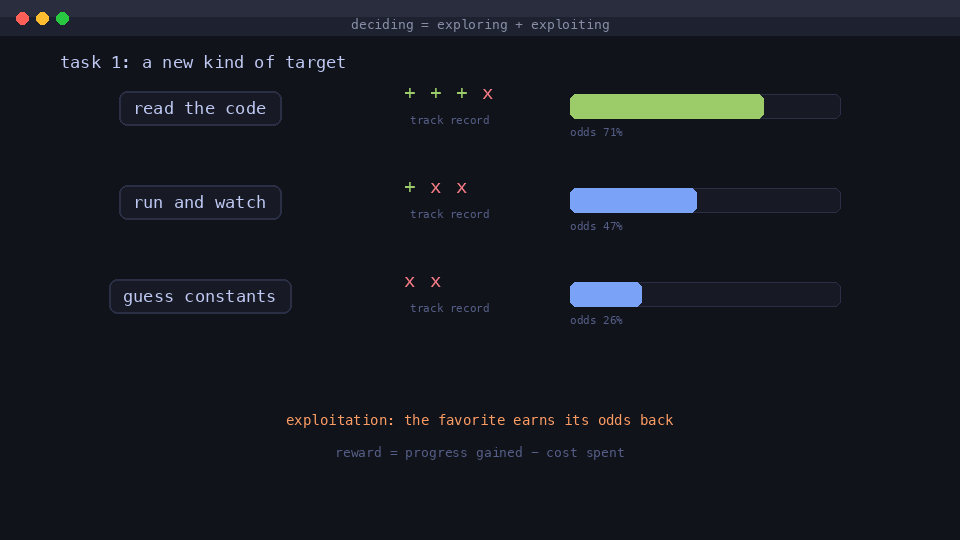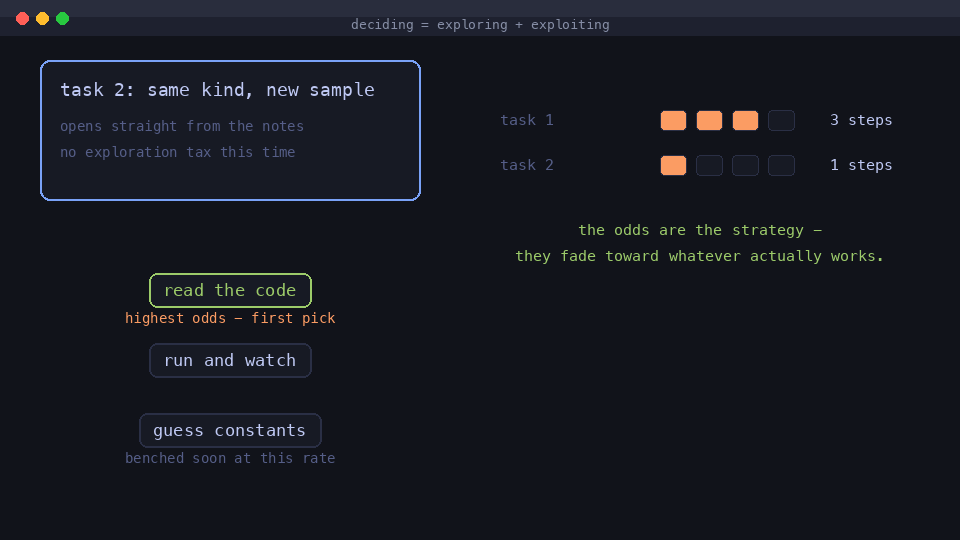
Essa é toda a ideia do aprendizado por reforço online aqui: o loop se atualiza entre atos, no trabalho — sem conjunto de dados de treinamento, sem retreinamento de modelo, sem fase offline. A experiência de cada tarefa é acumulada antes da próxima decisão ser tomada.
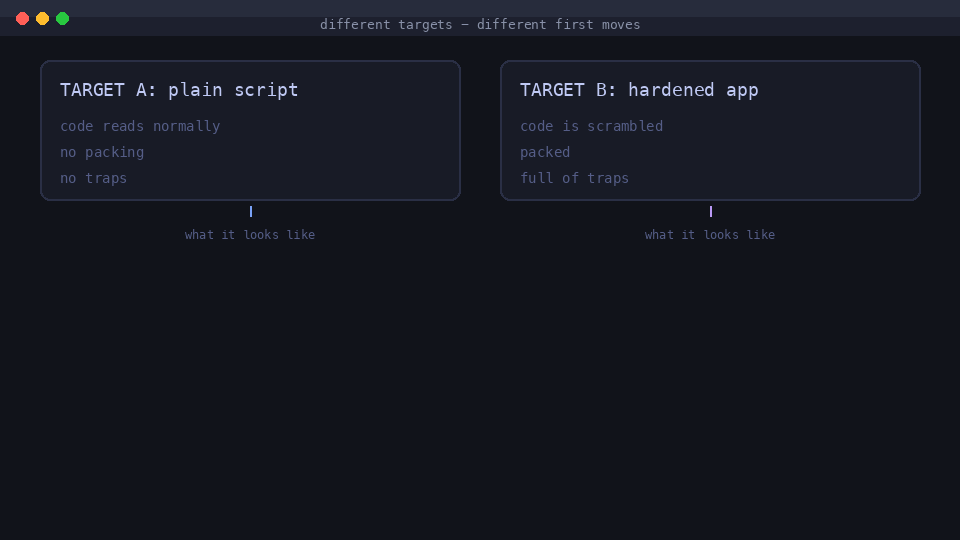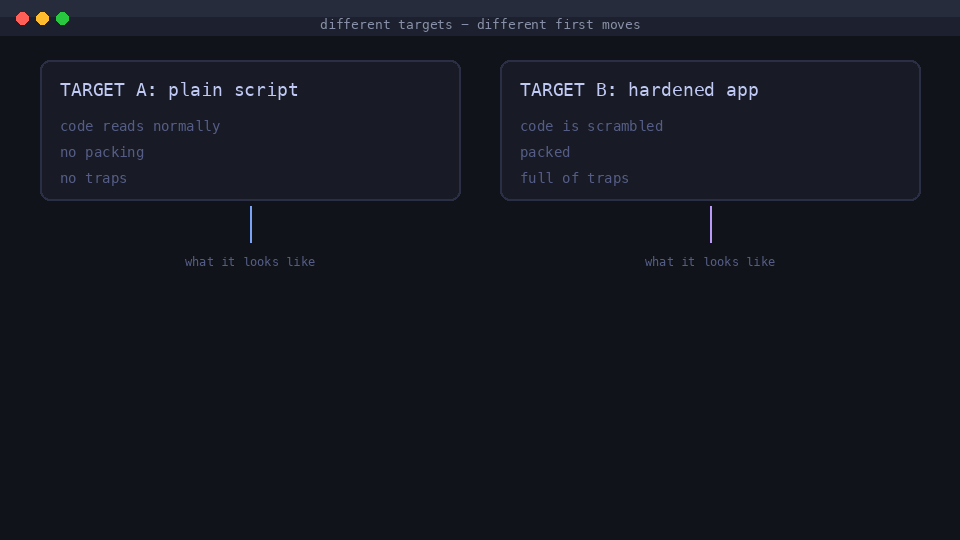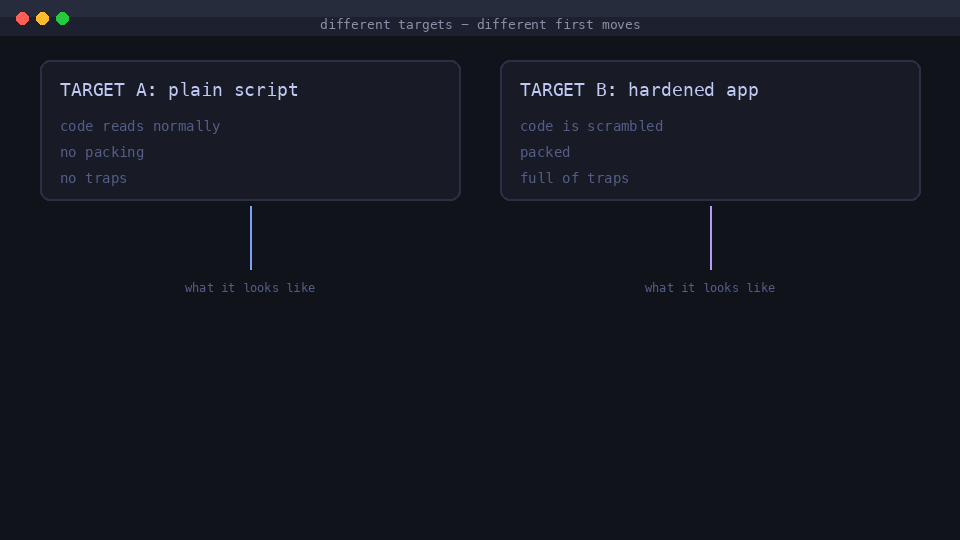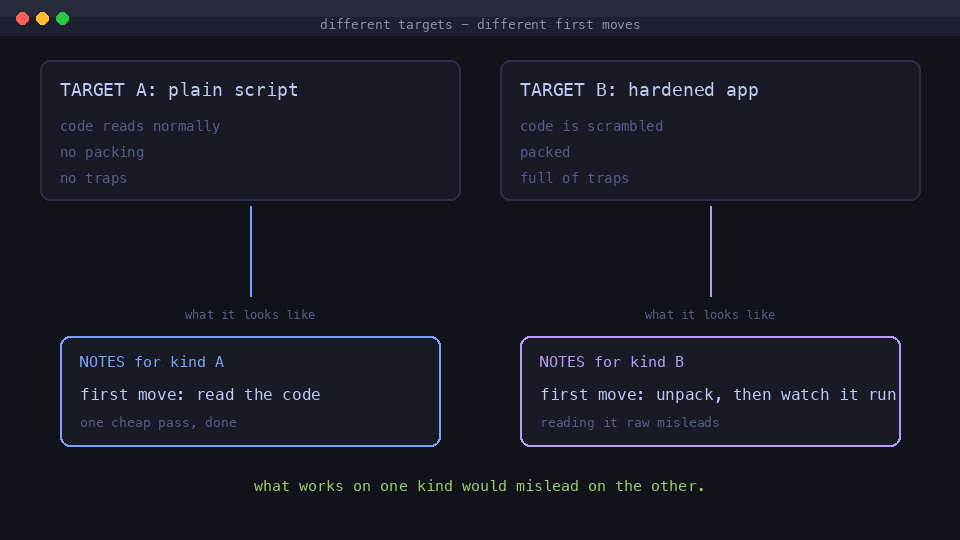
1. O primeiro movimento certo, por tipo de alvo. Um script simples e um app endurecido não devem abrir da mesma forma. O loop mantém notas separadas por tipo de alvo — como o alvo se parece decide qual playbook se aplica.
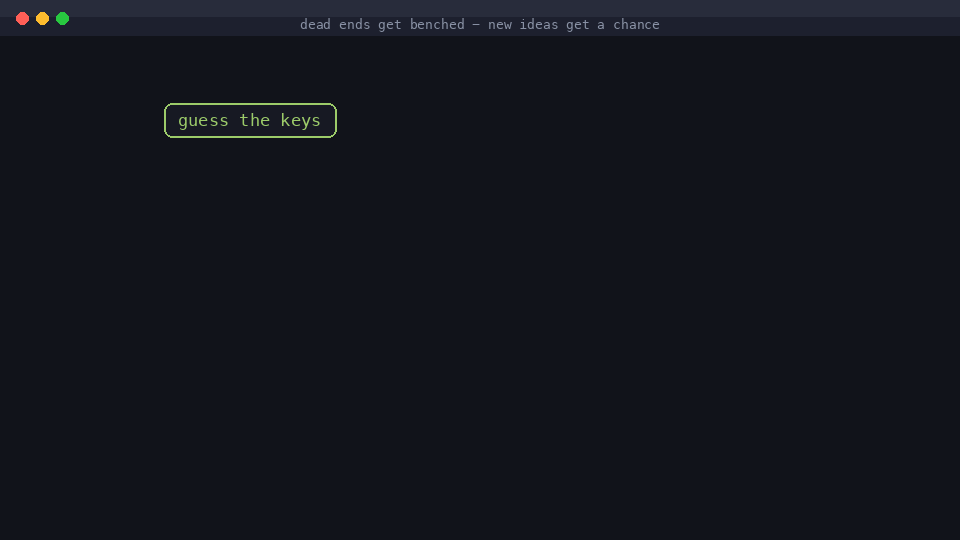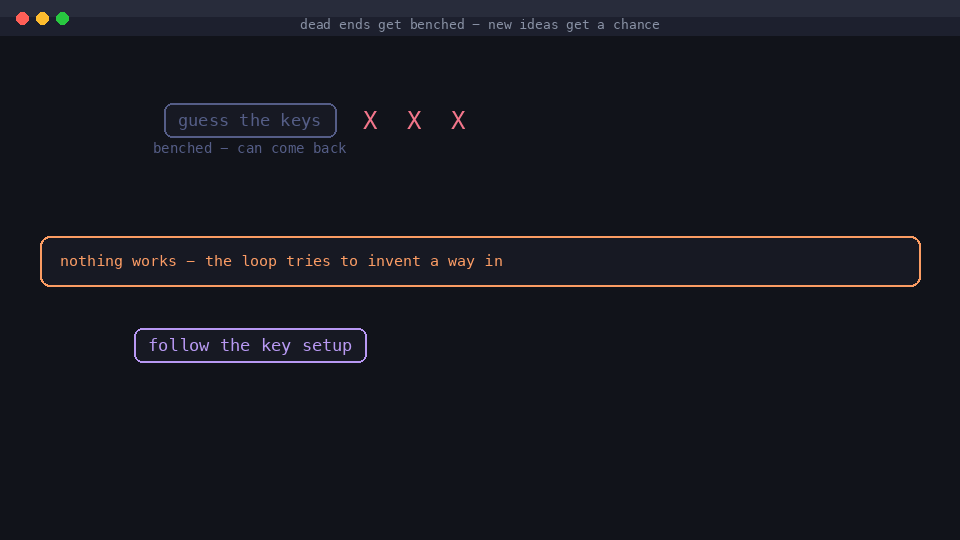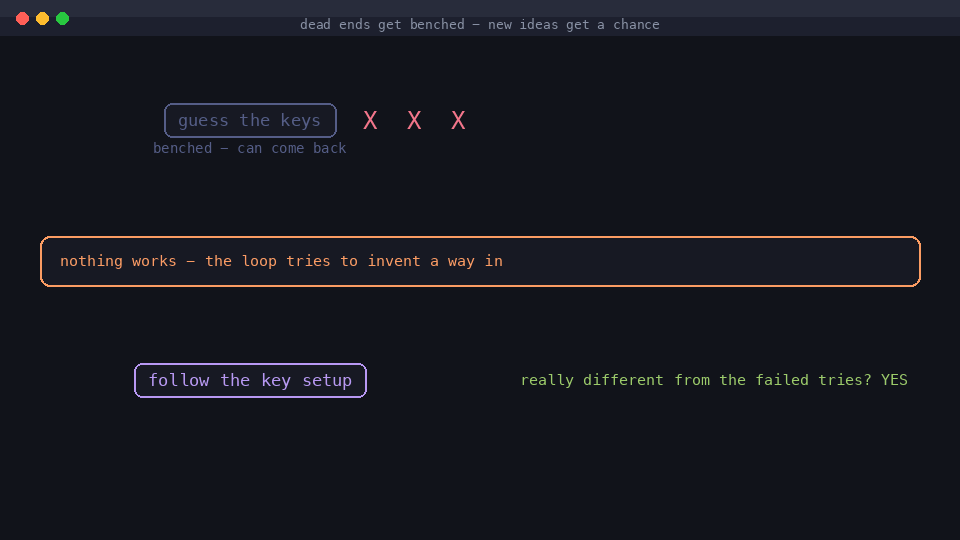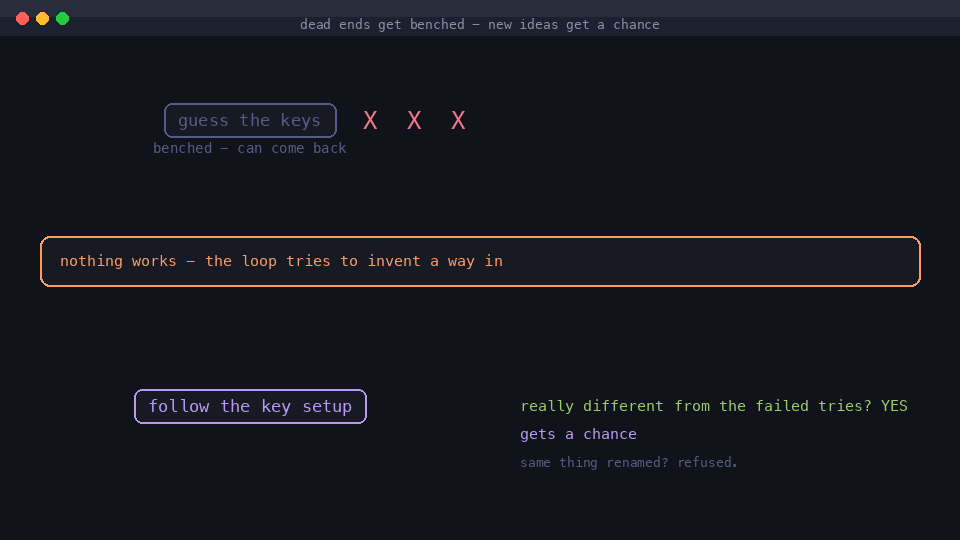
2. Quais métodos estão mortos. Um método que continua falhando vai para o banco — ele para de consumir orçamento (mas nunca é excluído; se o alvo mudar, ele pode voltar). E quando nada funciona, o loop tenta inventar um caminho de entrada: um ato de descoberta propõe uma abordagem genuinamente nova, verificada contra as tentativas falhas — a mesma ideia renomeada é recusada.
3. Onde verificar duas vezes. Estados onde os verificadores continuam sendo refutados aprendem a agendar a verificação de forma mais rigorosa ali — e relaxam quando a sequência se torna honesta. 4. Quais ferramentas rotear. Escolhas de ferramentas e provedores também são aprendidas: uma ferramenta que falha é rebaixada por um tempo e é reinstaurada no momento em que volta a funcionar - o roteamento segue os resultados registrados, não a ordem do registro.

