
 seclog-open/seclog
재현 가능한 Docker 공격 시나리오에서 다중 소스 보안 로그를 수집하고, 공격 체인을 구축하며, LLM의 공격 단계 추론을 평가하기 위한 SecLog-Bench-216 벤치마크를 제공합니다.

SecLog는 다중 소스 보안 로그로부터 공격 단계 추론에 관한 연구를 지원합니다. 재현 가능한 Docker 공격 및 정상 활동 시나리오에서 로그를 수집하고, 증거를 공격 체인으로 구성하며, 레이블이 지정된 데이터셋을 구축하고, 모델 예측을 평가하는 도구를 제공합니다.
이 릴리스에는 검토된 단계 레이블과 참조 추론 체인이 포함된 216개의 증거 윈도우로 구성된 즉시 사용 가능한 벤치마크인 SecLog-Bench-216이 포함되어 있습니다. 연구자들은 제공된 벤치마크를 직접 사용하거나 구축 파이프라인을 실행하여 새로운 데이터를 생성할 수 있습니다.
논문: SecLog-Bench: A Scalable Benchmark for Cybersecurity Log Reasoning with Scaffolded Evidence.
Zenodo의 구축 리소스: Docker 이미지, 원시 로그 및 정렬 인덱스, 그리고 구축된 공격 체인.
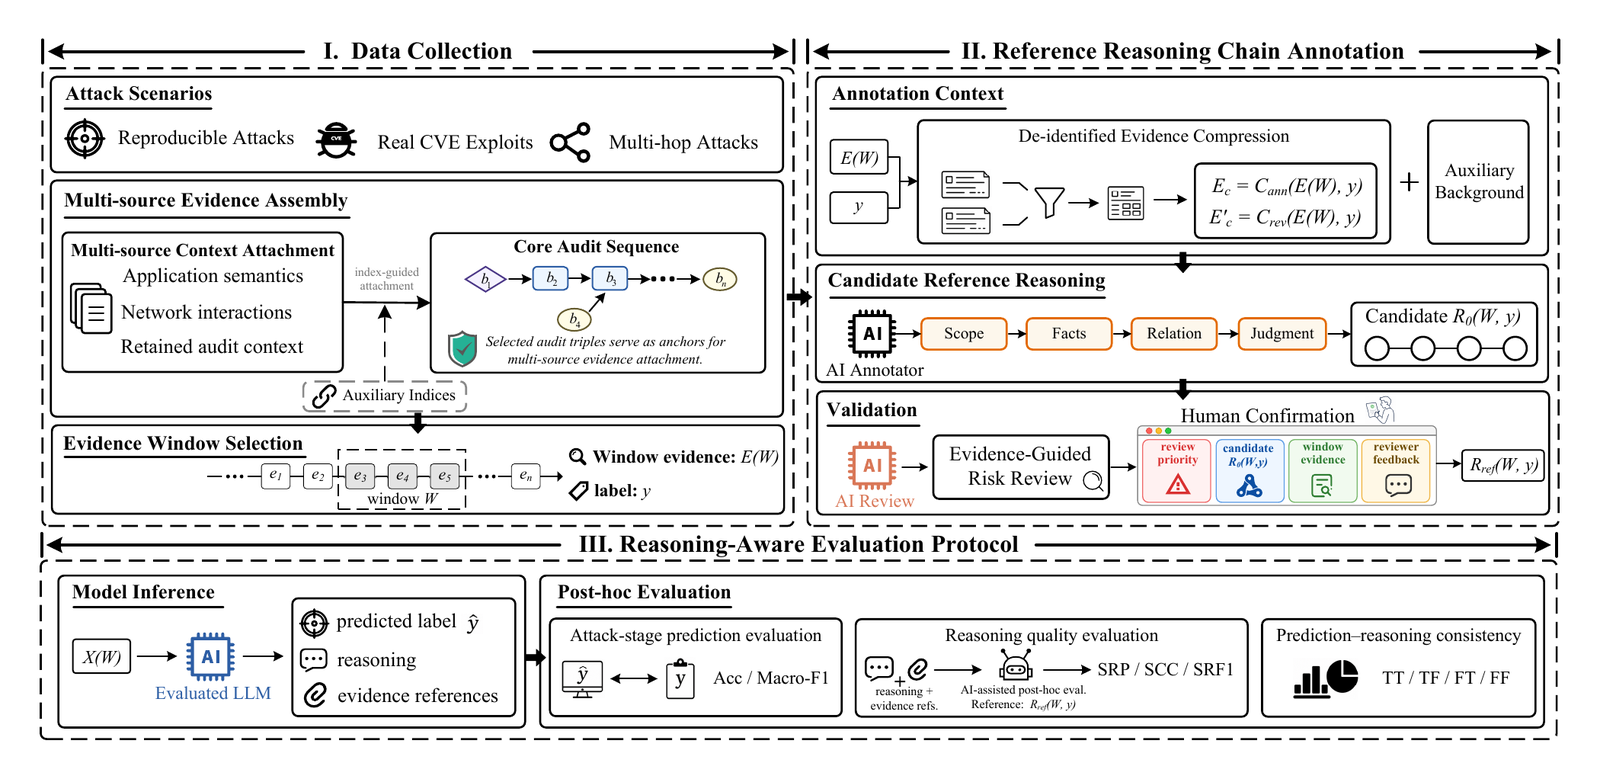
그림 1. SecLog 개요. 파트 I은 단계 01–04에 해당하고, 파트 II는 05의 주석 및 검토 워크플로에, 파트 III는 SecLog-Bench-216을 사용한 05의 평가 워크플로에 해당합니다.
| 목표 | 시작 지점 | 환경 |
|---|---|---|
| 제공된 데이터셋을 읽거나 재사용 | SecLog-Bench-216 및 데이터 예시 | 모든 JSONL 리더; 검증기용 Python 3.11 |
| 제공된 벤치마크에서 모델 평가 | 빠른 시작 | Python 3.11; 번들 추론 실행기를 위한 API 엔드포인트 및 키 |
| 새로운 로그를 수집하고 데이터셋 또는 벤치마크 구축 | 데이터 구축 | Ubuntu Linux, Python 3.11, Poetry, Docker 및 캡처 도구 |
자세한 시스템 패키지, 선택적 구성 요소 및 종속성 버전은 ENVIRONMENT_DEPENDENCIES.md에 나열되어 있습니다.
이 명령들은 Bash를 사용하며 프로젝트 루트에서 실행됩니다. 격리된 Python 3.11 환경으로 시작하십시오:
python3.11 -m venv ../seclog-env
source ../seclog-env/bin/activate
아래 명령은 Python 표준 라이브러리를 사용합니다. 로그 수집, 주석 달기, 검토 UI 및 추가 분석에 대해서는 환경 가이드를 참조하세요.
python 05_benchmark_annotation_review_evaluation/scripts/validate_public_benchmark.py
검증기는 샘플 수, ID, 레이블 분포, 증거 참조, 매니페스트 해시를 확인합니다. 검증에 성공하면 JSON 출력에 validation_passed: true와 sample_count: 216이 보고됩니다.
your-model-name을(를) 공급자가 지원하는 모델 식별자로 바꾸십시오:
python 05_benchmark_annotation_review_evaluation/evaluation/run_benchmark_inference.py \
  --prompt-pack SecLog-Bench-216/data/prompt_pack.jsonl \
  --model your-model-name \
  --output ../seclog-runs/example/raw_responses.jsonl
이 명령은 mode: preflight_no_api와 프롬프트 개수를 보고합니다. 이 명령은
프로바이더에 접속하거나 응답 파일을 생성하지 않으며, 프로바이더가 선택한 모델을
지원하는지 검증하지도 않습니다.
셸 환경에서 OPENAI_API_KEY를 설정하고, 아래 플레이스홀더를
프로바이더 키로 교체한 다음, API 호출을 명시적으로 활성화하세요:
export OPENAI_API_KEY="YOUR_API_KEY"
python 05_benchmark_annotation_review_evaluation/evaluation/run_benchmark_inference.py \
  --prompt-pack SecLog-Bench-216/data/prompt_pack.jsonl \
  --model your-model-name \
  --output ../seclog-runs/example/raw_responses.jsonl \
  --call-api
러너는 OpenAI 호환 채팅 엔드포인트를 사용합니다. 기본 base URL은
https://api.openai.com/v1이며, 다른 엔드포인트에는 --base-url을, 다른 키 변수 이름에는
--api-key-env를 전달합니다. 이 예시처럼 출력 디렉터리는 릴리스 트리
밖에 두십시오. 각 실행마다 새로운 출력 경로를 사용하거나, 기존 응답 파일을
계속하려면 --resume을 추가하십시오.
temperature, max_tokens 또는 JSON 모드를 거부하는 모델을 포함한 자체 추론 시스템을
사용하려면 SecLog-Bench-216/data/prompt_pack.jsonl과
예측 형식을 사용한 다음,
원시 출력을 아래의 정규화기(normalizer)에 전달하십시오.
python 05_benchmark_annotation_review_evaluation/evaluation/normalize_stage_reasoning_predictions.py \
  --input ../seclog-runs/example/raw_responses.jsonl \
  --output ../seclog-runs/example/predictions.jsonl

python 05_benchmark_annotation_review_evaluation/evaluation/evaluate_stage_reasoning_predictions.py \
  --gold SecLog-Bench-216/data/gold_labels.jsonl \
  --reference-chains SecLog-Bench-216/data/reference_reasoning_chains.jsonl \
  --model-input SecLog-Bench-216/data/evidence_windows.jsonl \
  --sample-index SecLog-Bench-216/data/sample_index.jsonl \
  --predictions ../seclog-runs/example/predictions.jsonl \
  --output-dir ../seclog-runs/example/evaluation
결과에는 다음이 포함됩니다:
| 출력 | 내용 |
|---|---|
predictions.jsonl | 정규화된 모델 예측 |
invalid_outputs.jsonl | 정규화에 성공하지 못한 응답 |
evaluation/metrics_summary.json | 집계된 평가 지표 |
evaluation/per_sample_results.jsonl | 샘플별 결과 |
evaluation/confusion_matrix.csv | 단계 예측 혼동 행렬 |
evaluation/per_stage_metrics.csv | 단계별 지표 |
evaluation/error_cases.jsonl | 오류 분석을 위해 보존된 사례 |
이 평가기에서의 참조/근거 중복은 진단 목적입니다. 공식적인 추론 품질 점수 산정에는 사후 추론 품질의 추가 체크리스트 및 어시스턴트 검토 워크플로가 필요합니다.
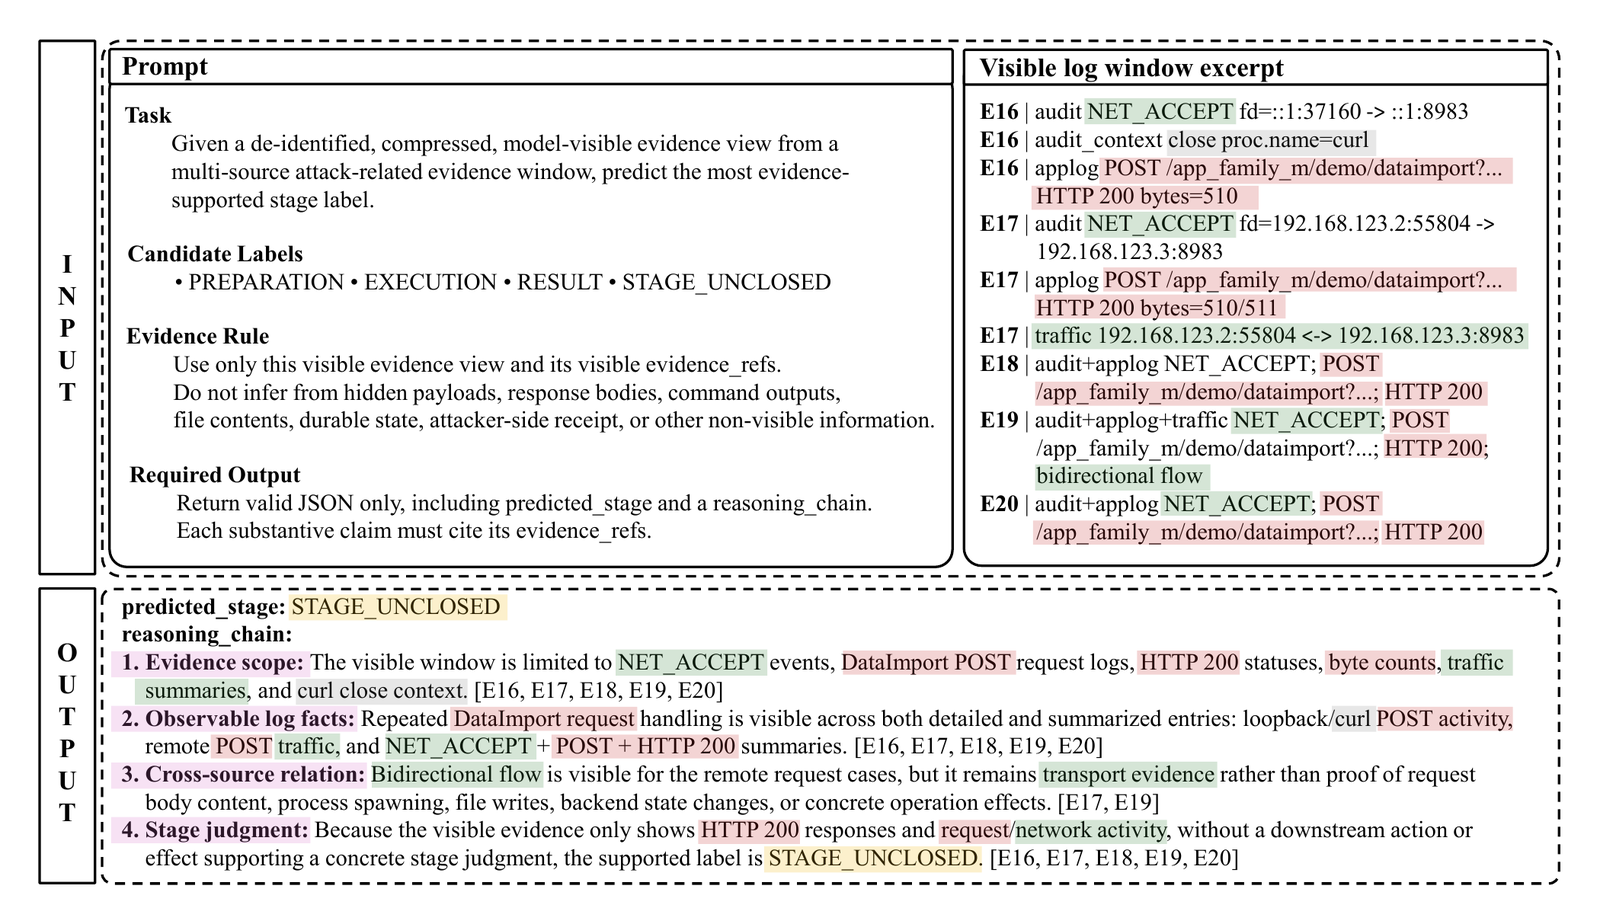
그림 2. 예시. 공개된 파일에서 단계 레이블은 소문자이며(예: stage_unclosed), 근거 참조는 샘플 로컬 edge_id 값을 사용합니다.
벤치마크는 JSONL을 사용합니다: 각 줄은 하나의 JSON 객체이며, 파일 간에
sample_id로 연결됩니다.
SecLog-Bench-216/data/ 아래 파일 | 역할 |
|---|---|
evidence_windows.jsonl | 선택된 체인과 첨부된 컨텍스트를 포함한 모델 가시 근거 |
prompt_pack.jsonl | 모델 추론을 위해 준비된 메시지 |
gold_labels.jsonl | 평가에 사용되는 검토된 레이블 |
reference_reasoning_chains.jsonl | 검토된 참조 주장 및 근거 참조 |
sample_index.jsonl | 샘플 순서 및 윈도우 메타데이터 |
dataset_manifest.json | 데이터셋 메타데이터 |
예를 들어, 다음은 sample_000001의 근거에서 발췌한 축약된 발췌본입니다.
다른 엣지, 컨텍스트, 메타데이터는 여기서 생략되었습니다;
추론에는 전체 레코드나 준비된 프롬프트를 사용하십시오.
{
  "sample_id": "sample_000001",
  "window": {
    "start_seq": 10,
    "end_seq": 14
  },
  "selected_spine": [
    {
      "seq": 10,
      "edge_id": "sample_000001_edge_000001",
      "subject": "proc_m",
      "relation": "PROCESS_FORK",
      "object": "proc_m"
    }
  ]
}
해당하는 실제 골드 레이블 레코드는 다음과 같습니다:
{
  "sample_id": "sample_000001",
  "gold_stage": "preparation",
  "supportability_tier": "strong",
  "window": {
    "start_seq": 10,
    "end_seq": 14
  }
}
모델은 출력 형식에 따라 predicted_stage와 증거를 참조한 reasoning_chain을 반환합니다. 위의 골드 레이블은 참조 답변이며, 측정된 모델 예측이 아닙니다. 레이블과 참조 추론은 테스트 대상 모델의 프롬프트에 포함하지 마십시오.
네 가지 레이블 각각은 54개의 샘플을 가집니다:
| 레이블 | 의미 |
|---|---|
preparation | 가시적 증거가 구체적인 공격 작업 이전의 탐색, 점검 또는 위치 선정을 뒷받침함 |
execution | 가시적 증거가 구체적인 공격 관련 작업을 뒷받침함 |
result | 가시적 증거가 공격 활동의 하위 효과를 뒷받침함 |
stage_unclosed | 증거가 공격과 관련되어 있으나 세 단계 중 하나를 안전하게 확립하지 못함 |
stage_unclosed는 양성 레이블이 아닙니다. 전체 정의는 레이블 스키마에 있습니다.
구축 워크플로는 Python 3.11이 설치된 Ubuntu Linux를 대상으로 합니다. 구축 환경 안내를 참고하여 Docker Engine/Compose, Sysdig, Tshark/tcpdump, conntrack, nsenter, 그리고 필요한 sudo/root 캡처 권한을 준비하십시오.
해당 사전 요구 사항과 시나리오 이미지를 준비한 후, stage-01 Python 의존성을 설치하고 번들된 장면 입력을 검증하십시오:
