
 jev-sec/jev-ids
TypeSafeのJevをベースにした、超高速でトークン効率に優れた侵入検知システム(IDS)。


1 リクエストで侵入検知。TypeSafe の Jev に 1 つのネットワークフローと 5 つのラベル付きサンプルを渡すだけ。そのフローが攻撃かどうか、そしてどの種類かを、解析すべきテキストなしで、0.5 秒で答えます。
Jev IDS は、サイバーセキュリティコミュニティの参照ベンチマークである NSL-KDD 上で、最先端の LLM(Vertex AI 上の Gemini 3.6 Flash)、古典的な機械学習モデル(Random Forest)、および教師なしモデル(Isolation Forest)に対してテストされました。2,000 フロー、3 シード、カテゴリごとのサンプル数 k は 0 から 8 です。同じ 5 つのサンプル(k = 1)を与えた場合、Jev IDS は次の結果でした。
F1 では LLM の方が優れた検出器です。k = 1 で 0.880 対 Jev の 0.856 であり、すべての k でリードしています(McNemar p < 0.001)。これは、サンプルに示された種類の攻撃をより多く捕捉するためです。Jev は 2 番目に優れ、サンプルに存在しない種類であるゼロデイ攻撃では、k = 1 から k = 8 まで LLM より多くを捕捉します(k = 1 で 0.747 対 0.713)。数値、図、およびその限界は Evidence and limits と docs/results.md にあります。
ループを読む · リクエストテンプレート · 用語集
Jev は System One Model です。テキストを書く代わりに、state を読み取り、それについての型付きの質問に確率で答えます。Jev IDS は 1 つのフローを、指示、列名、5 つのカテゴリの説明、およびラベル付きサンプルとともに state に入れ、2 つの質問をします。is_attack は確率として返ります。category は信頼度付きの 5 つの選択肢のいずれかとして返ります。確率が 0.5 に達したとき、判定は攻撃となります。
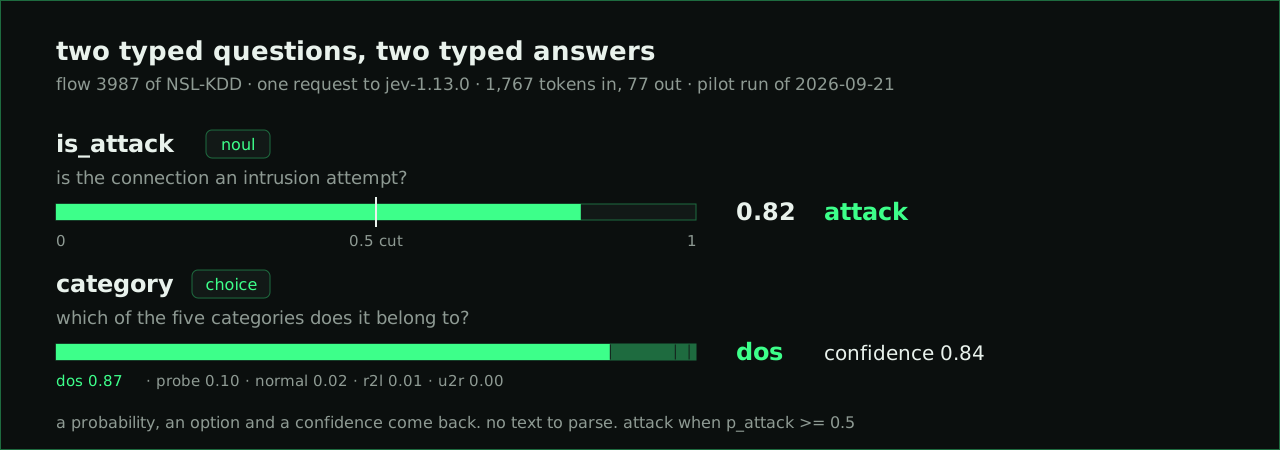
すべてのリクエストは同じ経路をたどります。
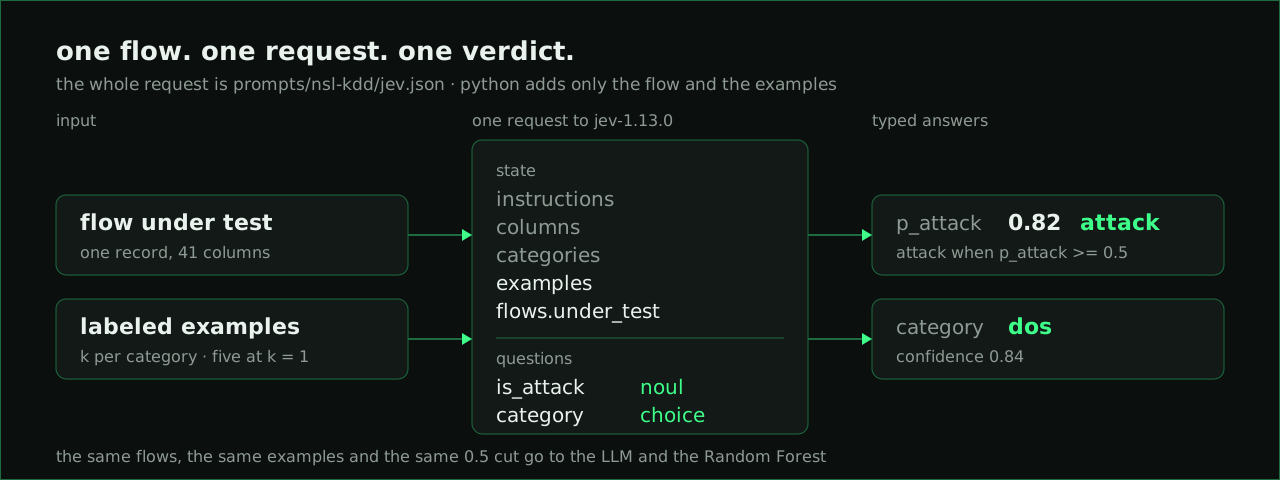
リクエスト全体は 1 つのファイル、prompts/nsl-kdd/jev.json です。Python はフローとサンプルのみを追加し、ファイルの sha256 は prompt_hash としてすべての予測行に含まれるため、異なる内容を尋ねた実行が同等として比較されることはありません。サンプルはカテゴリによってのみラベル付けされます。neptune のような攻撃名がモデルに届くことはありません。
同じフロー、サンプル、および 0.5 のカットが 2 つのベースラインに渡されます。JSON 出力スキーマを持つ Agno エージェント経由の LLM(論文では Vertex AI 経由の Gemini 3.6 Flash、代替として ChatGPT Codex バックエンド経由の GPT-5.6 または DeepSeek)と、同じサンプルで訓練された scikit-learn Random Forest です。3 番目のベースラインである Isolation Forest は、プールの良性フローのみで適合され、サンプルを一切見ません。これは教師なしの参照であり、k = all のみです。
git clone https://github.com/jev-sec/jev-ids.git
cd jev-ids
uv sync
# .env: TYPESAFE_API_KEY for Jev. Gemini needs `gcloud auth application-default login` and GOOGLE_GENAI_USE_VERTEXAI=true,
# GOOGLE_CLOUD_PROJECT and GOOGLE_CLOUD_LOCATION=global in the environment; DEEPSEEK_API_KEY and CHATGPT_CLIENT_ID only for the other LLMs.
NSL-KDD を data/raw/nsl-kdd/ にダウンロードし、一度だけ準備します。
uv run python -m scripts.prepare_nsl_kdd
uv run jev-ids run --dataset data/nsl-kdd/dataset.json --detector jev --split smoke --k 0,1
smoke スプリットは 5 フローです。実行は results/<timestamp>-nsl-kdd-jev-smoke/ に config.json、predictions.jsonl 内のフローごとの 1 つの JSON 行(判定、真値、p_attack、カテゴリ、信頼度、レイテンシ、およびゲートウェイのトークンレポート)、および responses.jsonl 内の生の回答を書き込みます。
uv run jev-ids run --dataset data/nsl-kdd/dataset.json --detector jev --split pilot --k 0,1,2,4,8 --seeds 0,1,2
uv run jev-ids run --dataset data/nsl-kdd/dataset.json --detector llm:gemini --model gemini-3.6-flash --split pilot --k 0,1,2,4,8
uv run jev-ids run --dataset data/nsl-kdd/dataset.json --detector random_forest --split pilot --k 1,2,4,8,all
uv run jev-ids run --dataset data/nsl-kdd/dataset.json --detector isolation_forest --split pilot --k all
uv run jev-ids metrics results/<run_id> [results/<run_id> ...] > results/summary.csv
uv run jev-ids compare --a results/<jev_run> --b results/<rf_run> --subset novel --k-a 0 --k-b all  # novel = zero-day attacks
k はカテゴリごとのラベル付きサンプル数です。5 カテゴリで k = 1 は 5 つのサンプルを意味し、all はプール全体を意味します。metrics は検出器と k ごとに 1 つの CSV 行を出力し、F1、ゼロデイ攻撃(コードでは novel)およびカテゴリごとの再現率、p_attack の PR-AUC と ROC-AUC、トークン、レイテンシ、コストを含みます。compare は 2 つの実行をフローごとに対にし、不一致ペアに対して McNemar 検定を実行します。これは、2 つの検出器が不一致となるフローのみがそれらを区別するためです。コストは、すべての検出器について同様に、トークン数に prices.json の定価を掛けてオフラインで計算されます。
docs/protocol.md は入力(2,000 フローの paper スプリット、プロンプト、モデル ID、価格)を固定し、make paper はそのスプリット上で 4 つの検出器を実行して results/paper/ に出力し、results/paper/summary.csv を書き込みます。各検出器には独自のターゲット(make paper-jev、make paper-llm、make paper-random-forest、make paper-isolation-forest)があるため、別々のターミナルで実行できます。遅いのは LLM です。make paper-llm は Vertex AI 上の Gemini 3.6 Flash を 5 つの並列プロセスとして実行し、k ごとに 1 つです(make -j5 paper-llm)。クォータエラーやタイムアウトはエラー行となり、uv run jev-ids redo-errors results/paper/<run> がそれらのフローをその場で再度判定します。完全な表と図は docs/results.md にあります。
error を持つ行となり、アラートなしとしてカウントされます。クラッシュすることはありません。
