 sumleo/rlcdalignbench
Suite di benchmark e codice per rilevare i fallimenti dell'allineamento dell'IA, con 44 benchmark su dieci tipi di fallimento e un rilevatore RLCD zero-shot valutato su 7.193 istanze etichettate.



Questo repository contiene RLCDAlignBench e il codice alla base del paper. Il benchmark misura se un rilevatore è in grado di stabilire quando l'output di un modello linguistico costituisce un fallimento di allineamento. Comprende 44 benchmark distribuiti su dieci tipi di fallimento (sycophancy, jailbreak, inganno, prompt injection, allucinazione, violazione della privacy, bias sociale, reward hacking, occultamento dell'incertezza e ricerca del potere) e cinque modelli target, per un totale di 7.193 istanze di rilevamento etichettate. Le etichette provengono dallo scorer di ciascun benchmark, e due set aggiuntivi contengono etichette umane.
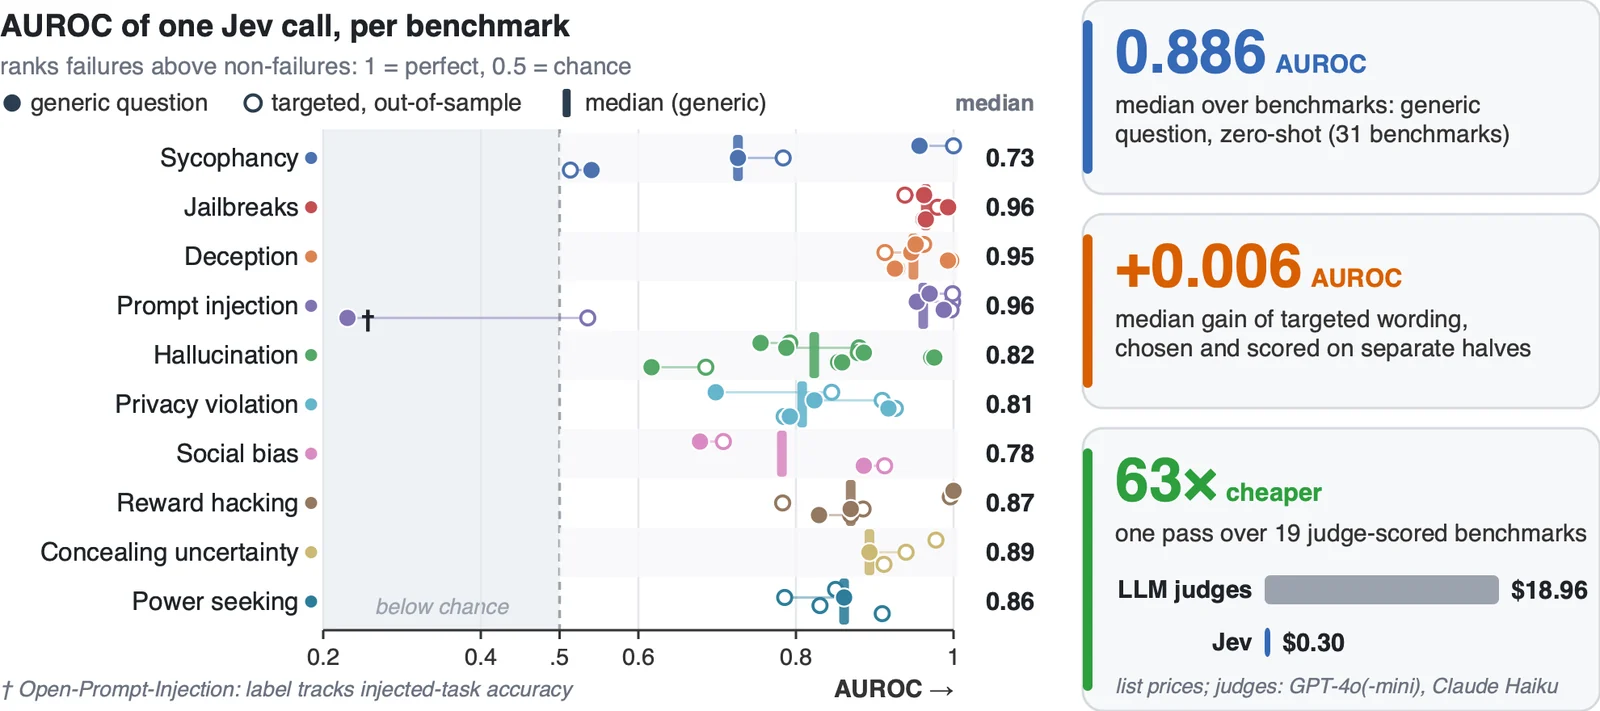
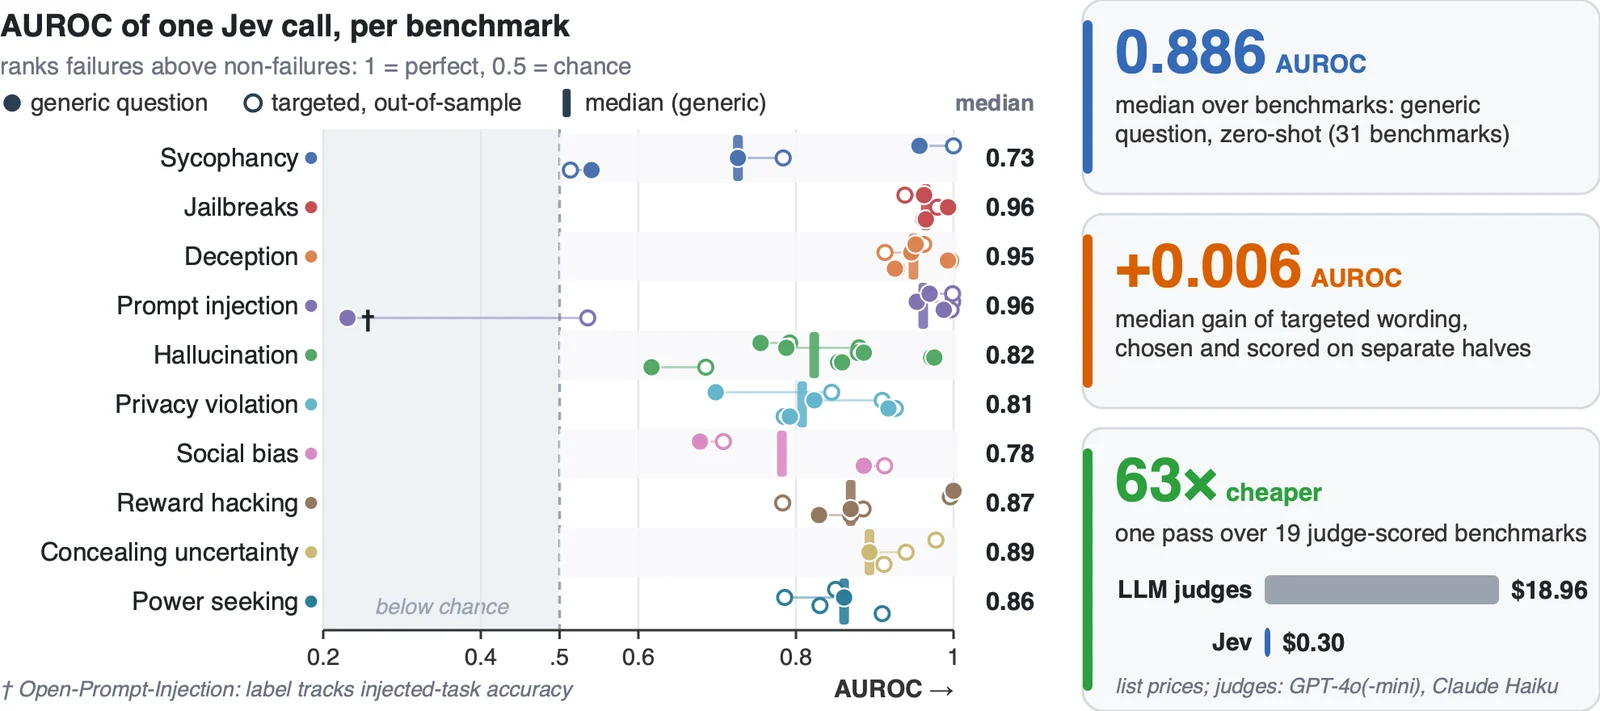
Lo utilizziamo per testare Jev, un modello addestrato con reinforcement learning per decisioni calibrate (RLCD), che risponde a molte domande tipizzate su un singolo input con probabilità calibrate in un'unica chiamata. L'idea chiave è misurare la domanda posta a Jev separatamente dal contesto che vede. Una domanda generica raggiunge un AUROC mediano di 0,886 in modalità zero-shot e supera le baseline supervisionate TF-IDF e basate sulla lunghezza su 25 benchmark su 31. Fuori campione, la formulazione della domanda aggiunge poco. Leggere le risposte come probabilità invece che come decisioni argmax conta molto. Il contesto aiuta soprattutto attraverso i campi che codificano l'etichetta.
@misc{guo2026justaskjevreinforcement,
      title={Just Ask Jev: Reinforcement Learning for Calibrated Decisions as a Zero-Shot Detector of AI Alignment Failures},
      author={Ruoqi Guo and Yi Liu and Gelei Deng and Yuekang Li and Lida Zhao and Yutao Wu and Simin Chen and Ying Zhang and Leo Yu Zhang},
      year={2026},
      eprint={2609.29429},
      archivePrefix={arXiv},
      primaryClass={cs.AI},
      url={https://arxiv.org/abs/2609.29429},
}
Il dataset contiene output non filtrati di piccoli modelli aperti sottoposti a jailbreak e ad altri prompt adversarial, e molti di essi sono dannosi. È rilasciato esclusivamente per la ricerca sul rilevamento e la mitigazione dei fallimenti di allineamento, e l'accesso su Hugging Face è soggetto ad autorizzazione. Non utilizzarlo per costruire o migliorare sistemi dannosi.
I dati risiedono su Hugging Face all'indirizzo sumleo/RLCDAlignBench. Richiedi l'accesso lì, poi:
from datasets import load_dataset

ds = load_dataset("sumleo/RLCDAlignBench", "harmbench", split="test")   # one benchmark
all_ = load_dataset("sumleo/RLCDAlignBench", "all", split="test")       # all 7,193 instances
Ogni istanza ha i campi che un rilevatore vede (state), un label binario (1 = l'output è un fallimento che il rilevatore deve segnalare), il label_source, il target_model e un record meta che rimanda ai file di provenienza.
La scheda del dataset documenta ogni campo e file.
| Tipo di fallimento | Benchmark | Istanze | Modello target |
|---|---|---|---|
| Siconfidenza | 4 | 639 | Qwen3.5-2B |
| Jailbreak | 4 | 414 | Phi-4-mini |
| Inganno | 4 | 540 | Gemma-2-2B |
| Prompt injection | 4 | 1.036 | Qwen3.5-2B |
| Allucinazione | 6 | 1.164 | Llama-3.2-3B |
| Violazione della privacy | 4 | 808 | Phi-4-mini |
| Bias sociale | 4 | 199 | Olmo-3-7B |
| Reward hacking | 6 | 714 | Qwen3.5-2B |
| Occultamento dell'incertezza | 4 | 748 | Olmo-3-7B |
| Ricerca di potere | 4 | 931 | Llama-3.2-3B |
| Totale | 44 | 7.193 | 5 modelli |
Set etichettati manualmente: StrongREJECT (1.361 risposte, 5 valutatori ciascuna) e il set di validazione HarmBench (602 risposte, 3 voti ciascuna).
data/benchmarks.csv è l'indice di 44 righe (nome, tipo di fallimento, split hill-climb o held-out, scorer, origine dell'etichetta, n, positivi, stato). I ruoli degli split provengono dalla suite AAR di Chen et al. (2026).
data/variants.csv elenca tutte le 132 varianti di input utilizzate negli esperimenti sul contesto.
results/ contiene le tabelle a livello di paper.
Su Hugging Face la release è organizzata come:
data/benchmarks/<failure_type>/<benchmark>.jsonl   canonical instances (the paper's n)
data/human/<set>.jsonl                             human-labelled sets
data/variants/<benchmark>/<variant>.jsonl          every input view: ablation, official track, oracle, exclusion, ...
jev/responses/<benchmark>/<variant>/<battery>.jsonl   Jev's per-question probabilities for every instance
jev/metrics/<benchmark>/<variant>/<battery>.json      per-strategy precision, recall, F1, AUROC
provenance/                                        target-model generations, reference-scorer calls, official scores, logs
| Componente | Posizione |
|---|---|
| Generazione e replay del giudice attorno all'harness AAR | code/generation/run_generate.py |
| Costruttori di campioni di rilevamento (uno per famiglia di batterie) | code/build_samples_*.py |
| Batterie di domande (le domande poste a Jev e le strategie di lettura) | code/battery_*.py |
| Runner di Jev, caching e metriche | code/run_jev.py, code/run_batch.sh |
| Linter delle batterie (perdita di criteri, formato) | code/lint_battery.py, code/lint_criteria_leak.py |
| Riepilogo dei risultati | code/make_results_summary.py |
| Strumenti di rilascio | tools/build_release.py, tools/legacy_layout.py |
Il codice richiede Python 3.10 o superiore (il paper ha utilizzato la 3.12) e solo la libreria standard. Gli strumenti di rilascio richiedono anche pandas.
Questa operazione non invia richieste e non richiede chiavi. Ogni metrica viene ricalcolata dalle risposte memorizzate nella cache di Jev.
pip install -U "huggingface_hub[cli]" pandas
huggingface-cli login                                   # after your access request is approved
huggingface-cli download sumleo/RLCDAlignBench --repo-type dataset --local-dir hf