
 seclog-open/seclog
Raccoglie log di sicurezza da più fonti provenienti da scenari di attacco Docker riproducibili, costruisce catene di attacco e fornisce il benchmark SecLog-Bench-216 per valutare il ragionamento degli LLM sulle fasi di attacco.

SecLog supporta la ricerca sul ragionamento per fasi di attacco a partire da log di sicurezza multi-sorgente. Fornisce strumenti per raccogliere log da scenari riproducibili di attacco e di attività normale in Docker, organizzare le evidenze in catene di attacco, costruire dataset etichettati e valutare le previsioni dei modelli.
La release include SecLog-Bench-216, un benchmark pronto all'uso di 216 finestre di evidenza con etichette di fase revisionate e catene di ragionamento di riferimento. I ricercatori possono utilizzare direttamente il benchmark fornito oppure eseguire la pipeline di costruzione per produrre nuovi dati.
Paper: SecLog-Bench: A Scalable Benchmark for Cybersecurity Log Reasoning with Scaffolded Evidence.
Risorse di costruzione su Zenodo: immagini Docker, log grezzi e indici di allineamento e catene di attacco costruite.
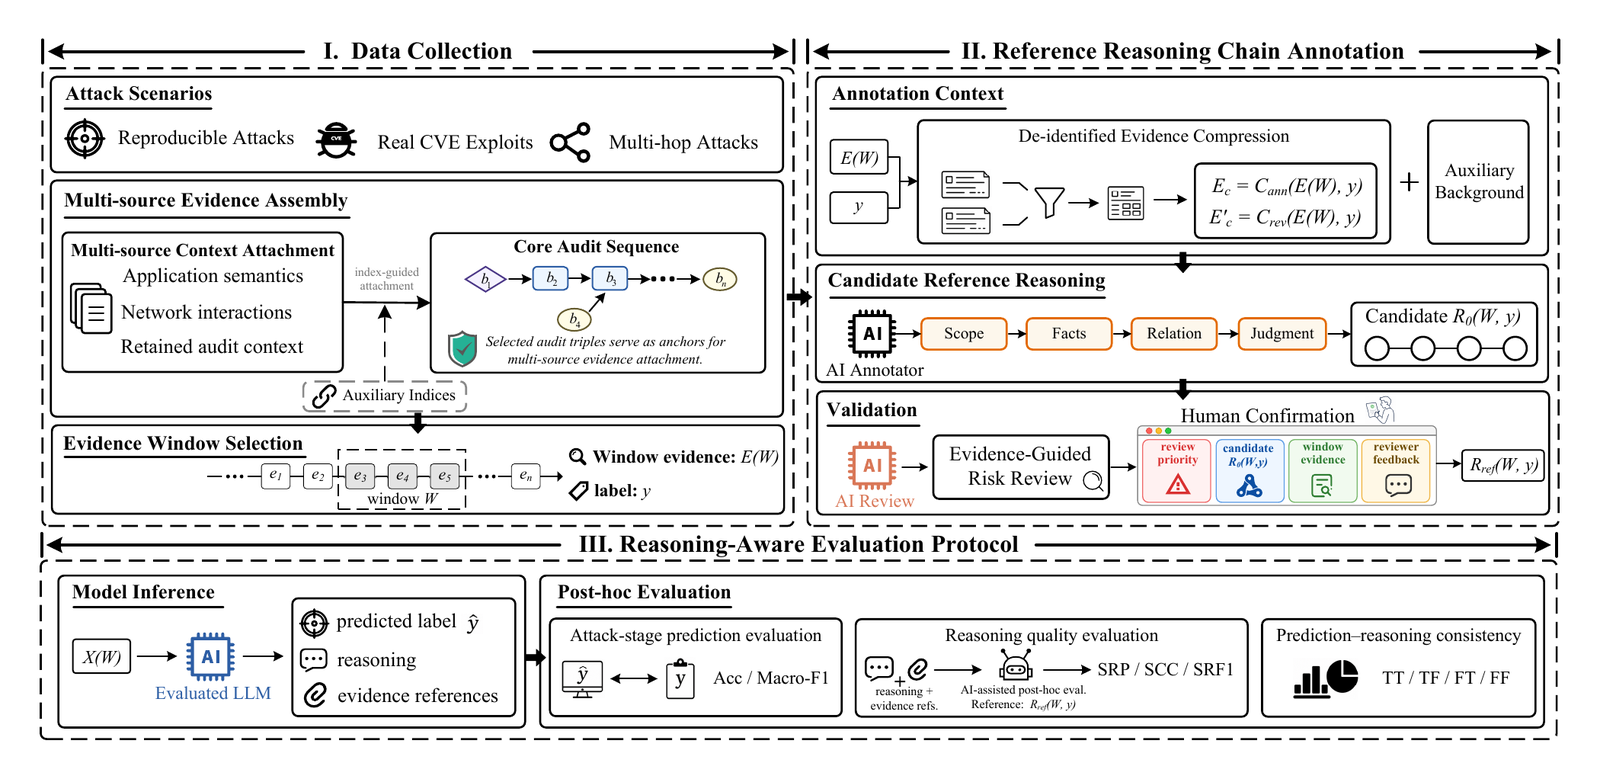
Figura 1. Panoramica di SecLog. La Parte I corrisponde alle fasi 01–04, la Parte II al flusso di annotazione e revisione in 05, e la Parte III al flusso di valutazione in 05 con SecLog-Bench-216.
| Il tuo obiettivo | Inizia da qui | Ambiente |
|---|---|---|
| Leggere o riutilizzare il dataset fornito | SecLog-Bench-216 e esempi di dati | Qualsiasi lettore JSONL; Python 3.11 per il validatore |
| Valutare un modello sul benchmark fornito | Avvio rapido | Python 3.11; un endpoint API e una chiave per il runner di inferenza incluso |
| Raccogliere nuovi log e costruire un dataset o un benchmark | Costruzione dei dati | Ubuntu Linux, Python 3.11, Poetry, Docker e strumenti di cattura |
I pacchetti di sistema dettagliati, i componenti opzionali e le versioni delle dipendenze sono elencati in ENVIRONMENT_DEPENDENCIES.md.
Questi comandi utilizzano Bash e vanno eseguiti dalla radice del progetto. Inizia con un ambiente Python 3.11 isolato:
python3.11 -m venv ../seclog-env
source ../seclog-env/bin/activate
I comandi seguenti utilizzano la libreria standard di Python. Per la raccolta dei log, l'annotazione, l'interfaccia di revisione e analisi aggiuntive, consultare la guida all'ambiente.
python 05_benchmark_annotation_review_evaluation/scripts/validate_public_benchmark.py
Il validatore controlla i conteggi dei campioni, gli ID, la distribuzione delle etichette, i riferimenti alle evidenze e gli hash del manifest. Una validazione riuscita riporta validation_passed: true e sample_count: 216 nel suo output JSON.
Sostituisci your-model-name con l'identificatore del modello supportato dal tuo provider:
python 05_benchmark_annotation_review_evaluation/evaluation/run_benchmark_inference.py \
  --prompt-pack SecLog-Bench-216/data/prompt_pack.jsonl \
  --model your-model-name \
  --output ../seclog-runs/example/raw_responses.jsonl
Questo comando riporta mode: preflight_no_api e il conteggio dei prompt. Non
contatta il provider né crea un file di risposta, e non
verifica che il provider supporti il modello selezionato.
Imposta OPENAI_API_KEY nell'ambiente della tua shell, sostituendo il segnaposto
qui sotto con la chiave del tuo provider, quindi abilita esplicitamente le chiamate API:
export OPENAI_API_KEY="YOUR_API_KEY"
python 05_benchmark_annotation_review_evaluation/evaluation/run_benchmark_inference.py \
  --prompt-pack SecLog-Bench-216/data/prompt_pack.jsonl \
  --model your-model-name \
  --output ../seclog-runs/example/raw_responses.jsonl \
  --call-api
Il runner utilizza un endpoint chat compatibile con OpenAI. Il suo URL di base predefinito è
https://api.openai.com/v1; passare --base-url per un altro endpoint e
--api-key-env per un altro nome di variabile della chiave. Mantenere la directory di output
al di fuori dell'albero di rilascio, come in questo esempio. Utilizzare un nuovo percorso di output per ogni
esecuzione, oppure aggiungere --resume per continuare un file di risposta esistente.
Per utilizzare il proprio sistema di inferenza, inclusi i modelli che rifiutano temperature,
max_tokens o la modalità JSON, utilizzare SecLog-Bench-216/data/prompt_pack.jsonl e il
formato di predizione, quindi passare
gli output grezzi al normalizzatore sottostante.
python 05_benchmark_annotation_review_evaluation/evaluation/normalize_stage_reasoning_predictions.py \
  --input ../seclog-runs/example/raw_responses.jsonl \
  --output ../seclog-runs/example/predictions.jsonl

python 05_benchmark_annotation_review_evaluation/evaluation/evaluate_stage_reasoning_predictions.py \
  --gold SecLog-Bench-216/data/gold_labels.jsonl \
  --reference-chains SecLog-Bench-216/data/reference_reasoning_chains.jsonl \
  --model-input SecLog-Bench-216/data/evidence_windows.jsonl \
  --sample-index SecLog-Bench-216/data/sample_index.jsonl \
  --predictions ../seclog-runs/example/predictions.jsonl \
  --output-dir ../seclog-runs/example/evaluation
I risultati includono:
| Output | Contenuto |
|---|---|
predictions.jsonl | Predizioni del modello normalizzate |
invalid_outputs.jsonl | Risposte che non è stato possibile normalizzare con successo |
evaluation/metrics_summary.json | Metriche di valutazione aggregate |
evaluation/per_sample_results.jsonl | Risultati per singolo campione |
evaluation/confusion_matrix.csv | Matrice di confusione delle predizioni di stage |
evaluation/per_stage_metrics.csv | Metriche per stage |
evaluation/error_cases.jsonl | Casi conservati per l'analisi degli errori |
La sovrapposizione tra riferimento ed evidenza in questo valutatore è diagnostica. La valutazione formale della qualità del ragionamento richiede il workflow aggiuntivo di checklist e revisione assistente descritto in Post-hoc reasoning quality.
