confusable-vision
Il primo dataset di confondibili font per font al mondo. Quali caratteri Unicode assomigliano a quali, misurato dai contorni dei font anziché dai pixel. La release attuale, 2026.09.26, confronta ogni lettera e cifra che ciascuno dei 322 font disegna, alla dimensione e alla posizione della linea di base che ogni glifo ha nel testo corrente. I sosia delle lettere e cifre ASCII vengono poi verificati sul posto: inseriti tra altre lettere in font comuni alla dimensione con cui le persone le leggono, e confrontati con coppie che tutti accettano come simili, come 0 e O.
addons.mozilla.org usa caratteri di confusable-vision per verificare i nomi degli add-on alla ricerca di sosia, accreditato nel codice sorgente di Mozilla; vedi Usato da.
Usato da
- Mozilla addons-server, il codice dietro addons.mozilla.org, aggiunge caratteri dall'output di confusable-vision alla tabella che usa per ridurre i sosia ad ASCII quando verifica i nomi degli add-on:
src/olympia/amo/confusables.py, pull request #24468, #24541, #24612 e #24665 (da febbraio a marzo 2026).
- disarm (raeq/disarm), che canonicalizza l'Unicode avversariale prima che raggiunga classificatori, indici e identificatori, aggiunge coppie misurate da confusable-vision alle sue tabelle di confondibili:
data/confusables_supplement.tsv, data/confusables_vision.tsv.
- SilverSpeak (ACMCMC/silverspeak), una libreria Python per eseguire e neutralizzare attacchi homoglyph sul testo, costruisce i vicini visivi nel suo grafo di homoglyph dai file di scoperta di confusable-vision (
docs/hkb.md).
- namespace-guard distribuisce le coppie misurate, e attraverso di esso raggiungono agent-sanitizer, che usa namespace-guard come motore predefinito per ridurre i caratteri sosia nell'input delle chiamate agli strumenti di un agente AI ad ASCII (deps.dev).
Questi progetti hanno preso i loro dati dagli output di confusable-vision di febbraio e marzo 2026.
Discusso su Hacker News: Ho renderizzato 1.418 confondibili su 230 font e Confusables.txt e NFKC sono in disaccordo su 31 caratteri.
Release 2026.09.26 in cifre:
- 322 font: ogni font su macOS, inclusi quelli che scarica su richiesta come PingFang, più Roboto, Noto Sans, Noto Serif, Noto Sans CJK e DejaVu. 64.751 code point in 140 script.
- 11.517 coppie simili in almeno un font o combinazione di font, di cui 5.975 superano le soglie suggerite.
- 719 coppie di un carattere e una sequenza ASCII di due lettere, come ǁ e ll, o Ы e bl.
- 3.055 sosia candidati di lettere, cifre e sequenze ASCII verificati sul posto: 646 simili al livello strict, altri 358 al livello broad, altri 101 che corrispondono al design di un'altra lettera in un font comune. 224 di quelli strict non sono in confusables.txt di Unicode.
I dati sono pubblicati come release versionata in data/release/2026.09.26/ (CC-BY-4.0). namespace-guard e d0ma1n sono costruiti su di essa.
Cosa è cambiato dalla release 2
La release 2 (2026.09.24, e 2026.09.25 per i dati TLD) confrontava solo le coppie e i font che le esecuzioni precedenti avevano confrontato. Un audit dei glifi identici ha rilevato che catturava 637 dei 2.654 casi in cui un font disegna due caratteri con lo stesso glifo. La release 3 corregge questo e aggiunge tre cose:
- Copertura. Ogni lettera e cifra che ciascun font disegna è confrontata con ogni altra in quel font, inclusi Han e Hangul. La release 2 prendeva i suoi caratteri da una lista fissa, quindi non raggiungeva mai la maggior parte di Yi, Canadian Aboriginal, Ethiopic o degli script indici, e perdeva i font solo-script e PingFang.
- Le facce giuste. Le collezioni di font sono caricate nella faccia che un browser usa per il testo del corpo. Le esecuzioni precedenti prendevano la prima faccia, che per alcune collezioni era bold, black o italic.
- Contorni sovrapposti, come nei font variabili quali San Francisco, sono misurati come l'unione dei loro tratti, come li vede un lettore.
- Sequenze di due lettere. Ogni sequenza di due lettere o cifre ASCII (3.844) è composta come la compone ciascun font, con il suo kerning e le sue legature, e confrontata come un carattere.
- La soglia cross-font è fissata dal quartile superiore dei font di pagina, così aggiungere font all'indagine non può spostarla.
- La verifica sul posto (sotto).
Le cifre di marzo 2026 (249.976 coppie di singoli caratteri e 2.524.275 coppie di bigrammi su 245 font) provenivano da misurazioni che ignoravano dimensione e linea di base. Sono superate; i file di quelle esecuzioni restano in data/output/ per riferimento.
Come funziona
Misurare i glifi
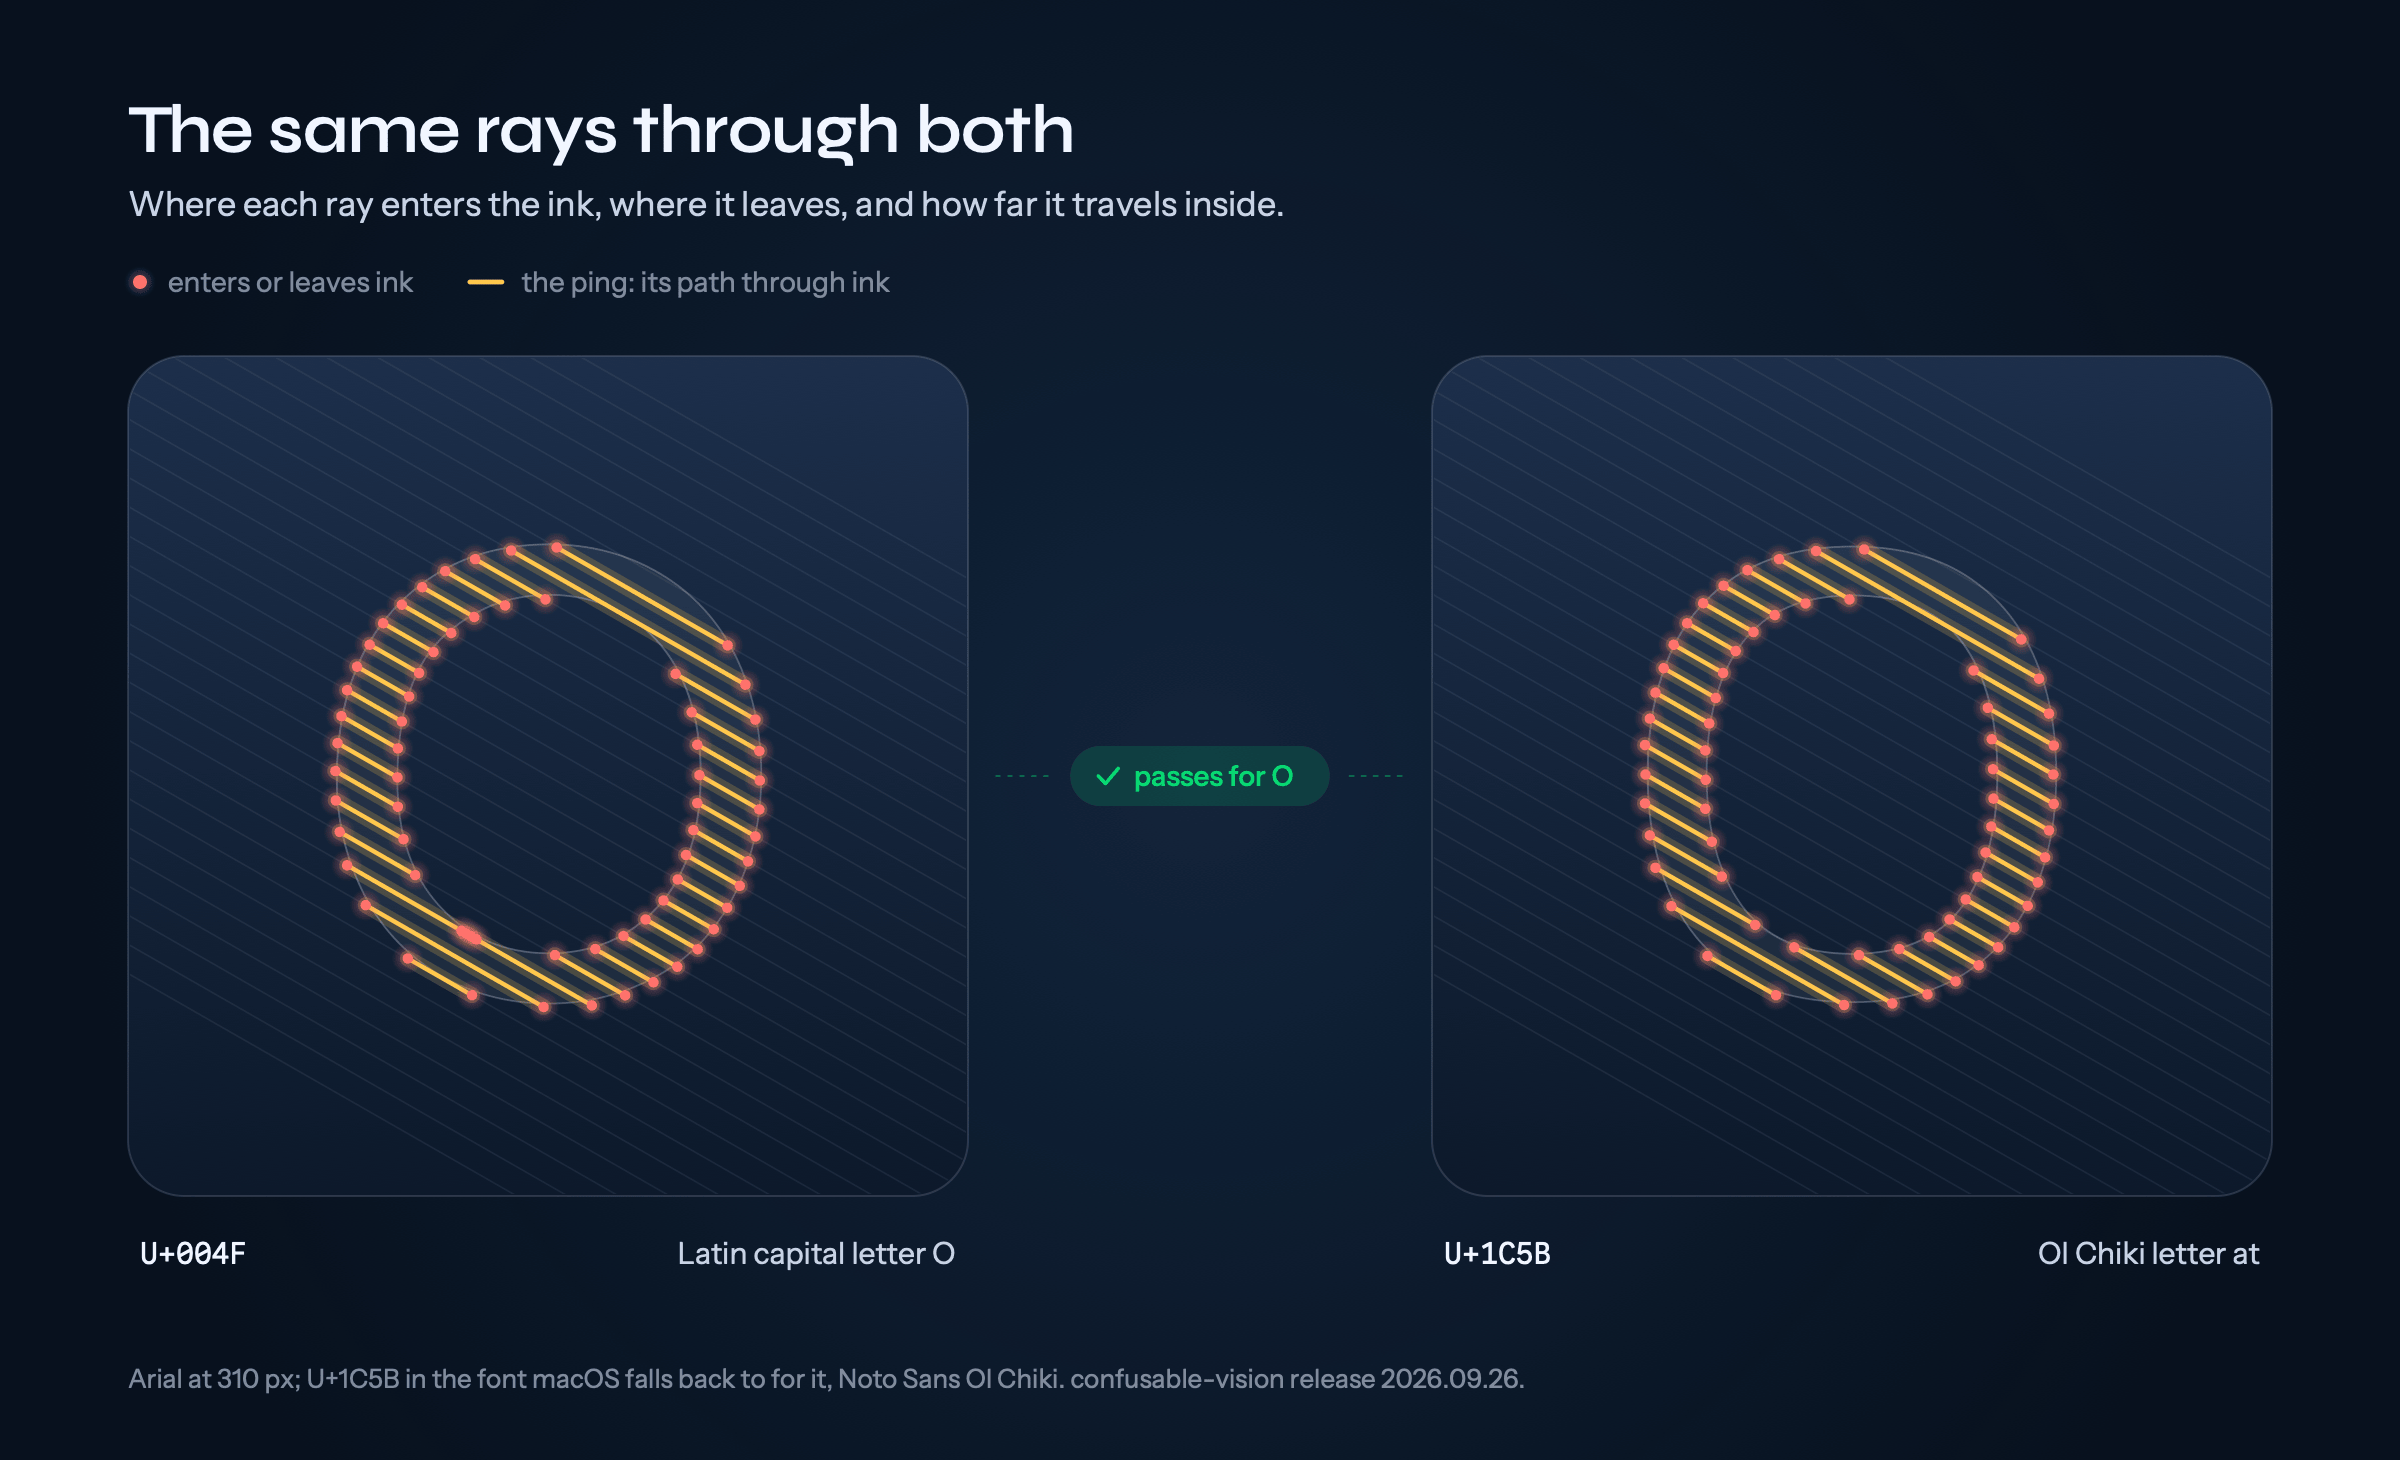
RaySpace proietta raggi paralleli attraverso il contorno di ogni glifo a 36 angoli, 50 raggi ciascuno, e registra cinque cose per raggio: quante volte attraversa il contorno, dove, con quale angolo, quanto viaggia attraverso l'inchiostro ogni volta (il suo ping, la larghezza del tratto lungo il raggio), e il divario più ampio tra i tratti. Ogni glifo è misurato due volte: nel proprio riquadro, per la forma, e in una cornice fissa sulla linea di base, così dimensione e posizione contano. Due caratteri sono simili in un font quando la distanza di forma è inferiore a 0,5 e la distanza ancorata alla linea di base inferiore a 0,2. Il confronto gira in Rust (native/cv-pairs), su ogni core.
- All'interno di un font: ogni coppia di lettere e cifre che il font disegna.
- Tra font: un carattere nel proprio font, come lo disegnerebbe il fallback di un browser, contro le 62 lettere e cifre ASCII di ciascuno dei 26 font di pagina che non lo hanno. Conta quando la lettera ASCII è la più vicina, e il carattere è vicino ad essa quanto quella lettera lo è a se stessa nel quartile superiore degli altri font di pagina.
- Sequenze: ogni carattere contro le 3.844 sequenze ASCII di due caratteri, come le compone ciascun font (Core Text; HarfBuzz le compone in modo identico a parte il tracking del font di sistema).
Verificare sul posto