
 js-lee-ai/refusal-relocates
Sicurezza degli LLM: analizza come il fine-tuning modifica il comportamento di rifiuto e valuta le difese basate su layer-freezing e low-rank.





Pagina del progetto · Avvio rapido · Utilizzo · CLI · Risultati · Riproduzione · FAQ · Citazione
Poche decine di esempi dannosi possono rimuovere il rifiuto di richieste dannose da parte di un modello allineato. Lavori precedenti localizzano la sicurezza in specifici livelli e direzioni, il che suggerisce di proteggere il punto individuato. Questo repository verifica tale premessa nel modo in cui lo farebbe un attaccante adattivo. Individua dove il rifiuto può essere recuperato, congela quella regione e attacca di nuovo, quindi ripara l'aggiornamento dei pesi e poi lascia che l'attaccante lo diffonda.
Lo studio si basa su tre misurazioni.
Questo repository contiene la misurazione ed entrambe le difese come piccola libreria, oltre ai registri delle esecuzioni e agli script che ricostruiscono le tabelle del paper.
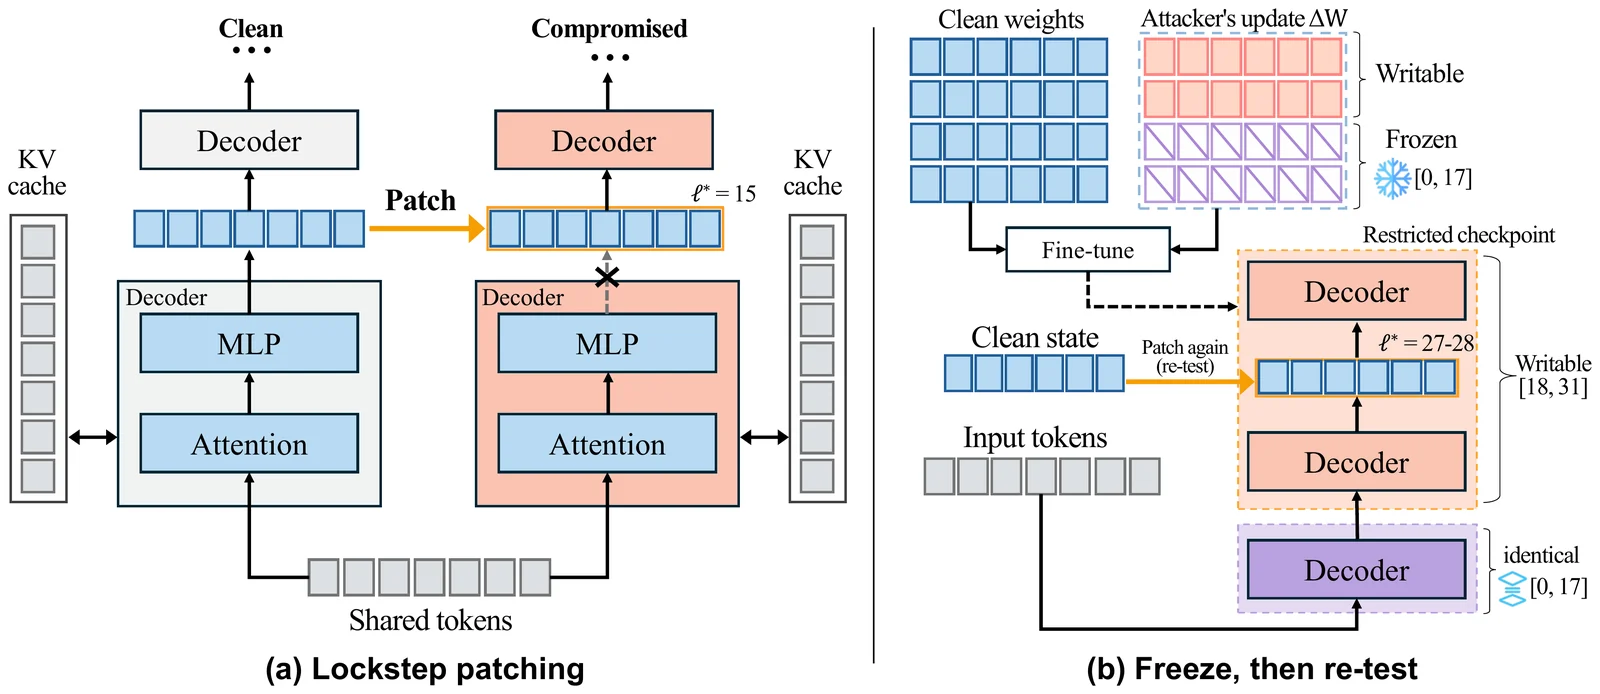
(a) Il lockstep activation patching sovrascrive l'output del livello del modello compromesso con lo stato pulito in prefill e a ogni passo di decoding. (b) Nell'attacco appaiato su Llama, congelare i livelli 0–17 sposta la transizione a metà del soffitto da 15 a 27–28.
pip install "git+https://github.com/js-lee-AI/refusal-relocates.git"
import numpy as np
import refusal

rng = np.random.default_rng(0)
A = rng.standard_normal((16, 512)) / 512 ** 0.5    # LoRA factors of one module, rank 16
B = rng.standard_normal((512, 16)) / 16 ** 0.5
for name, decay in [("ordinary", 0.5), ("spread", 1.0)]:
    b = B * decay ** np.arange(16)                  # energy in a few directions, or spread flat
    before, after = refusal.update_stats(A, b), refusal.update_stats(*refusal.remove_top_k(A, b, k=2))
    print(f"{name:8s}  PR/r {before['pr_over_r']:.2f}  top-2 energy {before['top2_energy_fraction']:.2f}"
          f"  norm left after top-2 removal {after['unscaled_norm'] / before['unscaled_norm']:.2f}")
# ordinary  PR/r 0.10  top-2 energy 0.94  norm left after top-2 removal 0.24
# spread    PR/r 0.94  top-2 energy 0.18  norm left after top-2 removal 0.90
Un fine-tuning ordinario concentra la maggior parte del proprio aggiornamento in poche direzioni singolari, quindi la rimozione delle prime due elimina la maggior parte di esso. Un aggiornamento distribuito ha uno spettro piatto, quindi la stessa rimozione ne lascia inalterata la maggior parte. PR/r, il rapporto di partecipazione rispetto al rango LoRA, è anche il punteggio del rilevatore spettrale del paper.
Questo viene eseguito su una CPU in circa un secondo e non scarica nulla. Lo stesso codice è in examples/quickstart.py, e la CI lo esegue a ogni push.
Per addestrare, applicare patch e valutare checkpoint reali, installa l'extra models.
pip install "refusal-relocates[models] @ git+https://github.com/js-lee-AI/refusal-relocates.git"
| install | aggiunge | sufficiente per |
|---|---|---|
pip install "git+https://github.com/js-lee-AI/refusal-relocates.git" | numpy | il nucleo spettrale, la rimozione top-k, il rilevatore, lo scorer di rifiuto, il comando refusal |
pip install "refusal-relocates[models] @ git+https://github.com/js-lee-AI/refusal-relocates.git" | torch, transformers, peft, accelerate, safetensors, scikit-learn, datasets | addestramento, patching lockstep, probe e valutazione su un modello |
git clone e poi pip install -e ".[models,test]" | pytest | experiments/, records/ e tests/ |
Testato con Python 3.11.5, PyTorch 2.10.0, Transformers 4.57.3 e PEFT 0.18.0. I modelli vengono caricati in bfloat16 su un dispositivo CUDA.
import refusal

data = refusal.load_data("data/prompt_sets.json")        # built by `refusal prepare`, see below
prompts = data["advbench"][:40]
clean, tokenizer = refusal.load_model("meta-llama/Llama-3.1-8B-Instruct")
attacked, _ = refusal.load_model("meta-llama/Llama-3.1-8B-Instruct", adapter="runs/attack/adapter")

for layer in [6, 9, 12, 15, 18]:
    responses = refusal.lockstep_generate(clean, attacked, tokenizer, prompts, layer=layer)
    print(layer, sum(refusal.is_refusal(r) for r in responses) / len(prompts))
Entrambi i modelli leggono gli stessi token e, al layer scelto, l'output del modello compromesso viene sostituito con quello del modello pulito. refusal patch esegue la misurazione completa con il suo floor, ceiling e due controlli, valuta il rifiuto coerente con il gate di perplessità e Llama-Guard, e riporta la profondità di transizione.
import refusal

