 decalage2/collisions
Collisioni di hash e i loro sfruttamenti

TL;DR ottenere una collisione MD5 di queste due immagini è ora(*) banale e istantaneo.
 ⟷
<a href=http://gunshowcomic.com/648>
Non giocare col fuoco, non fare affidamento su MD5.
(*) Collidere qualsiasi coppia di file è possibile da molti anni, ma richiede diverse ore ogni volta, senza scorciatoie.
Questa pagina fornisce trucchi specifici per i formati di file e prefissi di collisione precalcolati per rendere la collisione istantanea.
git clone. Esegui lo script. Fatto.
Di Ange Albertini e Marc Stevens.
L'obiettivo è esplorare a fondo gli attacchi esistenti - e mostrare strada facendo quanto sia debole MD5 (collisioni istantanee di qualsiasi JPG, PNG, PDF, MP4, PE...) - e anche esplorare in dettaglio i formati di file comuni per determinare come possano essere sfruttati con attacchi attuali o futuri.
Infatti, lo stesso trucco sui formati di file può essere usato su diversi hash (gli stessi trucchi JPG sono stati usati per MD5, malicious SHA-1 e SHA1), finché le collisioni seguono gli stessi pattern di byte.
Questo documento non riguarda nuovi attacchi (il più recente è stato documentato nel 2012), ma nuove forme di sfruttamento degli attacchi esistenti.
Stato attuale - a dicembre 2018 - degli attacchi noti:
ottenere un file che abbia l'hash di un altro file o un dato hash: impossibile
ottenere due file diversi con lo stesso MD5: istantaneo
far sì che due file arbitrari ottengano lo stesso MD5: poche ore (72 hours.core)
far sì che due file arbitrari di formati specifici (PNG, JPG, PE...) ottengano lo stesso MD5: istantaneo
ottenere due file diversi con lo stesso SHA1: 6500 years.core
(*) esempio con crypt - grazie Sven!```
import crypt crypt.crypt("5dUD&66", "br") 'brokenOz4KxMc' crypt.crypt("O!>',%$", "br") 'brokenOz4KxMc'
# Attacchi

MD5 e SHA1 operano su blocchi di 64 byte.

Se due contenuti A e B hanno lo stesso hash, allora aggiungendo lo stesso contenuto C a entrambi, l'hash rimarrà lo stesso.``` text
hash(A) = hash(B) -> hash(A + C) = hash(B + C)
Collisions work by inserting at a block boundary a number of computed collision blocks that depends on what came before in the file. These collision blocks are very random-looking with some minor differences (that follow a specific pattern for each attack) and they will introduce tiny differences while eventually getting hashes the same value after these blocks.
Queste differenze vengono sfruttate per creare file validi con proprietà specifiche.
Anche i formati di file funzionano dall'alto verso il basso, e la maggior parte di essi lavora per chunk a livello di byte.
Alcuni chunk 'commento' possono essere inseriti per allineare i chunk del file ai confini di blocco, per allineare strutture specifiche alle differenze dei blocchi di collisione, per nascondere ai parser del file la casualità residua dei blocchi di collisione, e per nascondere al parser contenuti altrimenti validi (così che ne veda altri).
Questi chunk 'commento' spesso non sono commenti ufficiali reali: sono usati solo come contenitori di dati ignorati dal parser (ad esempio, i chunk PNG con ID che inizia con una lettera minuscola sono ancillari, non critici).
La maggior parte delle volte, una differenza nei blocchi di collisione viene usata per modificare la lunghezza di un chunk di commento,
che in genere viene dichiarato subito prima dei dati di questo chunk:
nello spazio tra la versione più corta e quella più lunga di questo chunk,
viene dichiarato un altro chunk di commento per saltare il contenuto A di un file.
Dopo questo contenuto A, basta aggiungere un altro contenuto B.
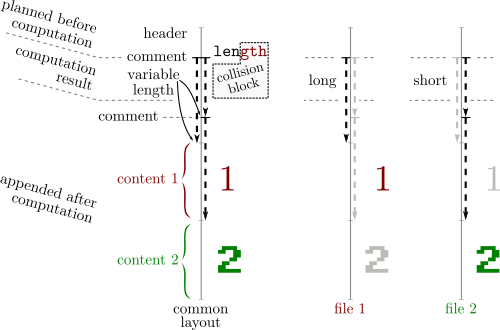
Poiché i formati di file di solito definiscono un terminatore che fa fermare i parser dopo di esso,
A terminerà il parsing, facendo sì che il contenuto aggiunto B venga ignorato.
Quindi in genere servono almeno due commenti - spesso tre:
