 d-diaa/swordstamp
Marcatura d'acqua semantica con rilevamento robusto all'ordine su unità sub-frasali

SwordStamp aggiunge unità di rilevamento robuste all'ordine e di span semantici ai watermark semantici basati su embedding. Questo artefatto contiene l'esatta configurazione del paper, il codice di generazione e rilevamento, la suite di attacchi invariata, la valutazione della qualità e l'estrazione deterministica dei risultati e la generazione dei grafici.
Paper: Semantic Watermarking with Order-Robust Detection over Sub-sentence Units (arXiv:2608.27666)
Con un tasso di falsi positivi del 5% e un requisito di conservazione del contenuto del 90%, l'attacco di spostamento dell'embedding specifico per schema (EDA-S) ottiene:
| Watermark | Tasso di successo dell'attacco EDA-S |
|---|---|
| SemStamp | 47.9% |
| k-SemStamp | 33.3% |
| PMark | 46.1% |
| SAMark | 32.6% |
| SwordStamp | 18.7% |
| k-SwordStamp | 10.8% |
Rispetto alle loro baseline pubblicate, SwordStamp e k-SwordStamp riducono il successo di EDA-S di 29.2 e 22.5 punti percentuali, con costi di fedeltà in condizioni pulite di 1.8 e 4.4 punti. I loro tassi di rilevamento in condizioni pulite sono 94.9% e 97.0%. Nel più forte stress test EDA-D con accesso al rilevatore, il successo massimo vincolato dalla qualità è del 39.7% su k-SwordStamp contro il 65.5% su k-SemStamp.
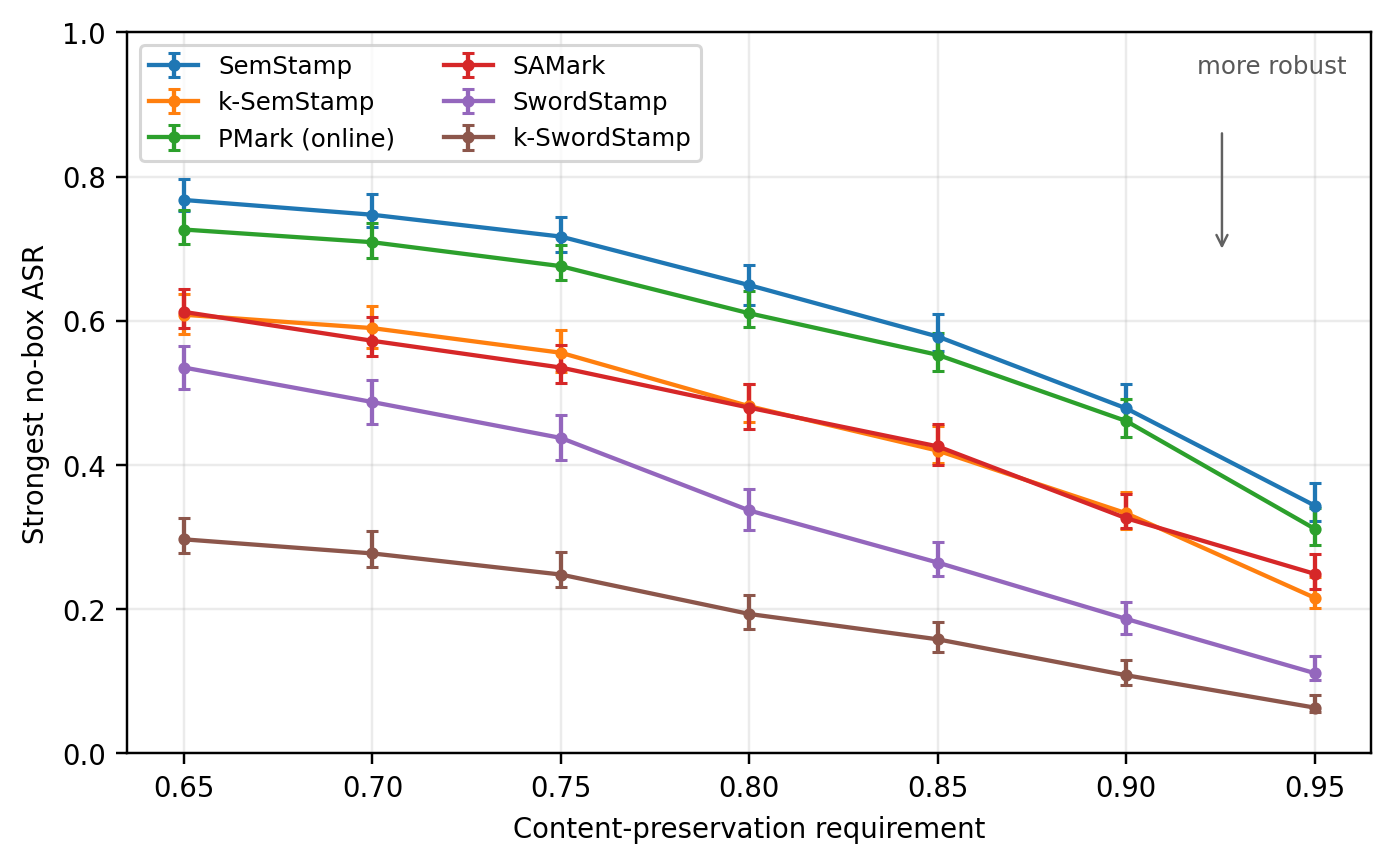
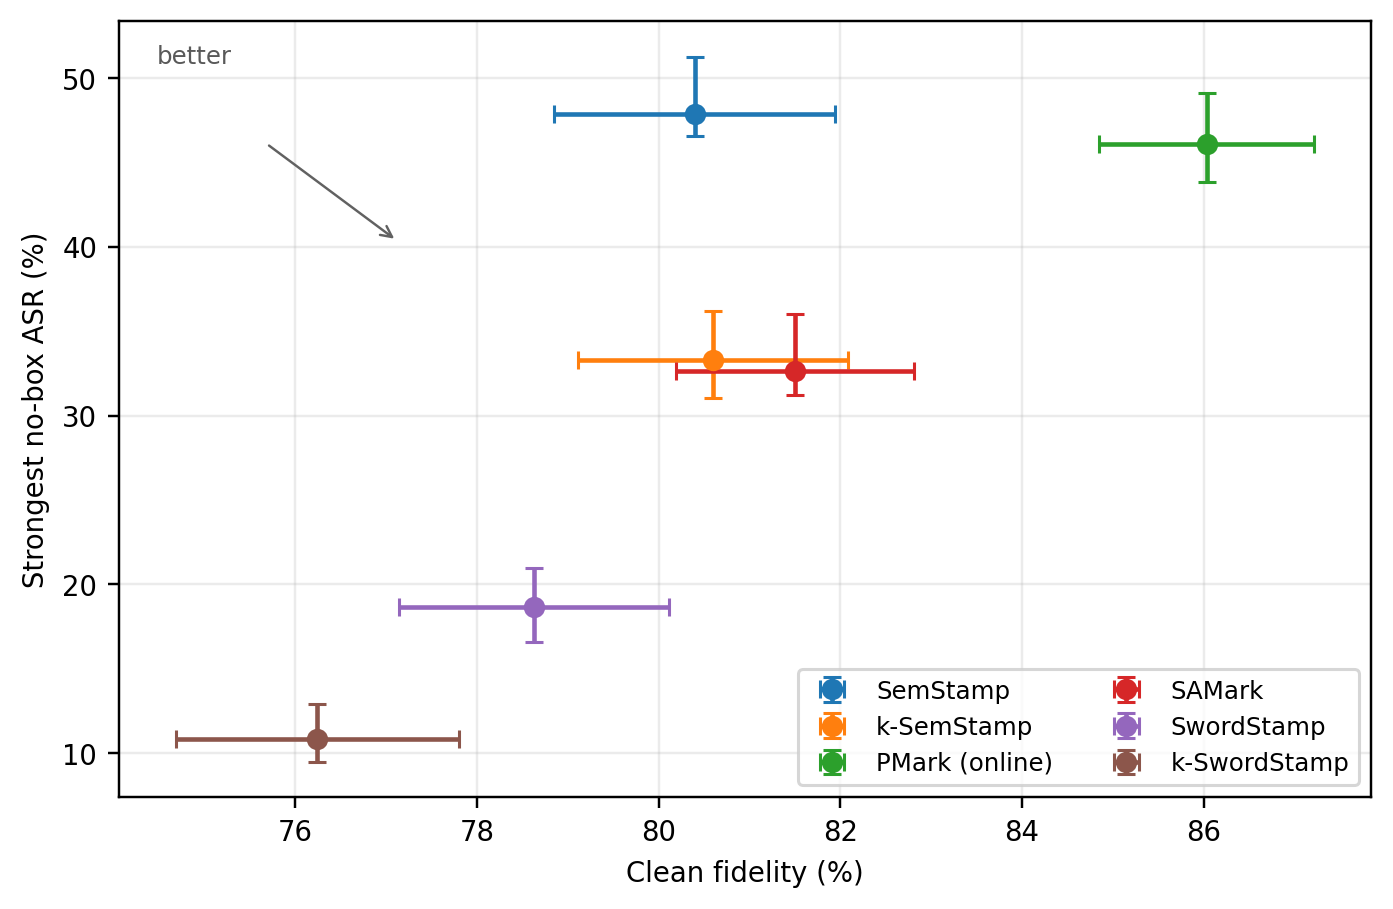
Questi risultati coprono continuazioni di notizie in inglese, un modello provider, due encoder provider e una coppia parafrasatore/surrogato EDA.
visualization consuma solo il bundle compilato CSV/Parquet. Fallisce in caso di celle del paper mancanti anziché disegnare una figura parziale.
uv sync --frozen --only-group plot --no-install-project
uv run --no-sync python -m visualization extract \
  --bundle results/paper --output results/paper
uv run --no-sync python -m visualization render \
  --bundle results/paper --output results/paper
Questo scrive tabelle verificabili in results/paper/tables/ e sette figure in
PNG e PDF in results/paper/figures/. Il ramo di revisione anonima include
il bundle compilato; un'esecuzione completa sul ramo di rilascio crea gli stessi file
con python -m visualization compile.
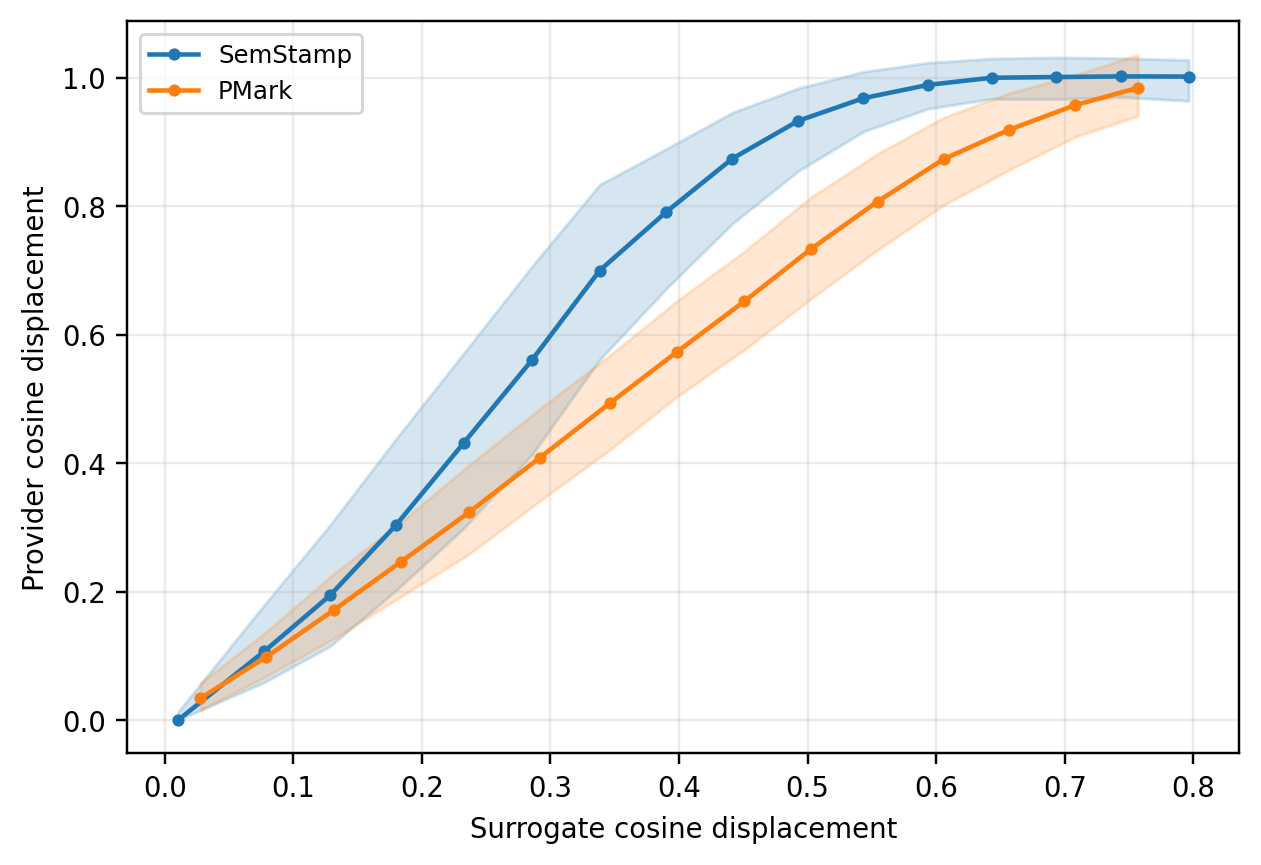
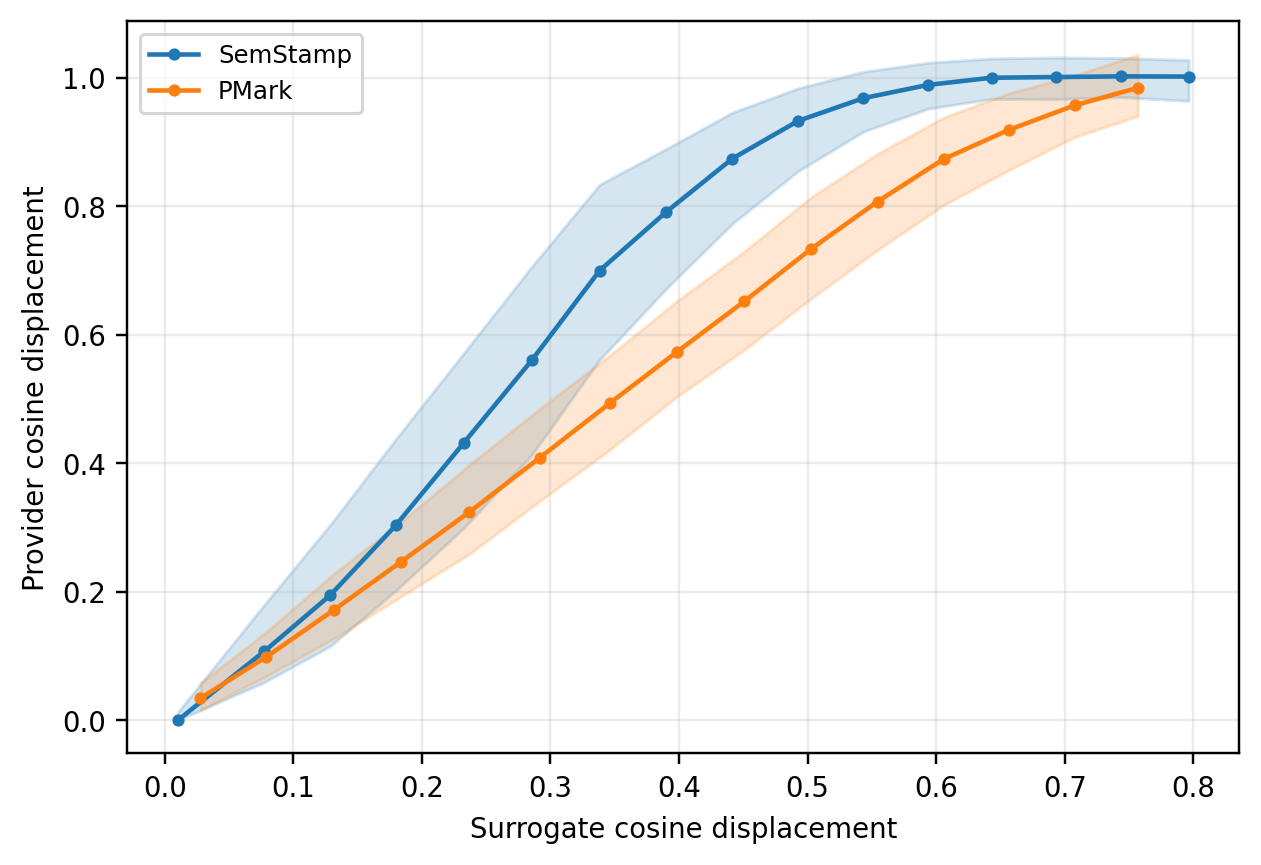
L'attacco di spostamento dell'embedding (EDA) è un attacco adattivo di parafrasi dell'intero testo. A ogni unità di output
campiona K continuazioni e mantiene il candidato con il maggiore spostamento
coseno dal suo ancoraggio di origine sotto un encoder surrogato. Poiché ogni
candidato continua il prefisso di riscrittura completo, un unico obiettivo può riformulare il contenuto,
riordinarlo e dividere o unire le unità del rilevatore.
EDA no-box vede il testo marcato e il design pubblico della filigrana. Non interroga il rilevatore o il generatore e non riceve alcuna chiave segreta, encoder del provider, o oracolo di qualità.
| Variante | Ancoraggio e unità | Configurazione |
|---|---|---|
| EDA-P | frase posizionale | adaptive, anchor=positional, unità dell'attaccante sentence |
| EDA-S | design pubblico del target | frasi posizionali per SemStamp, k-SemStamp e PMark; bag/sentence per SAMark; bag/semspan per entrambe le varianti di SwordStamp |
| EDA-D | rilevatore del provider | oracle; eredita l'encoder, la partizione e la segmentazione del difensore |
Per l'ancoraggio bag, il paper usa attack.bag_agg=min: massimizza la distanza dal
più vicino ancoraggio di origine. Le esecuzioni no-box riportate usano
Qwen/Qwen2.5-3B-Instruct, BAAI/bge-base-en-v1.5,
K={1,2,4,8,16,32,64}, temperatura 1.0, top-p 0.95, al massimo 96 token per
candidato e al massimo 512 token di riscrittura.
Altri progettisti di filigrana possono chiamare EDA direttamente:
from attacks.paraphrasing.adaptive import adaptive_attack_paraphrase

attacked = adaptive_attack_paraphrase(
    texts,
    base_model="Qwen/Qwen2.5-3B-Instruct",
    surrogate_model="BAAI/bge-base-en-v1.5",
    num_candidates=32,
    anchor="positional",       # EDA-P; use "bag" for an order-robust design
    bag_agg="min",
    segmentation_type="sentence",
    segmentation_backend="nltk",
)
Per l'EDA-S di SwordStamp descritto nel paper, impostare anchor="bag",
segmentation_type="semspan", semcut_max_words=15 e
semcut_window=5. All'interno di questo repository la CLI equivalente è:
uv run python -m attacks DATA_PATH --config PRESET \
  --set attack.paraphraser=adaptive \
  --set attack.custom_model=Qwen/Qwen2.5-3B-Instruct \
  --set attack.surrogate_model=BAAI/bge-base-en-v1.5 \
  --set attack.num_candidates=32 \
  --set attack.anchor=bag --set attack.bag_agg=min \
  --set segmentation.attacker_type=semspan \
  --set segmentation.attacker_backend=nltk
DATA_PATH è sempre il corpus di base e PRESET identifica la cella con watermark. Consultare attacks/README.md per tutti gli attacchi mantenuti e i campi di configurazione.
config/paper.py è l'unica fonte di verità. Per ciascuno di LSH e k-means,
scripts/experiments/swordstamp.sh esegue questa scala additiva a cinque livelli con 64
candidati provider:
La griglia contiene solo queste dieci celle e una baseline senza watermark. PMark è
solo online; SAMark usa un pattern di flag per esecuzione. I budget EDA-D sono
K={4,8,16,32,64}.
I sottomoduli di confronto adattano le fonti di valutazione pubbliche PMark e SAMark solo ai loro confini di dataset/risultati e alla calibrazione condivisa dei falsi positivi; gli algoritmi di watermarking sono invariati.
I prerequisiti sono Git, uv, Python 3.11, CUDA per esecuzioni del modello, accesso alle revisioni dei modelli fissate e storage temporaneo.
git clone --recurse-submodules [email protected]:D-Diaa/SwordStamp.git
cd SwordStamp
bash scripts/setup.sh
uv run --frozen python scripts/check_artifact.py
Preparare le partizioni C4 deterministiche e disgiunte:
uv run --frozen python scripts/prepare_c4.py --output-dir data
Installa e configura lo scheduler bloccato alla versione specificata. L'installer stampa i suoi effetti collaterali a livello utente prima di modificare qualsiasi cosa:
bash scripts/install_gpu_scheduler.sh --print-plan
bash scripts/install_gpu_scheduler.sh --yes
gpu-scheduler init --gpus 0,1
gpu-scheduler start
Visualizza l'anteprima, poi invia ogni shard fisico:
