amruth-sn/kong
Il primo reverse engineer agentico al mondo.

Orchestrazione LLM per il reverse engineering di binari
La maggior parte delle attività segue una relazione lineare: più un compito è difficile, più tempo richiede solitamente. Il reverse engineering (e l'analisi binaria) è un'attività in cui la difficoltà reale è piuttosto banale, ma il tempo di esecuzione può essere dell'ordine di ore (e giorni!), anche per un binario con un paio di centinaia di funzioni.
Kong automatizza lo strato meccanico, utilizzando un framework di reverse engineering di livello NSA. Kong può prendere un binario completamente offuscato e stripped ed eseguire una pipeline di analisi completa: triage delle funzioni, costruzione del contesto del grafo delle chiamate, recupero di tipi e simboli tramite decompilazione guidata da LLM, e scrittura dei risultati nel database del programma di Ghidra. L'output è un binario in cui alcuni FUN_00401a30 diventano parse_http_header, con struct, nomi di parametri e convenzioni di chiamata recuperati.
Perché esiste
I binari stripped perdono tutto il contesto che rende il codice leggibile: nomi di funzioni, informazioni sui tipi, nomi di variabili, layout delle struct. Recuperare quel contesto è la maggior parte del lavoro nella maggior parte delle attività di RE, ed è in gran parte pattern matching: riconoscere funzioni della libreria standard, inferire tipi dall'uso, propagare nomi attraverso i grafi delle chiamate.
Gli LLM sono bravi esattamente in questo tipo di pattern matching. Ma puntare un LLM verso l'output grezzo del decompilatore e chiedere "cosa fa questo?" dà risultati mediocri. Al modello mancano il contesto delle chiamate, le informazioni sui riferimenti incrociati e il quadro più ampio di come è strutturato il binario. Inoltre, la maggior parte dei binari offuscati introduce tecniche estreme per prevenire il reverse engineering.
Kong risolve questo costruendo ricche finestre di contesto dall'analisi del programma di Ghidra (grafi delle chiamate, riferimenti incrociati, riferimenti a stringhe, flusso dei dati) prima ancora di toccare l'LLM, quindi orchestra l'analisi in ordine di dipendenza in modo che ogni funzione benefici del fatto che i suoi chiamati siano già nominati. Inoltre, Kong introduce la propria pipeline di deoffuscamento agentico, la prima nel suo genere.
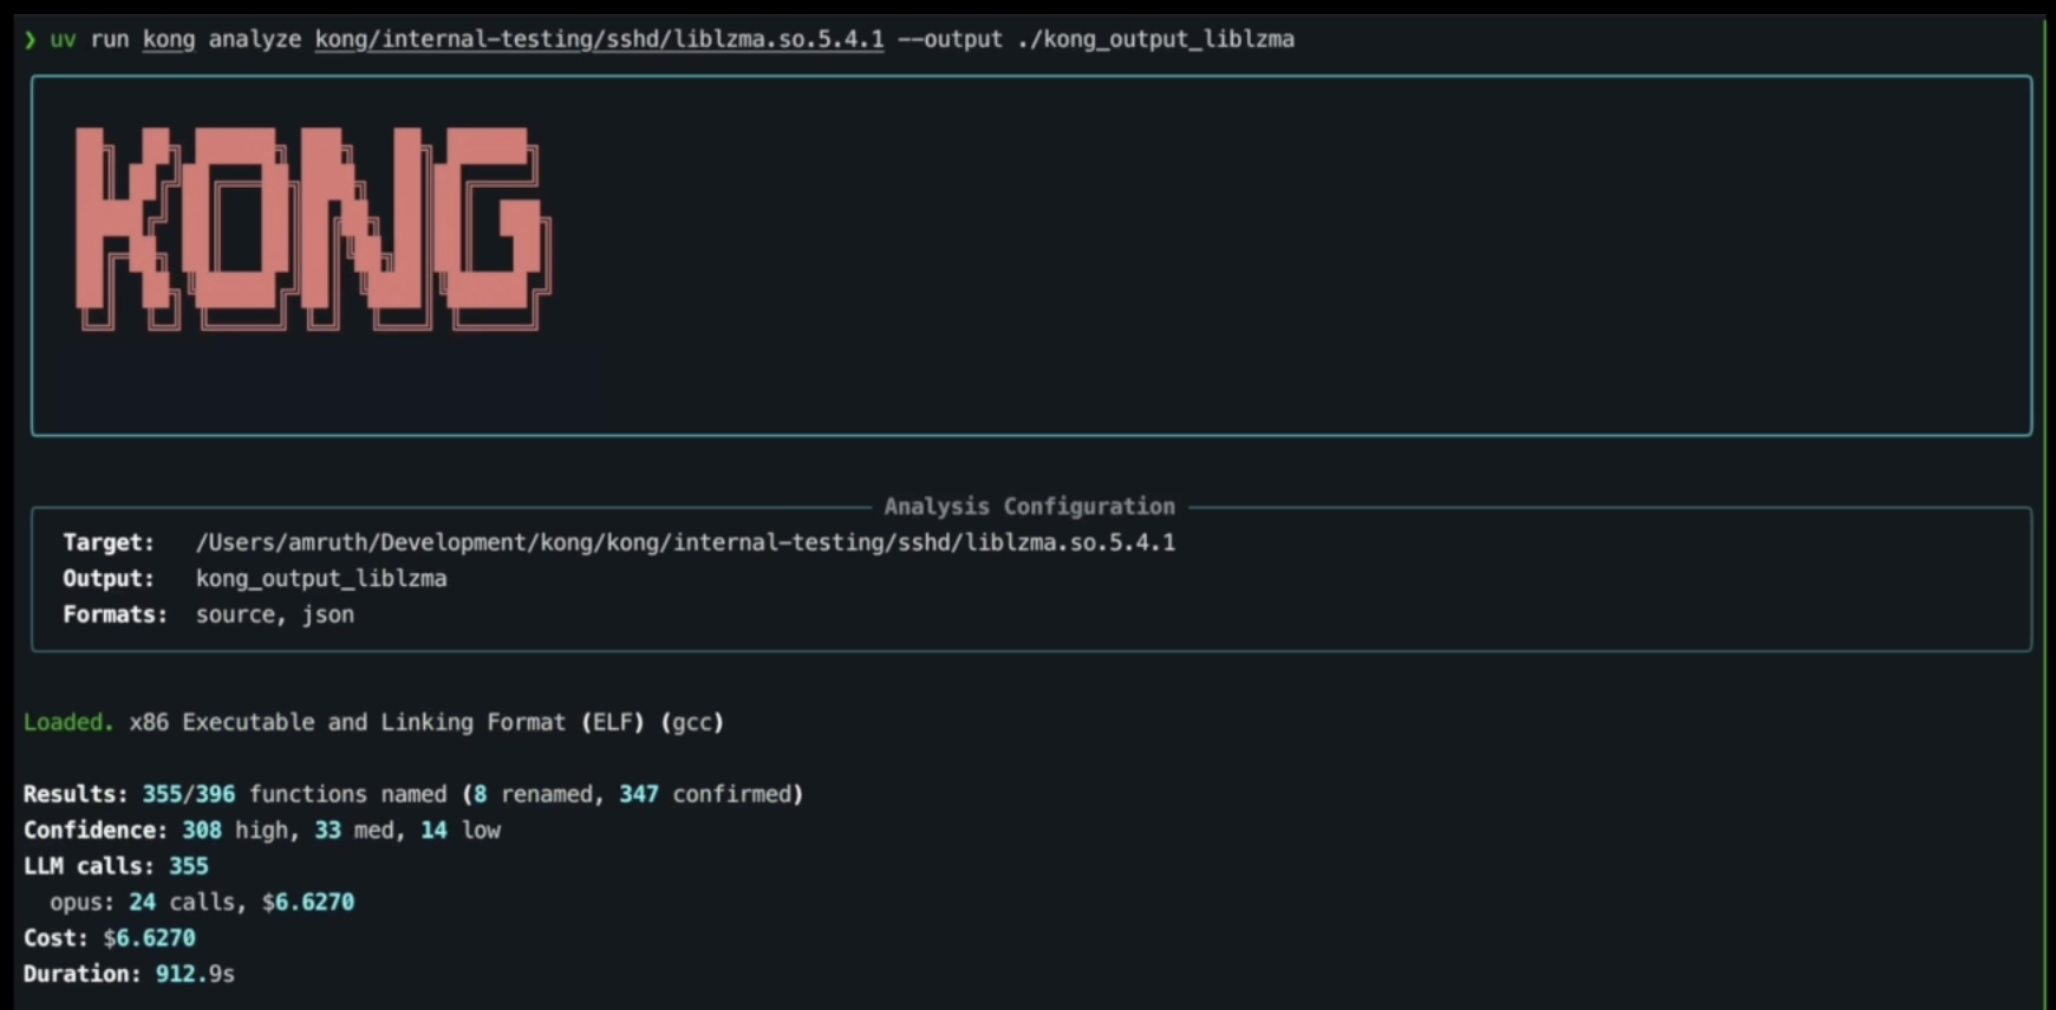
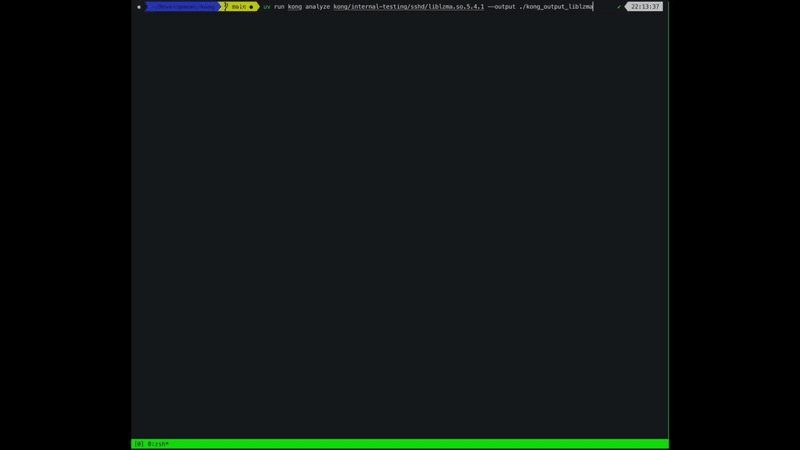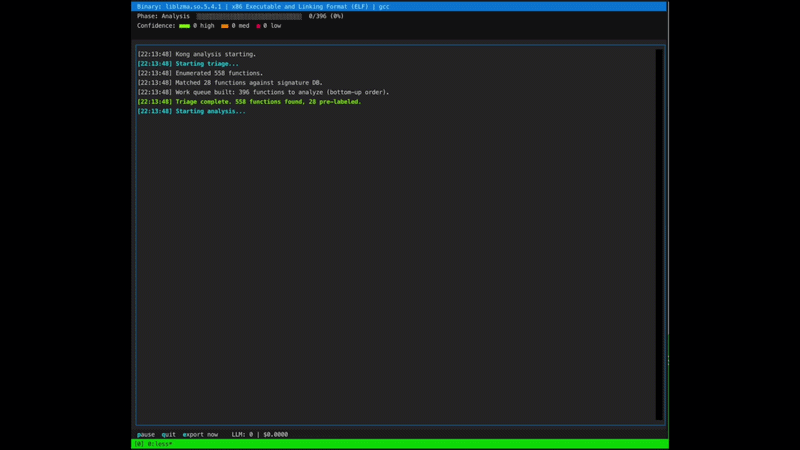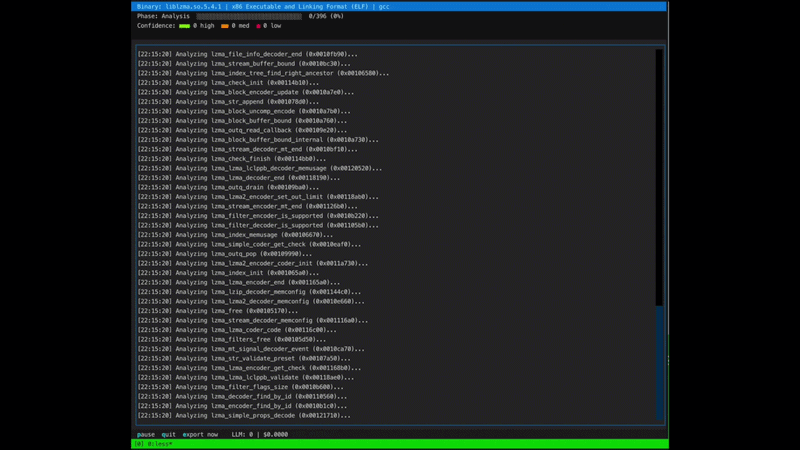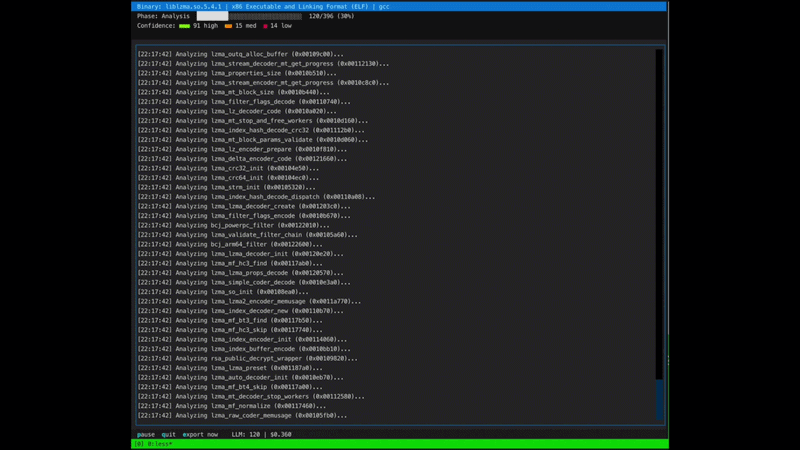
Kong funziona con la maggior parte dei binari decompiabili da Ghidra (per ora, altri in arrivo).
| C | C++ | Go | Rust | |
|---|---|---|---|---|
| x86 | Alta | Alta | Media | Media |
| x86-64 | Alta | Alta | Media | Media |
| ARM (32-bit) | Alta | Alta | Media | Bassa |
| AArch64 | Alta | Alta | Media | Bassa |
| MIPS | Media | Media | Bassa | Bassa |
| PowerPC | Media | Media | Bassa | Bassa |
Alta: Kong decompila, deoffusca e recupera in modo affidabile nomi, tipi e struttura.
Media: La decompilazione è utilizzabile ma più rumorosa. Ci si aspetta un recupero parziale e punteggi di confidenza inferiori.
Bassa: La decompilazione presenta lacune significative e i risultati rimarranno incompleti, rumorosi o illeggibili.
Nota: La dimensione del binario scala positivamente con il numero di funzioni, il costo dell'LLM e il tempo di completamento. Tuttavia, la dimensione del binario scala anche negativamente con la confidenza, quindi tienilo a mente quando analizzi binari più grandi.
Kong utilizza una pipeline a cinque fasi orchestrata da un supervisore che coordina triage, analisi parallela e post-elaborazione: