
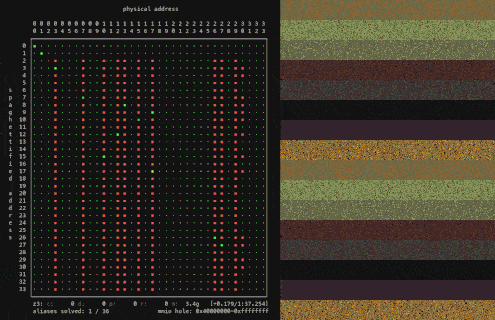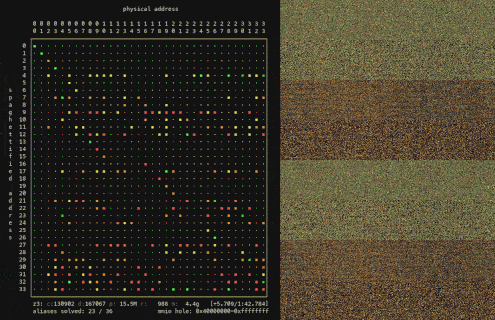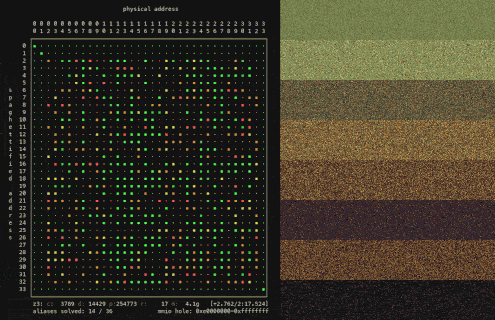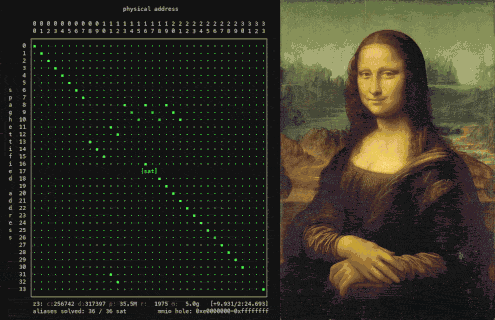
skitter-creek-bath-salts — Updated!
Sbloccare _tutto_ sulla CPU con il DRAM scrambling
skitter-creek-bath-salts
Sbloccare tutto sulla CPU con lo scrambling della DRAM — PSP, C6, microcodice, SMM e qualsiasi altra cosa che le specifiche hanno omesso.
&x == &x.
Di solito.
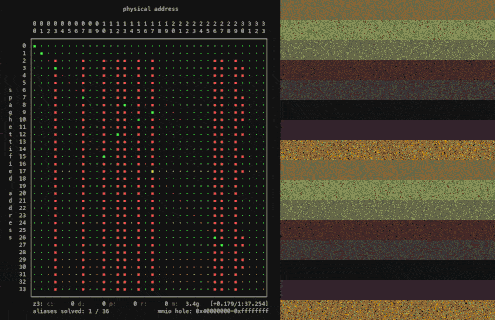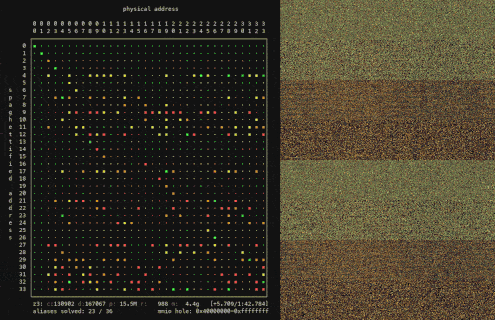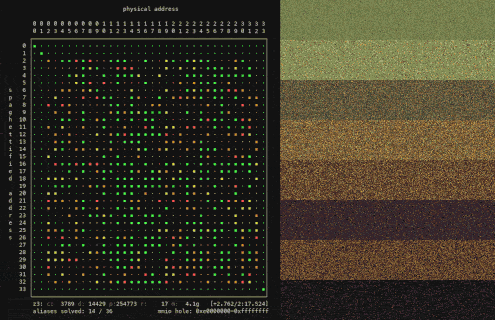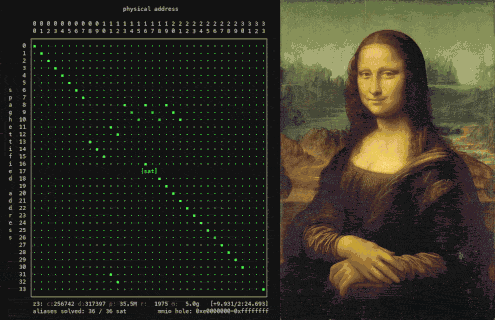
Basta modificare il controller DRAM e un indirizzo può essere fatto atterrare ovunque tu voglia in
memoria. skitter-creek-bath-salts modifica gli strati inferiori della gerarchia di memoria
per ricablare le traduzioni degli indirizzi DRAM fisici. Questo rimescola
la memoria della piattaforma, esponendo regioni protette della DRAM — carveout invisibili persino
al kernel. Quando le traduzioni degli indirizzi si rompono, si rompono anche le primitive di sicurezza
costruite su di esse, e sblocchiamo tutto.
TL;DR
- Sblocca il tuo Platform Security Processor
- Sblocca la System Management Mode
- Sblocca la DRAM C6
- Sblocca il microcodice della tua CPU
Target
Sviluppato e testato su CPU AMD Family 16h, l'ultima generazione i cui
datasheet documentano i registri di traduzione del controller DRAM — e mostrano che
non possono essere bloccati. La 17h e oltre semplicemente omettono questa informazione. L'
odissea di *p è simile tra generazioni e
architetture, e le trasformazioni sottostanti si estendono persino ad ARM, RISC-V e
oltre; skitter-creek-bath-salts ci mostra solo come iniziare.
L'odissea di *p
È una lunga discesa.
La memoria è costruita su strati di astrazione così profondi da diventare quasi assurdi. Quando
il tuo codice dereferenzia *p, sembra accedere alla DRAM all'indirizzo p. Non lo fa —
p è un indirizzo virtuale, e prima che un singolo bit di DRAM venga toccato, deve
sopravvivere al calvario sottostante:```
── CPU core / MMU ─────────────────────────────────────────────────
┌─ VA ← 64-bit virtual address from load/store
│
└> canonical-form check ──────────────────────┐ ← bits [63:48] sign-extend from bit 47
┌─ segment base add <─────────────────────────┘ ← FS.base / GS.base (MSR_FS_BASE, MSR_GS_BASE)
│
└> TLB probe ─────────────────────────────────┐ ← tagged by PCID (host) / VPID (guest)
hit → physical address k │
miss → engage hardware page walker │
┌─ page walk (from CR3) <─────────────────────┘ ← walked only on TLB miss
│ PML5[VA 56:48] ← only if CR4.LA57
│ PML4[VA 47:39]
│ PDPT[VA 38:30] ← 1 GiB leaf possible
│ PD [VA 29:21] ← 2 MiB leaf possible
│ PT [VA 20:12]
│ PTE ← R/W · U/S · NX · A/D · PAT · PCD · PWT · G
│
└> per-level checks ──────────────────────────┐ ← evaluated at every level of the walk
privilege (U/S) │ ← CPL vs PTE.U/S
write (R/W) │ ← + CR0.WP
execute (NX) │ ← EFER.NXE
SMEP / SMAP │ ← CR4.SMEP · CR4.SMAP · EFLAGS.AC
protection keys │ ← PKRU (user) · IA32_PKRS (supervisor)
┌─ A/D bit update <───────────────────────────┘ ← locked RMW on PTE
│
└> if guest: EPT / NPT re-walk ───────────────┐ ← each guest-PA above re-walked
EPT-PML4 → EPT-PDPT → EPT-PD → EPT-PT │ ← + EPT memory-type override
⇒ ~5× walks per single guest walk │
┌─ TLB shootdown IPIs <───────────────────────┘ ← invlpg broadcast to peer vCPUs
│
│ ── IOMMU (chipset / I/O fabric) ──────────────────────────────────
│
└> if device-initiated, IOMMU page walk ──────┐ ← VT-d / AMD-Vi: device-ID → domain → tables
│
┌── physical address k <─────────────────┘
│
│ ── CPU core / MMU — memory-type resolution ────────────────────────
│
└> MTRR range match ──────────────────────────┐ ← IA32_MTRR_DEF_TYPE + fixed/variable MTRRs
┌─ PAT entry select <─────────────────────────┘ ← IA32_PAT[ PTE.PAT:PCD:PWT ]
│
└> effective memory type ─────────────────────┐ ← { WB, WT, WC, WP, UC-, UC }
│
── CPU uncore — caches & coherence ────────────────────────────────
│
┌─ L1-D probe <───────────────────────────────┘ ← VIPT, per-core
│
└> L2 probe ──────────────────────────────────┐ ← per-core / per-CCX
┌─ LLC probe + directory consult <────────────┘ ← shared, sliced
│
└> snoop / coherence ─────────────────────────┐ ← MESI / MOESI broadcast
intra-socket │ ← broadcast to peer cores
inter-socket │ ← QPI · UPI · Infinity Fabric · CXL.cache
home-node directory response │ ← data | intervention | abort
│
── system data fabric / interconnect ──────────────────────────────
│
┌─ if MMIO range or sub-4 GiB MMIO hole <─────┘ ← uncore/data fabric posted/non-posted txn
│ → device BAR; done
│
└> else DRAM-bound: data fabric / mesh ───────┐ ← AMD DF · Intel mesh-or-ring uncore
│
┏━━ ── MCT / IMC (memory controller) ────────────────────────────────
W ┃ ┌─ DRAM hole remap <──────────────────────────┘ ← high-memory remap above TOM
E ┃ │
┃ └> memory-region exclusion remap ─────────────┐ ← reserved / protected ranges
┃ ┌─ channel interleave hash <──────────────────┘ ← XOR of selected PA bits → channel
A ┃ │
R ┃ └> rank interleave hash ──────────────────────┐ ← XOR of selected PA bits → rank
E ┃ ┌─ bank interleave hash <─────────────────────┘ ← XOR of selected PA bits → bank
┃ │
┃ └> bank swizzle / XOR scramble ───────────────┐ ← vendor- and BIOS-configurable
H ┃ ┌─ chip-select normalize (DCT) <──────────────┘ ← per-rank CS line
E ┃ │ rank → CS map
R ┃ │
E ┃ └> sub-channel select ────────────────────────┐ ← DDR5 / LPDDR5 only
┗━━ │
│
DRAM coordinates <─────────────────────────┘ ← bank group · bank · row (RAS) · column (CAS)
Questo progetto opera ai livelli più profondi della pipeline `*p`, lo strato MCT/DCT
— dove un indirizzo fisico proveniente dal data fabric/interconnect entra nel memory
controller e viene riscritto un'ultima volta nelle coordinate DRAM grezze che vengono
inviate al DIMM.

---

## Spaghettificare la DRAM

> Gli indirizzi fisici sono in realtà più che altro un suggerimento.```nasm
xor dword [0xf80c2094], 0x00400000
Questo è l'exploit. Tutto quanto.