
 seclog-open/seclog
विभिन्न स्रोतों से सुरक्षा लॉग एकत्र करता है, पुनरुत्पादनीय Docker आक्रमण परिदृश्यों से, आक्रमण श्रृंखलाओं का निर्माण करता है, और LLM आक्रमण-चरण तर्क के मूल्यांकन के लिए SecLog-Bench-216 बेंचमार्क प्रदान करता है।

SecLog बहु-स्रोत सुरक्षा लॉग से आक्रमण-चरण तर्क (attack-stage reasoning) पर अनुसंधान का समर्थन करता है। यह पुनरुत्पादनीय Docker आक्रमण और सामान्य-गतिविधि परिदृश्यों से लॉग एकत्र करने, साक्ष्य को आक्रमण श्रृंखलाओं में व्यवस्थित करने, लेबल किए गए डेटासेट बनाने और मॉडल पूर्वानुमानों का मूल्यांकन करने के लिए उपकरण प्रदान करता है।
इस रिलीज़ में SecLog-Bench-216 शामिल है, जो 216 साक्ष्य विंडो का एक तैयार-उपयोग बेंचमार्क है, जिसमें समीक्षित चरण लेबल और संदर्भ तर्क श्रृंखलाएँ हैं। शोधकर्ता दिए गए बेंचमार्क का सीधे उपयोग कर सकते हैं या नया डेटा उत्पन्न करने के लिए निर्माण पाइपलाइन चला सकते हैं।
पेपर: SecLog-Bench: A Scalable Benchmark for Cybersecurity Log Reasoning with Scaffolded Evidence।
Zenodo पर निर्माण संसाधन: Docker इमेज, कच्चे लॉग और संरेखण सूचकांक, और निर्मित आक्रमण श्रृंखलाएँ।
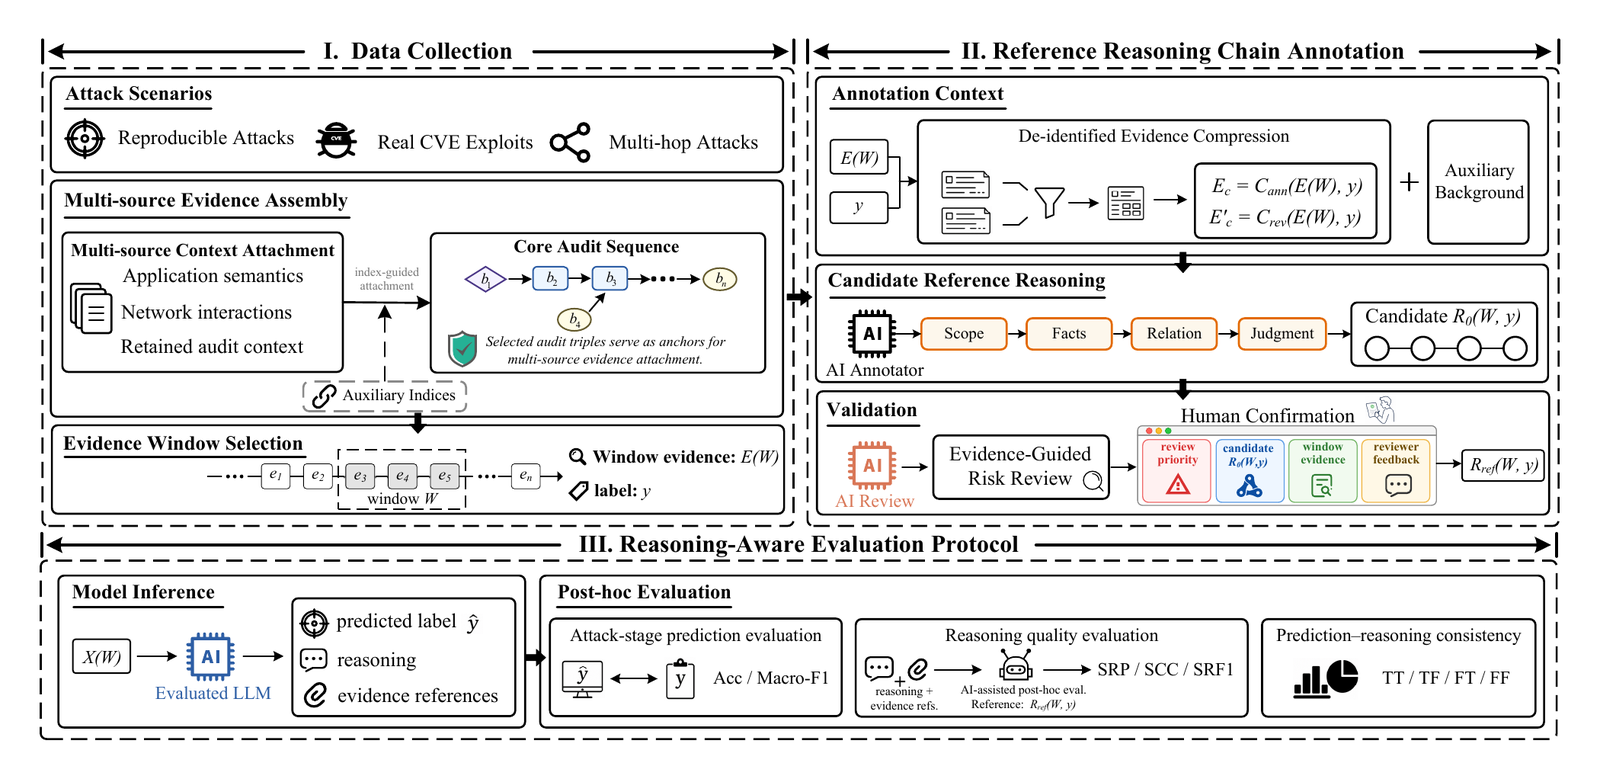
चित्र 1. SecLog का अवलोकन। भाग I चरण 01–04 से मेल खाता है, भाग II 05 में एनोटेशन और समीक्षा वर्कफ़्लो से, और भाग III 05 में SecLog-Bench-216 के साथ मूल्यांकन वर्कफ़्लो से।
| आपका लक्ष्य | यहाँ से शुरू करें | वातावरण |
|---|---|---|
| दिए गए डेटासेट को पढ़ें या पुनः उपयोग करें | SecLog-Bench-216 और डेटा उदाहरण | कोई भी JSONL रीडर; वैलिडेटर के लिए Python 3.11 |
| दिए गए बेंचमार्क पर किसी मॉडल का मूल्यांकन करें | त्वरित शुरुआत | Python 3.11; बंडल किए गए इन्फ़रेंस रनर के लिए एक API एंडपॉइंट और कुंजी |
| नए लॉग एकत्र करें और डेटासेट या बेंचमार्क बनाएँ | डेटा निर्माण | Ubuntu Linux, Python 3.11, Poetry, Docker, और कैप्चर उपकरण |
विस्तृत सिस्टम पैकेज, वैकल्पिक घटक और निर्भरता संस्करण ENVIRONMENT_DEPENDENCIES.md में सूचीबद्ध हैं।
ये कमांड Bash का उपयोग करते हैं और प्रोजेक्ट रूट से चलते हैं। एक पृथक Python 3.11 वातावरण से शुरू करें:
python3.11 -m venv ../seclog-env
source ../seclog-env/bin/activate
नीचे दिए गए कमांड Python मानक लाइब्रेरी का उपयोग करते हैं। लॉग संग्रह, एनोटेशन, समीक्षा UI, और अतिरिक्त विश्लेषण के लिए, पर्यावरण गाइड देखें।
python 05_benchmark_annotation_review_evaluation/scripts/validate_public_benchmark.py
वैलिडेटर नमूना गणना, ID, लेबल वितरण, साक्ष्य संदर्भ और मैनिफ़ेस्ट हैश की जाँच करता है। सफल सत्यापन अपने JSON आउटपुट में validation_passed: true और sample_count: 216 की रिपोर्ट करता है।
your-model-name को उस मॉडल पहचानकर्ता से बदलें जो आपके प्रदाता द्वारा समर्थित है:
python 05_benchmark_annotation_review_evaluation/evaluation/run_benchmark_inference.py \
  --prompt-pack SecLog-Bench-216/data/prompt_pack.jsonl \
  --model your-model-name \
  --output ../seclog-runs/example/raw_responses.jsonl
यह कमांड mode: preflight_no_api और प्रॉम्प्ट संख्या की रिपोर्ट करता है। यह
प्रदाता से संपर्क नहीं करता और न ही कोई प्रतिक्रिया फ़ाइल बनाता है, और यह यह
सत्यापित नहीं करता कि प्रदाता चयनित मॉडल का समर्थन करता है।
अपने शेल वातावरण में OPENAI_API_KEY सेट करें, नीचे दिए गए प्लेसहोल्डर को
अपनी प्रदाता कुंजी से बदलें, फिर स्पष्ट रूप से API कॉल सक्षम करें:
export OPENAI_API_KEY="YOUR_API_KEY"
python 05_benchmark_annotation_review_evaluation/evaluation/run_benchmark_inference.py \
  --prompt-pack SecLog-Bench-216/data/prompt_pack.jsonl \
  --model your-model-name \
  --output ../seclog-runs/example/raw_responses.jsonl \
  --call-api
रनर OpenAI-संगत चैट एंडपॉइंट का उपयोग करता है। इसका डिफ़ॉल्ट बेस URL
https://api.openai.com/v1 है; किसी अन्य एंडपॉइंट के लिए --base-url और
किसी अन्य कुंजी-चर नाम के लिए --api-key-env पास करें। आउटपुट निर्देशिका को
रिलीज़ ट्री के बाहर रखें, जैसा इस उदाहरण में है। प्रत्येक रन के लिए एक नया
आउटपुट पथ उपयोग करें, या किसी मौजूदा प्रतिक्रिया फ़ाइल को जारी रखने के लिए
--resume जोड़ें।
अपने स्वयं के अनुमान सिस्टम का उपयोग करने के लिए, जिनमें वे मॉडल भी शामिल हैं जो
temperature, max_tokens, या JSON मोड को अस्वीकार करते हैं, SecLog-Bench-216/data/prompt_pack.jsonl और
prediction format का उपयोग करें, फिर
कच्चे आउटपुट को नीचे दिए गए नॉर्मलाइज़र को पास करें।
python 05_benchmark_annotation_review_evaluation/evaluation/normalize_stage_reasoning_predictions.py \
  --input ../seclog-runs/example/raw_responses.jsonl \
  --output ../seclog-runs/example/predictions.jsonl

python 05_benchmark_annotation_review_evaluation/evaluation/evaluate_stage_reasoning_predictions.py \
  --gold SecLog-Bench-216/data/gold_labels.jsonl \
  --reference-chains SecLog-Bench-216/data/reference_reasoning_chains.jsonl \
  --model-input SecLog-Bench-216/data/evidence_windows.jsonl \
  --sample-index SecLog-Bench-216/data/sample_index.jsonl \
  --predictions ../seclog-runs/example/predictions.jsonl \
  --output-dir ../seclog-runs/example/evaluation
परिणामों में शामिल हैं:
| आउटपुट | सामग्री |
|---|---|
predictions.jsonl | सामान्यीकृत मॉडल पूर्वानुमान |
invalid_outputs.jsonl | वे प्रतिक्रियाएँ जिन्हें सफलतापूर्वक सामान्यीकृत नहीं किया जा सका |
evaluation/metrics_summary.json | समग्र मूल्यांकन मेट्रिक्स |
evaluation/per_sample_results.jsonl | प्रति-नमूना परिणाम |
evaluation/confusion_matrix.csv | चरण-पूर्वानुमान कन्फ्यूज़न मैट्रिक्स |
evaluation/per_stage_metrics.csv | चरण के अनुसार मेट्रिक्स |
evaluation/error_cases.jsonl | त्रुटि विश्लेषण के लिए रखे गए मामले |
इस मूल्यांकनकर्ता में संदर्भ/साक्ष्य ओवरलैप नैदानिक है। औपचारिक तर्क-गुणवत्ता स्कोरिंग के लिए Post-hoc reasoning quality में अतिरिक्त चेकलिस्ट और सहायक समीक्षा वर्कफ़्लो की आवश्यकता होती है।
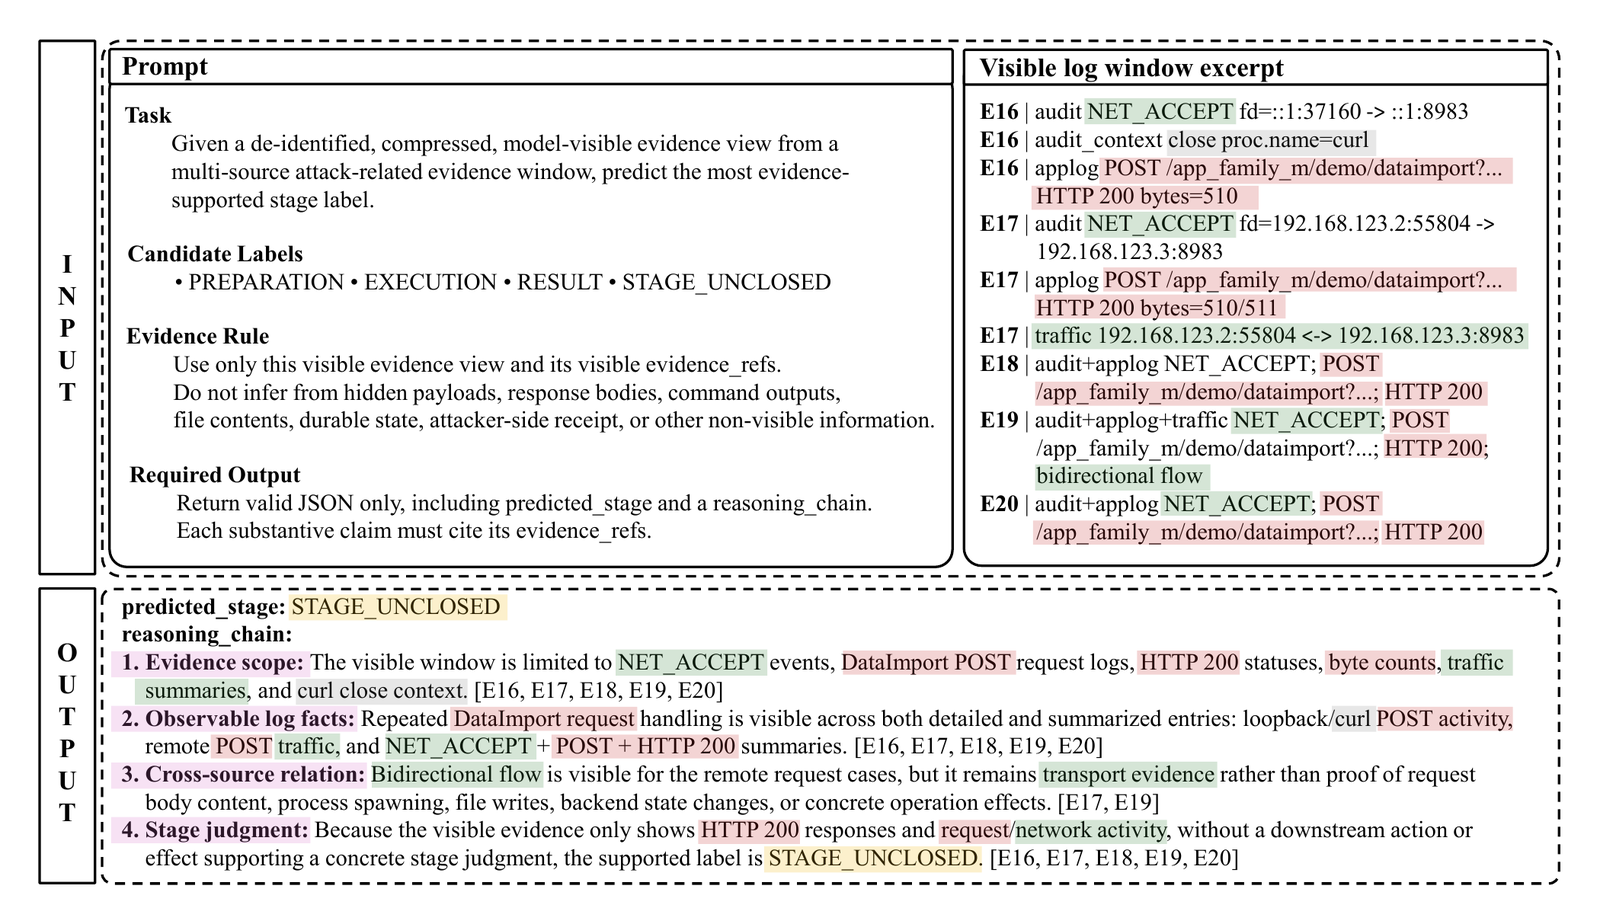
चित्र 2. उदाहरण। जारी की गई फ़ाइलों में, चरण लेबल लोअरकेस में हैं (उदाहरण के लिए, stage_unclosed) और साक्ष्य संदर्भ नमूना-स्थानीय edge_id मानों का उपयोग करते हैं।






