
 seclog-open/seclog
Collecte des journaux de sécurité multi-sources à partir de scénarios d'attaque Docker reproductibles, construit des chaînes d'attaque et fournit le benchmark SecLog-Bench-216 pour évaluer le raisonnement des LLM sur les étapes d'attaque.

SecLog prend en charge la recherche sur le raisonnement par étapes d'attaque à partir de journaux de sécurité multi-sources. Il fournit des outils pour collecter des journaux à partir de scénarios reproductibles d'attaques et d'activités normales sous Docker, organiser les preuves en chaînes d'attaque, construire des jeux de données étiquetés et évaluer les prédictions des modèles.
La version inclut SecLog-Bench-216, un benchmark prêt à l'emploi de 216 fenêtres de preuves avec des étiquettes d'étapes révisées et des chaînes de raisonnement de référence. Les chercheurs peuvent utiliser directement le benchmark fourni ou exécuter le pipeline de construction pour produire de nouvelles données.
Article : SecLog-Bench: A Scalable Benchmark for Cybersecurity Log Reasoning with Scaffolded Evidence.
Ressources de construction sur Zenodo : images Docker, journaux bruts et indices d'alignement, et chaînes d'attaque construites.
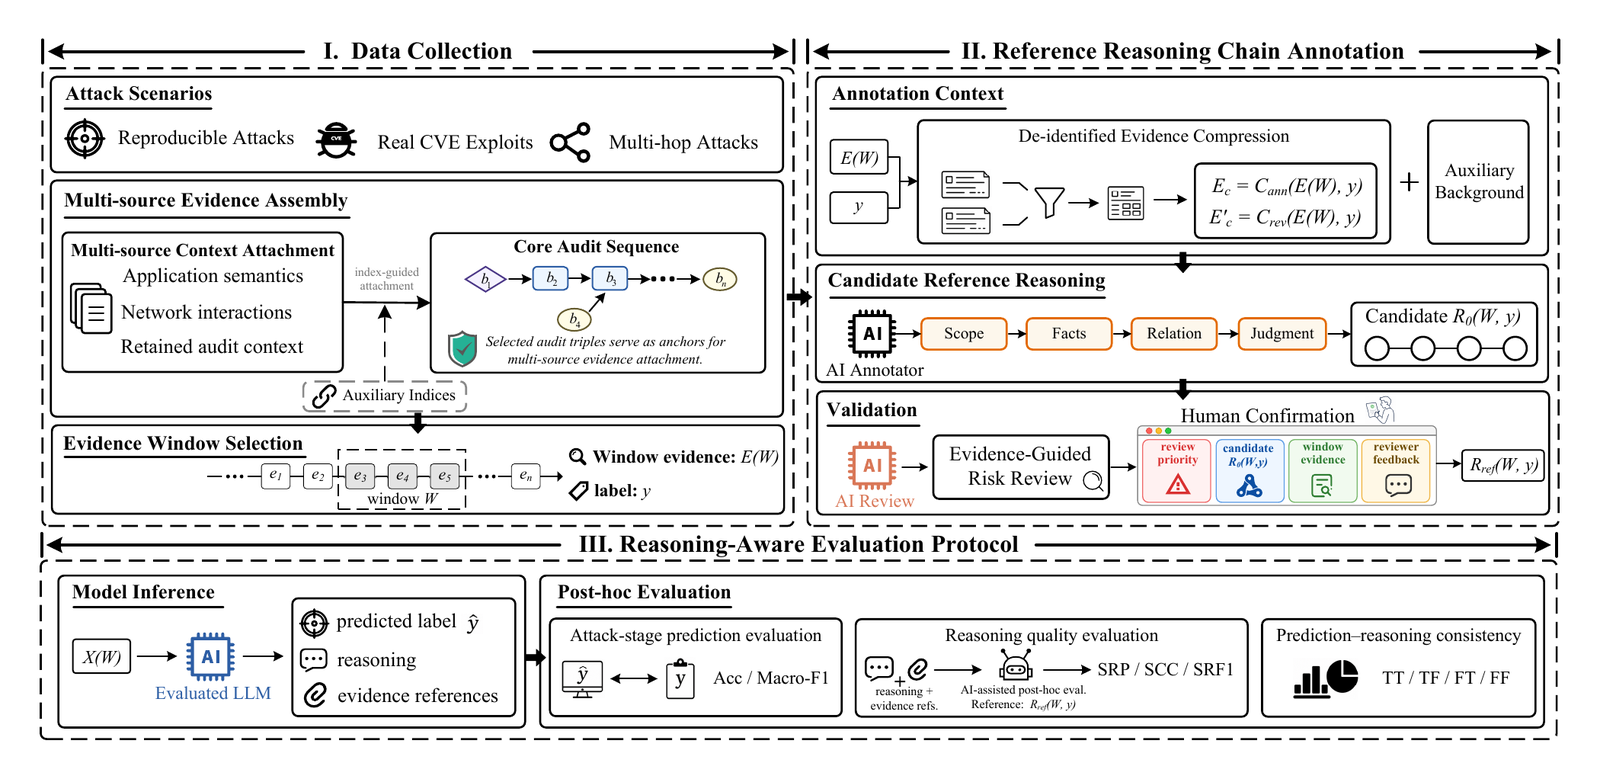
Figure 1. Vue d'ensemble de SecLog. La partie I correspond aux étapes 01–04, la partie II au flux de travail d'annotation et de révision en 05, et la partie III au flux de travail d'évaluation en 05 avec SecLog-Bench-216.
| Votre objectif | Commencez ici | Environnement |
|---|---|---|
| Lire ou réutiliser le jeu de données fourni | SecLog-Bench-216 et exemples de données | N'importe quel lecteur JSONL ; Python 3.11 pour le validateur |
| Évaluer un modèle sur le benchmark fourni | Démarrage rapide | Python 3.11 ; un point de terminaison API et une clé pour le lanceur d'inférence fourni |
| Collecter de nouveaux journaux et construire un jeu de données ou un benchmark | Construction des données | Ubuntu Linux, Python 3.11, Poetry, Docker et outils de capture |
Les paquets système détaillés, les composants optionnels et les versions des dépendances sont listés dans ENVIRONMENT_DEPENDENCIES.md.
Ces commandes utilisent Bash et s'exécutent depuis la racine du projet. Commencez par un environnement Python 3.11 isolé :
python3.11 -m venv ../seclog-env
source ../seclog-env/bin/activate
Les commandes ci-dessous utilisent la bibliothèque standard Python. Pour la collecte de journaux, l'annotation, l'interface de révision et l'analyse complémentaire, consultez le guide d'environnement.
python 05_benchmark_annotation_review_evaluation/scripts/validate_public_benchmark.py
Le validateur vérifie les nombres d'échantillons, les ID, la distribution des étiquettes, les références de preuves et les hachages du manifeste. Une validation réussie indique validation_passed: true et sample_count: 216 dans sa sortie JSON.
Remplacez your-model-name par l'identifiant de modèle pris en charge par votre fournisseur :
python 05_benchmark_annotation_review_evaluation/evaluation/run_benchmark_inference.py \
  --prompt-pack SecLog-Bench-216/data/prompt_pack.jsonl \
  --model your-model-name \
  --output ../seclog-runs/example/raw_responses.jsonl
Cette commande indique mode: preflight_no_api et le nombre d'invites. Elle
ne contacte pas le fournisseur, ne crée pas de fichier de réponse et ne
vérifie pas que le fournisseur prend en charge le modèle sélectionné.
Définissez OPENAI_API_KEY dans l'environnement de votre shell, en remplaçant
l'espace réservé ci-dessous par la clé de votre fournisseur, puis activez
explicitement les appels API :
export OPENAI_API_KEY="YOUR_API_KEY"
python 05_benchmark_annotation_review_evaluation/evaluation/run_benchmark_inference.py \
  --prompt-pack SecLog-Bench-216/data/prompt_pack.jsonl \
  --model your-model-name \
  --output ../seclog-runs/example/raw_responses.jsonl \
  --call-api
Le runner utilise un point de terminaison de chat compatible OpenAI. Son URL de base par défaut est
https://api.openai.com/v1 ; passez --base-url pour un autre point de terminaison et
--api-key-env pour un autre nom de variable de clé. Conservez le répertoire de sortie
en dehors de l'arborescence de la release, comme dans cet exemple. Utilisez un nouveau chemin de sortie pour chaque
exécution, ou ajoutez --resume pour poursuivre un fichier de réponses existant.
Pour utiliser votre propre système d'inférence, y compris des modèles qui rejettent temperature,
max_tokens ou le mode JSON, utilisez SecLog-Bench-216/data/prompt_pack.jsonl et le
format de prédiction, puis passez
les sorties brutes au normaliseur ci-dessous.
python 05_benchmark_annotation_review_evaluation/evaluation/normalize_stage_reasoning_predictions.py \
  --input ../seclog-runs/example/raw_responses.jsonl \
  --output ../seclog-runs/example/predictions.jsonl

python 05_benchmark_annotation_review_evaluation/evaluation/evaluate_stage_reasoning_predictions.py \
  --gold SecLog-Bench-216/data/gold_labels.jsonl \
  --reference-chains SecLog-Bench-216/data/reference_reasoning_chains.jsonl \
  --model-input SecLog-Bench-216/data/evidence_windows.jsonl \
  --sample-index SecLog-Bench-216/data/sample_index.jsonl \
  --predictions ../seclog-runs/example/predictions.jsonl \
  --output-dir ../seclog-runs/example/evaluation
Les résultats comprennent :
| Sortie | Contenu |
|---|---|
predictions.jsonl | Prédictions du modèle normalisées |
invalid_outputs.jsonl | Réponses qui n'ont pas pu être normalisées avec succès |
evaluation/metrics_summary.json | Métriques d'évaluation agrégées |
evaluation/per_sample_results.jsonl | Résultats par échantillon |
evaluation/confusion_matrix.csv | Matrice de confusion des prédictions de stage |
evaluation/per_stage_metrics.csv | Métriques par stage |
evaluation/error_cases.jsonl | Cas conservés pour l'analyse des erreurs |
