 iqsec-lab/freemoca
Cadre d'apprentissage continu sans mémoire pour la classification des malwares utilisant une interpolation basée sur la connectivité de mode. Prend en charge les scénarios incrémentaux par classe et par domaine sur les ensembles de données EMBER et Androzoo.

[!NOTE] Ceci est l'implémentation officielle de l'article Continual Learning Trajectory as Memory for Replay-Free Consolidation in Malicious Code Analysis.
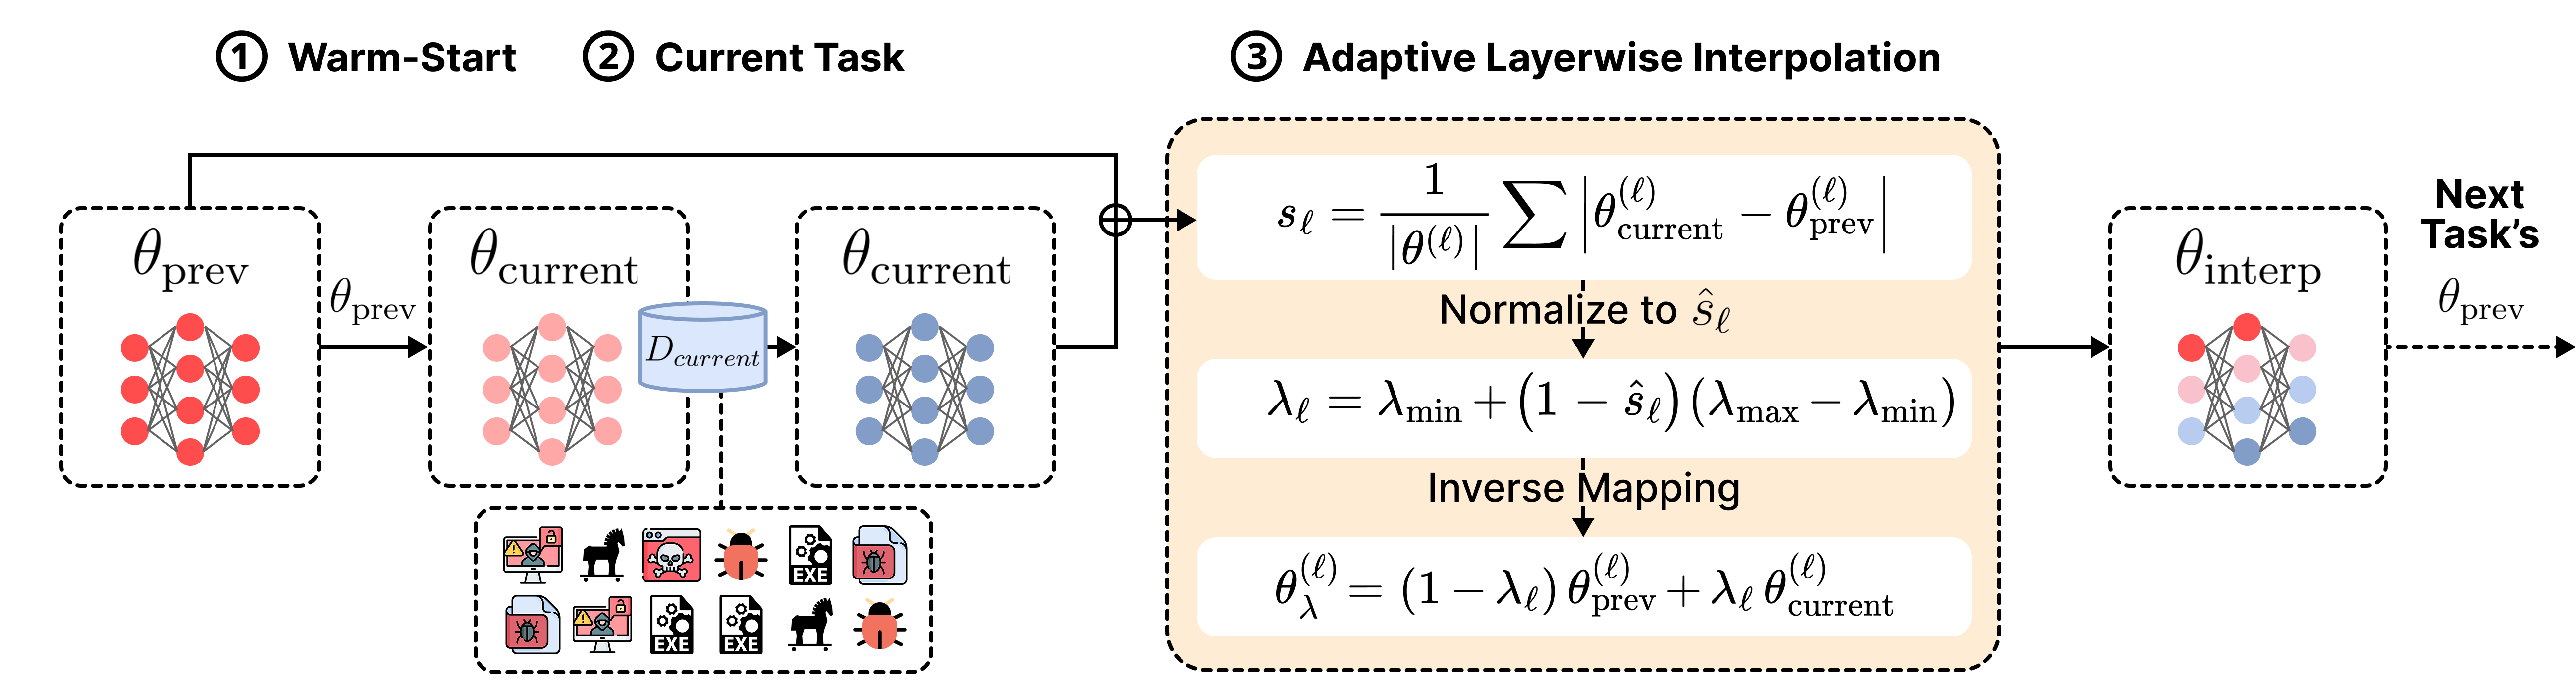
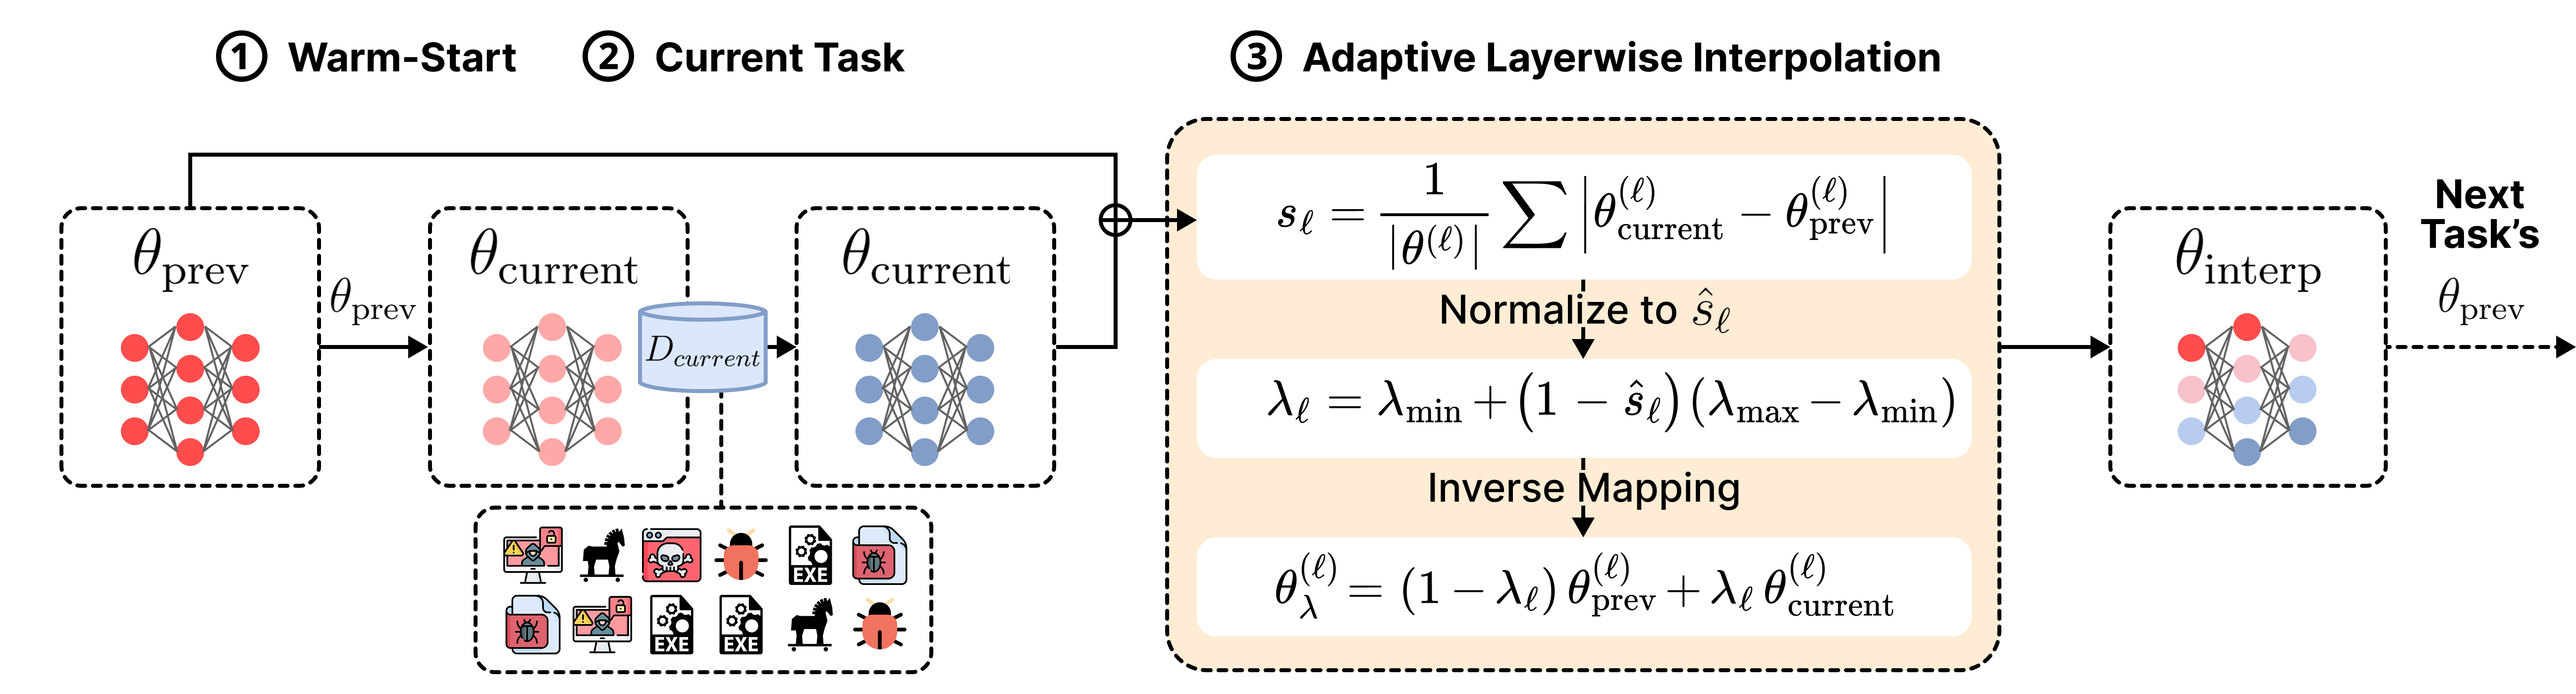
FreeMOCA fonctionne selon le processus suivant :
L'ensemble du processus construit une chaîne de solutions connectées situées sur une variété à faible perte, réduisant significativement l'oubli catastrophique.
FreeMOCA a été évalué avec deux jeux de données de malwares à grande échelle, EMBER et Androzoo. Sources des jeux de données :
Téléchargez et configurez le jeu de données dans le répertoire suivant :
FreeMOCA/data/
├── AZ_Class
│   ├── AZ_Class_Test.npz
│   └── AZ_Class_Train.npz
│
├── AZ_Domain
│   ├── 2008_Domain_AZ_Test_Transfo...
│   ├── 2008_Domain_AZ_Train_Transfo...
│   ├── 2009_Domain_AZ_Test_Transfo...
│   └── ...
│
├── EMBER_Class
│   ├── XY_test.npz
│   └── XY_train.npz
│
└── EMBER_Domain
    ├── 2018-01
    ├── 2018-02
    ├── 2018-03
    └── ...
Ce dépôt prend en charge deux scénarios d'apprentissage continu :
Exécutez la commande suivante pour le
conda create -n freemoca python=3.9
conda activate freemoca
pip install -r requirements.txt
# EMBER Class-IL
cd ./FreeMOCA_Class/EMBER_Class
CUDA_VISIBLE_DEVICES=0 python main.py --train_data /path/to/data --test_data /path/to/data
# AZ Class-IL
cd ./FreeMOCA_Class/AZ_Class
CUDA_VISIBLE_DEVICES=0 python main.py --train_data /path/to/data --test_data /path/to/data
# EMBER Domain-IL
cd ./FreeMOCA_Domain/EMBER_Domain
CUDA_VISIBLE_DEVICES=0 python main.py --data_root /path/to/data/directory
# AZ Domain-IL
cd ./FreeMOCA_Domain/AZ_Domain
CUDA_VISIBLE_DEVICES=0 python main.py --data_root /path/to/data/directory
Pour une configuration plus détaillée des hyperparamètres, consultez l'Annexe A. Arguments courants pour FreeMOCA.
Pour ajuster les hyperparamètres ou les paramètres expérimentaux, utilisez les arguments suivants :
| Argument | Description |
|---|---|
--init_classes | Nombre de classes à la tâche 0 |
--epochs | Époques par tâche |
--batchsize | Taille du lot |
--lr | Taux d'apprentissage |
--momentum | Momentum SGD |
--weight_decay | Décroissance du poids |
--lambda_min | Poids d'interpolation minimal |
--lambda_max | Poids d'interpolation maximal |
Pour modifier la configuration par défaut des arguments, consultez le fichier arguments.py.
Notre dépôt prend en charge des expériences sur les références de base standard suivantes :
Vous pouvez l'exécuter avec la commande suivante :
cd /path/to/experiment/directory
CUDA_VISIBLE_DEVICES=0 python none.py --arugment_you_want
CUDA_VISIBLE_DEVICES=0 python joint.py --arugment_you_want
et les travaux précédents suivants :
Vous pouvez exécuter les références de base avec la commande suivante :
# CLeWI for EMBER-Class
cd ./baselines/CLeWI
CUDA_VISIBLE_DEVICES=6 python main.py --model="clewi" \
  --dataset="seq_ember" --n_tasks=11 \
  --lr=0.001 --buffer_size=500 --n_epochs=50 \
  --seed=42 --optim_wd=0.0 --optim_mom=0.0 \
  --batch_size=512 --sub_dataset="ember"

# CLeWI for AZ-Class
cd ./baselines/CLeWI
CUDA_VISIBLE_DEVICES=6 python main.py --model="clewi" \
  --dataset="seq_ember" --n_tasks=11 \
  --lr=0.001 --buffer_size=500 --n_epochs=50 \
  --seed=42 --optim_wd=0.0 --optim_mom=0.0 \
  --batch_size=512 --sub_dataset="az"
# WSC for EMBER-Class
cd ./baselines/WSC
MODEL_NAME=wsc_20_ember
python main.py --config=./exps/wsc_memory/$MODEL_NAME.json
# WSC for AZ-Class
cd ./baselines/WSC
MODEL_NAME=wsc_20_az
python main.py --config=./exps/wsc_memory/$MODEL_NAME.json
# GR for EMBER-Class
cd ./baselines/GR_EWC_LwF_iCaRL_EMBER
CUDA_VISIBLE_DEVICES=0 python main.py --data_set=EMBER --tasks=11 --replay=generative --metrics --logger_file gr --scenario=class

# GR for AZ-Class
cd ./baselines/GR_EWC_LwF_iCaRL_AZ
CUDA_VISIBLE_DEVICES=0 python main.py --data_set=ANDROZOO --tasks=11 --replay=generative --metrics --logger_file gr --scenario=class
