Skip to content
KitploitKITPLOIT
HerramientasExploitsBlog
Log in
Enviar
HerramientasExploitsBlog
Enviar

¡Herramientas de Hacking, PenTest y Ciberseguridad para tu Arsenal de Seguridad!

Kitploit es un directorio de herramientas de hacking, ciberseguridad y pentesting. Descubre las últimas actualizaciones de proyectos para encontrar vulnerabilidades, analizar sistemas, automatizar pruebas y fortalecer tu seguridad.

FeedsContactoPrivacidad© 2026 Kitploit

Directorio de Herramientas

Categorías

Ver todas las categorías
Loading categories
modelaudit — Escáner de seguridad para archivos de modelos de IA/ML. Detecta código malicioso, puertas traseras y vulnerabilidades antes del despliegue | Kitploit
Herramientas/GitHubGitHub/promptfoo/modelaudit
Análisis EstáticoAnálisis Estático de Código (SAST)Análisis de VulnerabilidadesExfiltración de DatosAnálisis de MalwareDevSecOpsDetección de SecretosSeguridad de Cadena de SuministroAprendizaje AutomáticoSeguridad de IAAtaque Adversario
832381hace 3 díasRevisado por Kitploit
Top en Ataque Adversario #14
Top en Seguridad de IA #14
Top en Aprendizaje Automático #9
GitHubpromptfoo/modelaudit

modelaudit

Escáner de seguridad para archivos de modelos de IA/ML. Detecta código malicioso, puertas traseras y vulnerabilidades antes del despliegue

Ver RepositorioSitio web

Más Populares

Ver todos →

Descubre las herramientas más usadas por nuestra comunidad.

Explora todas las herramientas

Explora nuestra colección de herramientas

Ver todas las herramientas →
Compartir

ModelAudit

Asegure sus modelos de IA antes del despliegue. Escáner estático que detecta código malicioso, posibles indicadores de puertas traseras y vulnerabilidades de seguridad en archivos de modelos de ML — sin cargarlos ni ejecutarlos nunca.
PyPI version Python versions Code Style: ruff License Security policy

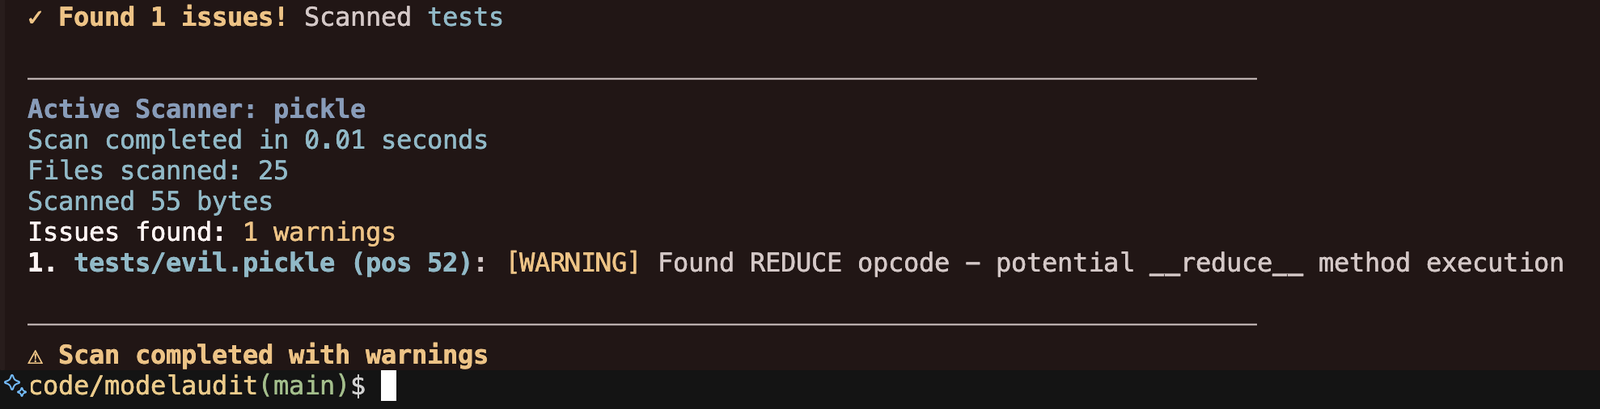
ModelAudit scan results

Documentación completa | Ejemplos de uso | Formatos compatibles

Por qué ModelAudit

Los modelos se descargan de registros no confiables, pasan por CI y terminan ejecutándose en producción. Las herramientas SAST tradicionales no examinan los opcodes de pickle, los diseños de grupos HDF5, los grafos proto de ONNX ni las firmas de TensorFlow SavedModel — ModelAudit sí:

  • Escaneo estático. Ningún modelo se carga, deserializa (unpickle) ni ejecuta jamás.
  • Cubre los formatos que realmente distribuye. Más de 40 escáneres que abarcan pickle, PyTorch, SafeTensors, ONNX, TensorFlow, Keras, GGUF, archivos comprimidos y configuraciones.
  • Se integra en CI. Salida legible por máquina (JSON, SARIF), modo estricto, códigos de salida y escáneres seleccionables.
  • Expone los límites de cobertura. Los escáneres reconocidos informan brechas de análisis acotado, como lecturas truncadas o presupuestos agotados, en lugar de presentarlas como resultados con cobertura total.

Herramientas comparables: picklescan (solo pickle, basado en Python), fickling (solo pickle, basado en AST), modelscan (subconjunto de pickle + TensorFlow + Keras). ModelAudit tiene una cobertura más amplia e incluye un motor pickle nativo en Rust mediante su paquete complementario modelaudit-picklescan.

Inicio rápido

Requiere Python 3.10-3.14

pip install "modelaudit[all]"

# Scan a file or directory
modelaudit model.pkl
modelaudit ./models/

# Export results for CI/CD
modelaudit model.pkl --format json --output results.json
$ modelaudit suspicious_model.pkl

Files scanned: 1 | Issues found: 2 critical, 1 warning

1. suspicious_model.pkl (pos 28): [CRITICAL] Malicious code execution attempt
   Why: Contains os.system() call that could run arbitrary commands

2. suspicious_model.pkl (pos 52): [WARNING] Dangerous pickle deserialization
   Why: Could execute code when the model loads

La evidencia del escaneo y los errores de origen pueden incluir valores de credenciales originales, incluso en JSON, SARIF, SBOM e informes compartidos. La normalización de credenciales se mantiene donde afecta a la detección, agrupación o supresión.

Qué detecta

  • Ataques de ejecución de código en archivos Pickle, PyTorch, NumPy y Joblib
  • Posibles indicadores de puerta trasera — patrones de pesos sospechosos, tensores anómalos o señales de código oculto
  • Secretos incrustados — claves de API, tokens y credenciales en los pesos del modelo o en los metadatos
  • Indicadores de red — URL, IP y uso de sockets que podrían permitir la exfiltración de datos
  • Exploits en archivos comprimidos — path traversal, ataques de enlaces simbólicos en archivos ZIP/TAR/7z
  • Operaciones ML inseguras — capas Lambda, ops personalizadas, TorchScript/JIT, inyección de plantillas
  • Riesgos de cadena de suministro — manipulación, violaciones de licencia, configuraciones sospechosas

Formatos compatibles

ModelAudit incluye 45 escáneres registrados que cubren formatos de modelos, archivos comprimidos y configuraciones:


Descargar herramienta