amruth-sn/kong
El primer agente de ingeniería inversa del mundo.

Orquestación de LLM para ingeniería inversa de binarios
La mayoría de las tareas siguen una relación lineal: cuanto más difícil es la tarea, más tiempo suele llevar. La ingeniería inversa (y el análisis de binarios) es una tarea en la que la dificultad real es algo trivial, pero el tiempo de ejecución puede ser del orden de horas (¡y días!), incluso para un binario con un par de cientos de funciones.
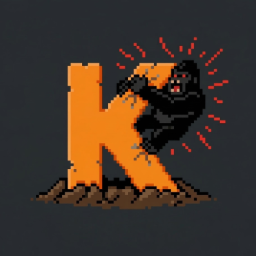
Kong automatiza la capa mecánica, utilizando un marco de ingeniería inversa de nivel NSA. Kong puede tomar un binario completamente ofuscado y sin símbolos y ejecutar un pipeline de análisis completo: clasificar funciones, construir contexto de grafo de llamadas, recuperar tipos y símbolos mediante descompilación guiada por LLM, y escribir los resultados de vuelta en la base de datos del programa de Ghidra. El resultado es un binario donde alguna FUN_00401a30 ahora es parse_http_header, con estructuras, nombres de parámetros y convenciones de llamada recuperados.
Por qué existe
Los binarios sin símbolos pierden todo el contexto que hace legible el código: nombres de funciones, información de tipos, nombres de variables, diseños de estructuras. Recuperar ese contexto es la mayor parte del trabajo en la mayoría de las tareas de RE, y es en gran medida coincidencia de patrones: reconocer funciones de la biblioteca estándar, inferir tipos a partir del uso, propagar nombres a través de los grafos de llamadas.
Los LLM son buenos exactamente en este tipo de coincidencia de patrones. Pero apuntar un LLM a la salida cruda del descompilador y preguntar "¿qué hace esto?" da resultados mediocres. Al modelo le falta contexto de llamadas, información de referencias cruzadas y la imagen más amplia de cómo está estructurado el binario. Además, la mayoría de los binarios ofuscados introducen técnicas extremas para prevenir la ingeniería inversa.
Kong resuelve esto creando ventanas de contexto enriquecidas a partir del análisis del programa de Ghidra (grafos de llamadas, referencias cruzadas, referencias a cadenas, flujo de datos) antes de tocar siquiera el LLM, luego orquesta el análisis en orden de dependencia para que cada función se beneficie de que sus llamadas ya estén nombradas. Adicionalmente, Kong introduce su propio pipeline de desofuscación autónomo, el primero de su tipo.
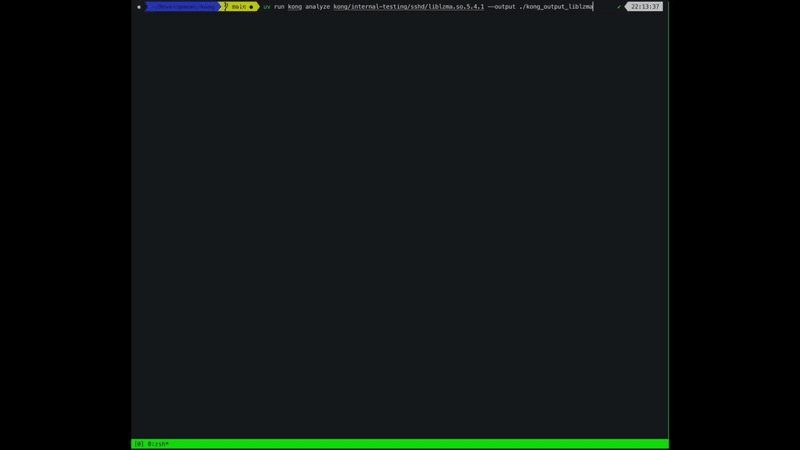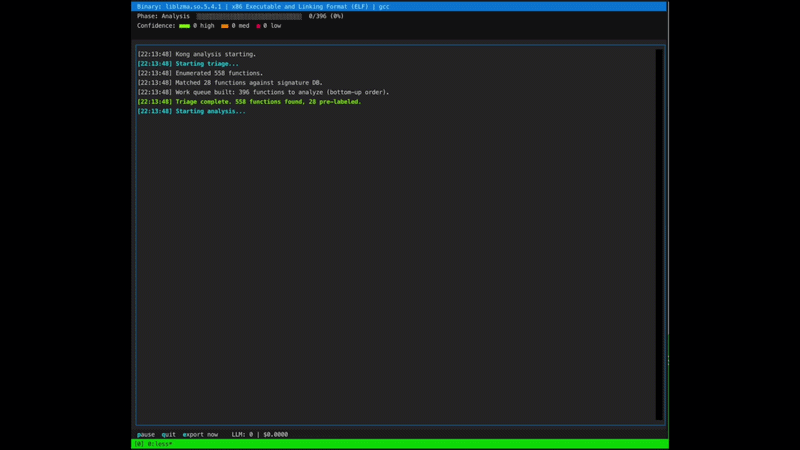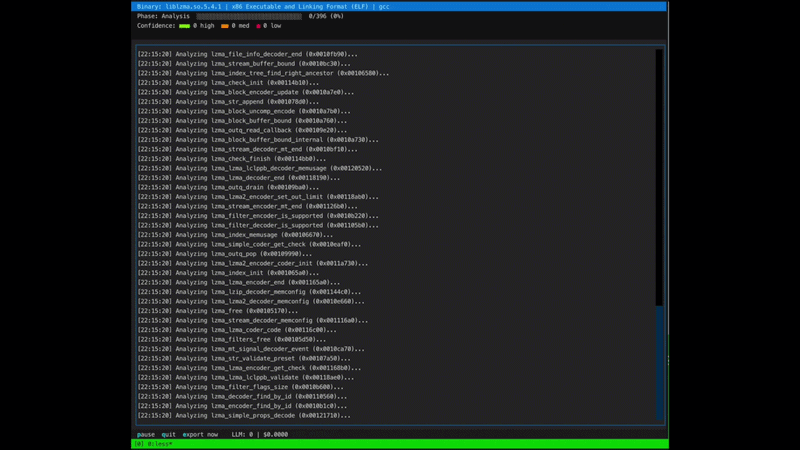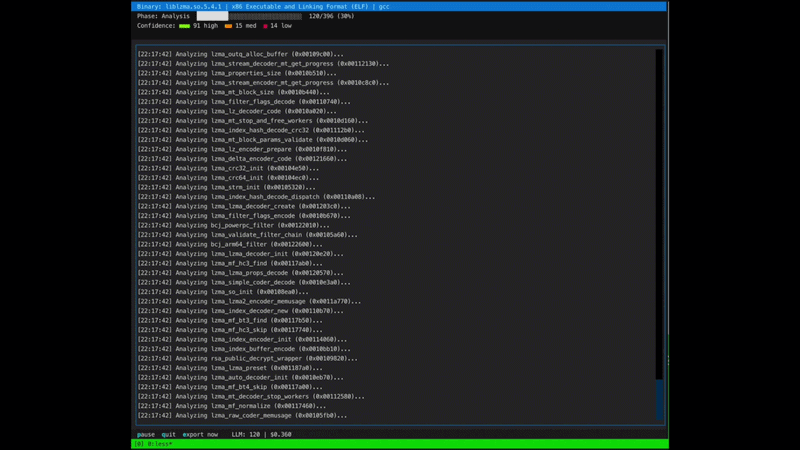
Kong funciona con la mayoría de los binarios descompilables por Ghidra (por ahora, más por venir).
| C | C++ | Go | Rust | |
|---|---|---|---|---|
| x86 | Alta | Alta | Media | Media |
| x86-64 | Alta | Alta | Media | Media |
| ARM (32-bit) | Alta | Alta | Media | Baja |
| AArch64 | Alta | Alta | Media | Baja |
| MIPS | Media | Media | Baja | Baja |
| PowerPC | Media | Media | Baja | Baja |
Alta: Kong descompila, desofusca y recupera nombres, tipos y estructura de manera confiable.
Media: La descompilación es utilizable pero más ruidosa. Se espera recuperación parcial y puntuaciones de confianza más bajas.
Baja: La descompilación tiene lagunas significativas y los resultados permanecerán incompletos, ruidosos o ilegibles.
Nota: El tamaño del binario escala positivamente con el recuento de funciones, el costo de LLM y el tiempo de finalización. Sin embargo, el tamaño del binario también escala negativamente con la confianza, así que tenga esto en cuenta al analizar binarios más grandes.
Kong utiliza un pipeline de cinco fases orquestado por un supervisor que coordina la clasificación, el análisis paralelo y el postprocesamiento: