
 #1
Herramientas de seguridad basadas en ML, aprendizaje automático adversario y defensa cibernética con IA.
Recomendado por Kitploit

 zju-llm-safety/ascent
Marco de ajuste fino que aplica calibración de seguridad óptima de primer orden y recalibración periódica a los LLM, preservando actualizaciones…
 tz98lab/dlr-ne-ics-security
Código de investigación que implementa el cálculo de Equilibrio de Nash Dinámico de Bajo Rango para juegos de seguridad ICS estocásticos entre…
 abhinavdubey30/perturbed-embedding-vectors
Código, registros de respuesta y etiquetas para el artículo Jailbreaking Open-Weight LLMs via Random Embedding Perturbations
 arxhr007/aliens_eye
Hunt down 840+ social media accounts using AI
 jisung-pacific/hdi-graphrag-attack
Implementación de investigación de Hop-Decayed Influence (HDI) y el marco de ataque 3S, que expone vulnerabilidades estructurales de indexación…
 lzwhehe/benign-instruction-bench
Re-evaluating prompt-injection detectors on LLM agent tool outputs (paper draft, scripts, scores)
 hoodoer/colonelclustered
Un plugin de Burp en Java que realiza agrupamiento de texto en las respuestas para identificar valores atípicos/grupos basándose en el contenido real…
 rbidou/pyrasp
Runtime Application Self Protection for Python web servers, serverless functions and MCP servers, detecting attacks, prompt injection and data leaks…
 euph00/zoneclaw-code
Código de benchmark y defensa para ataques de memoria persistente en agentes de uso informático estilo OpenClaw, con mitigación de zonificación de…
 sliu11-byte/mea-bench
Un benchmark del ciclo de vida para ataques de extracción de LLM de caja negra, defensas y ataques adaptativos.
 js-lee-ai/refusal-relocates
Refusal localizes, the damage relocates, safety layers under few-sample fine-tuning
 liuz233/harde
Código de investigación para HARDE, un arnés de agentes que sondea y optimiza de forma adaptativa componentes para la detección de riesgos en tiempo…
 kevinchunye/prompt_injection
Arnés de benchmark que mide dónde se activan las defensas contra la inyección de prompts en pipelines de agentes LLM que usan herramientas,…
 joshuaprovoste/deserializer
Analizador de código estático basado en AST con mapeo de relaciones impulsado por LLM agéntico para descubrir rutas de RCE en Python y cadenas…
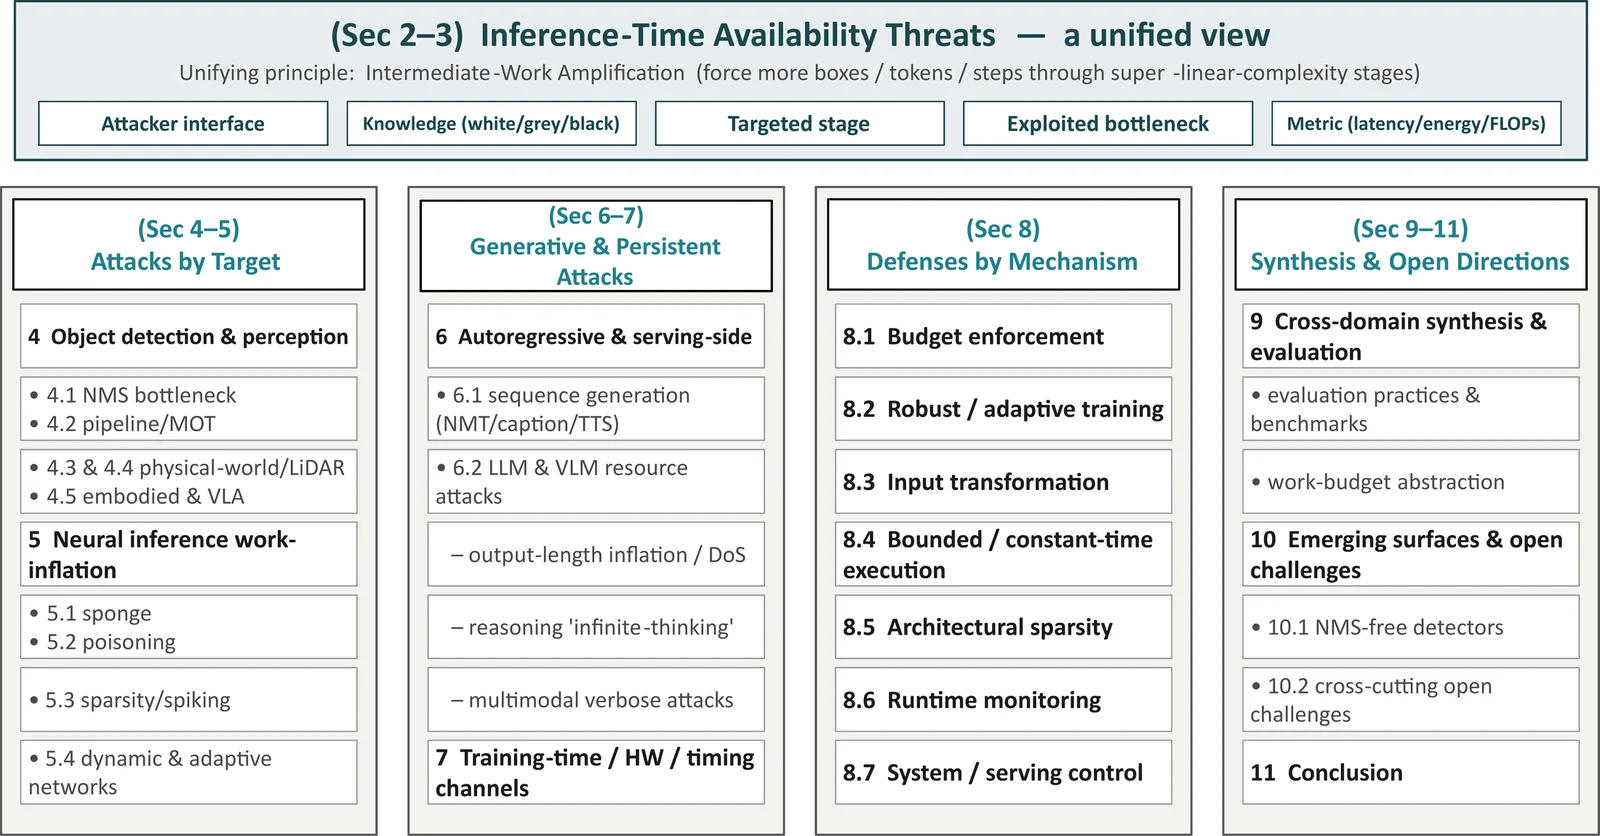 guzonghua/awesome-latency-attacks
Índice curado de ataques y defensas de latencia, latencia-energía y temporización (disponibilidad) en aprendizaje profundo — complemento del envío a…
 facebookresearch/meta_secalign
LLMs de pesos abiertos y código de entrenamiento/evaluación para defenderse contra ataques de inyección de prompts, con benchmarks para la seguridad…
 kaill-jlq/mmskillrisk
Banco de pruebas y arnés de evaluación que comprueba si los agentes LLM resisten instrucciones maliciosas ocultas en imágenes de habilidades…
 zju-llm-safety/trace
Agentic jailbreak framework for LLM-based agents using scheme-based task decomposition, multi-turn disguising strategies, and adaptive self-evolution…








